اگر امروز برای استقرار مدلهای هوش مصنوعی در خط تولید (Production) برنامهریزی میکنید، باید بدانید که معیار «باهوش بودن» مدلها تغییر کرده است. دیگر داشتن نمره کامل در آزمونهای ریاضی کافی نیست؛ آنچه اکنون تعیینکننده است، توانایی مدل در رعایت دقیق فرمتهای خروجی و استخراج بینقص دادهها از اسناد پیچیده است.
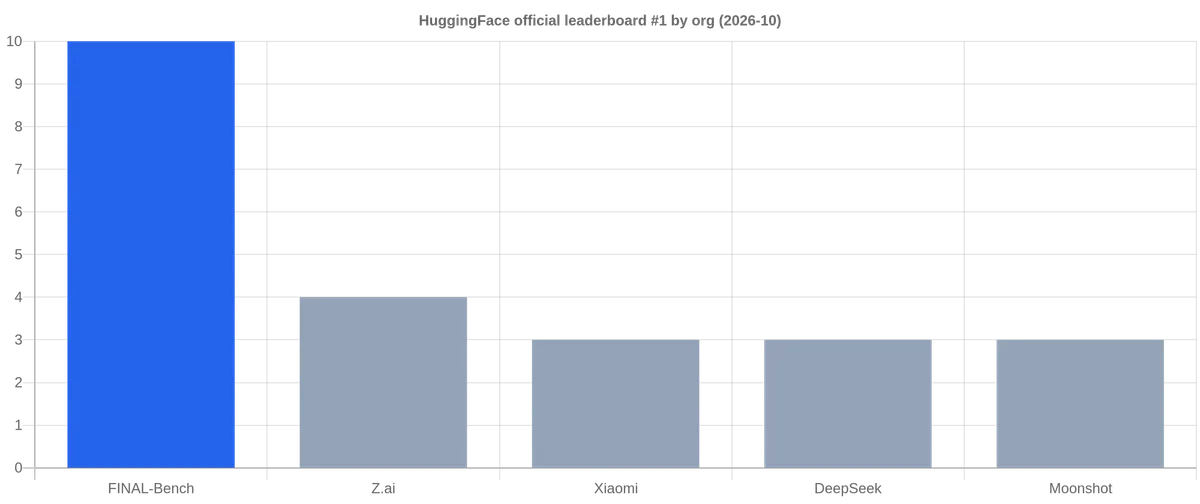
در حالی که ۹۵ سازمان مختلف در ۴۸ بنچمارک رسمی در جدولهای رسمی Hugging Face با یکدیگر رقابت میکنند، سازمان BeDraft با شتابی خیرهکننده از بقیه پیشی گرفته است. طبق گزارشهای منتشر شده تا ۶ اکتبر ۲۰۲۶، BeDraft با تصاحب رتبه اول در ۱۰ دستهبندی مختلف، از رقبایی چون ZhipuAI که تنها ۴ رتبه اول در اختیار دارد، جلو زده است. این تغییر وضعیت سیگنالی است مبنی بر اینکه شکاف میان هوش مصنوعی که صرفاً در آزمونها میدرخشد و هوش مصنوعی که قادر به انجام کارهای حرفهای است، در حال بسته شدن است.
سالها بود که صنعت بر روی محکهای آکادمیک در علوم، ریاضی و حقوق متمرکز بود. هرچند این آزمونها هوش خام یک مدل را اثبات میکنند، اما بهندرت پیشبینی میکنند که یک مدل چگونه با یک فایل PDF نامنظم سازمانی یا یک طرحواره (Schema) سختگیرانه JSON برخورد میکند. BeDraft در جهش اخیر خود، دقیقاً نقاط شکست «عملیاتی» را هدف قرار داده است تا از فاز «امتحانی» به فاز «کاربرد در دنیای واقعی» منتقل شود. همانطور که در تحلیلهای پیشین ما درباره امنیت مدلهای بازمتن اشاره کردیم، پایداری در خروجی، کلید تبدیل یک مدل آزمایشگاهی به یک ابزار تجاری است. این تمرکز بر کاربرد عملی، در واقع پاسخی به چالشهای مدیریت پروژه است؛ چرا که هماهنگ کردن سرعت توسعه با انتظارات مشتری تنها زمانی ممکن است که خروجیهای مدل در محیط تولیدی قابل پیشبینی و پایدار باشند.
چرخش به سمت پایداری سازمانی
به نقل از مستندات جدید، پیروزیهای اخیر BeDraft در دو محک طراحی شده برای محیطهای عملیاتی رخ داده است که به جای کلاسهای درس، برای محیطهای تولیدی ساخته شدهاند. نخستین مورد IFStruct است؛ محکی که توسط Liquid AI برای سنجش توانایی مدل در پیروی سختگیرانه از فرمتهای خروجی مانند JSON یا YAML ایجاد شده است.
در IFStruct، حتی یک خطای تککاراکتری یا اضافه کردن یک فیلد درخواستنشده، به معنای شکست کامل مدل است. معیارها بسیار صلب و سختگیرانه هستند: مدل باید دقیقاً به تعداد آیتمها، نام فیلدها، انواع دادهها، مقادیر مجاز و محدودههای عددی پایبند باشد. اگر هوش مصنوعی حتی یک مورد را اختراع کند که در دستور (Prompt) درخواست نشده باشد، آن پاسخ شکستخورده تلقی میشود. BeDraft با کسب امتیاز ۹۸.۹۵٪ و پاس کردن ۱۹۷۹ مورد از ۲۰۰۰ آیتم، رقبایی چون Agents-A1 (۹۳.۲۵٪)، مدل gpt-oss-20b از OpenAI (۹۱.۹۵٪) و Nemotron-3-Nano از NVIDIA (۸۶.۸۰٪) را به طور قابل توجهی شکست داد.
برای توسعهدهندگان، این پایداری حیاتی است. در یک خط لوله تولیدی که برنامهای خروجی AI را میخواند تا مرحله بعد را اجرا کند، یک خطای فرمتبندی کوچک کل گردش کار را متوقف میکند. برای کاربردی بودن، خروجی باید بلافاصله از اعتبارسنجی طرحواره عبور کند؛ برای مثال با استفاده از دستور jsonschema.validate(json.loads(out), schema) در حالی که مقدار additionalProperties روی False تنظیم شده باشد تا از توهم (Hallucination) مدل در ایجاد فیلدهای اضافی جلوگیری شود.
کالبدشکافی استخراج اسناد
دومین پیروزی در ExtractBench رخ داد که توسط LlamaIndex توسعه یافته است. این آزمون توانایی استخراج دقیق اطلاعات ضروری از ۳۷۰ سند PDF مختلف را میسنجد. این اسناد از نظر حجم بسیار متنوع هستند و طول آنها از چند صفحه تا ۱۹۰ صفحه متغیر است.
مدل Darwin-180B-RSI-R3 با امتیاز ۹۰.۲۹٪ در این بخش پیشتاز شد. این مدل در واقع یک تکرار تکاملیافته از فرآیند بهبود خودکار است و توانسته از مدل پایه خود، یعنی Qwen3.8-Flash-Next متعلق به Alibaba که پیش از این با امتیاز ۸۹.۸۸٪ در صدر بود، پیشی بگیرد.
سازوکار: بهبود خودکار در سطح مدل (RSI)
این پیشرفتها مدیون تکنیکی به نام «بهبود بازگشتی خودکار در سطح مدل» (Model-level Recursive Self-Improvement یا RSI) است. مدل Darwin-180B-RSI یک مدل با وزنهای باز (Open Weights) است که قابلیتهای مدل Qwen را از طریق یک حلقه سه مرحلهای خاص ارتقا میدهد:
- خود-حلکنندگی (Self-Solving): مدل مسائلی را که دارای پاسخهای قابل تایید (Verifiable) هستند، بهتنهایی حل میکند.
- فیلتر کردن (Filtering): مدل تنها پاسخهایی را انتخاب میکند که صحت آنها به طور قطعی تایید شده است.
- بازآموزی (Retraining): مدل دوباره با استفاده از همان مسیرهای موفق و تاییدشده آموزش میبیند.
این سازوکار باعث میشود مدل نیازی به پاسخهای نوشتهشده توسط انسان یا توضیحات انسانی نداشته باشد. چون مدل پاسخهای تاییدنشده را نادیده میگیرد، از تله رایج تقویت خطاهای خود (Self-reinforcing errors) جلوگیری میکند. طبق اعلام BeDraft، عادتهای استدلالی دقیقی که مدل هنگام حل این مسائل قابل تایید کسب کرده، بهطور طبیعی به وظایف استخراج اسناد و متون حقوقی منتقل شده است، حتی با وجود اینکه مدل بهطور خاص برای این دامنهها آموزش ندیده بود.
ZTC: اعتماد بدون توکن
فراتر از بنچمارکها، BeDraft در حال حل گلوگاه «تصمیمگیری» در عاملهای هوش مصنوعی (AI Agents) است. در حالی که عاملها شروع به ارسال ایمیل، پردازش پرداختها و اجرای کد به نمایندگی از انسانها کردهاند، توانایی فیلتر کردن اقدامات نادرست پیش از اجرا، به میدان نبرد اصلی تبدیل شده است.
بهطور سنتی، برای تایید صحت یک پاسخ، به یک مدل «منتقد» (Critic) نیاز است که یک پاسخ متنی برای سوال «آیا این پاسخ درست است؟» تولید کند. اما تکنولوژی ZTC (Zero-Token Confidence) این نیاز را حذف میکند. ZTC با خواندن وضعیت داخلی (Internal State) مدلی که پاسخ را تولید کرده است، احتمال صحت آن را محاسبه میکند. چون هیچ توکن اضافهای تولید نمیشود، این روش تقریباً ۱۰ برابر سریعتر از قضاوتهای API خارجی (JEV) است.
مقایسه عملکرد ZTC در برابر JEV:
- تأخیر (Latency): مدل ZTC برای هر تصمیم ۰.۰۶۱۵ ثانیه زمان میبرد، در حالی که JEV به ۰.۵۹۱ ثانیه نیاز دارد.
- توان عملیاتی (Throughput): در یک بازه ۳۰۰ ثانیهای، ZTC تعداد ۱۷۷ مورد را پردازش کرد، در حالی که JEV تنها ۱۳۵ مورد را پیش برد.
- صحت (AUC): مقدار AUC برای ZTC برابر با ۰.۷۲۸۹ است که از نظر آماری با JEV (۰.۷۳۵۰) برابری میکند.
- رویارویی مستقیم: در یک نبرد ۲۰۰۰ راندی، ZTC در ۷۳.۷٪ موارد پیروز شد.
از آنجا که ZTC روی GPU محلی و در کنار مدل اجرا میشود، نیازی به درخواستهای API خارجی و رفتوبرگشت دادهها ندارد. این ویژگی آن را برای محیطهای ایزوله (Air-gapped) در بخشهای دفاعی، مالی و دولتی که حریم خصوصی دادهها در آنها اجباری است، ایدهآل میکند. علاوه بر این، ZTC تقریباً هیچ هزینهای اضافه نمیکند زیرا فقط وضعیت داخلی مدل موجود را میخواند. با استفاده از این روش، مدل Darwin-397B-ZTC دقت قضاوت خود درباره صحت پاسخها را از ۰.۷۶ به ۰.۸۸ رساند.
چشمانداز کلی جدول ردهبندی
سلطه BeDraft هم در حوزههای آکادمیک و هم در کاربردهای عملی گسترده است. در حال حاضر این سازمان در صدر رتبههای تراز اول قرار دارد و پس از آن ZhipuAI (۴ رتبه)، Xiaomi (۳ رتبه)، DeepSeek (۳ رتبه) و Moonshot AI (۳ رتبه) قرار دارند. رتبههای اول BeDraft شامل موارد زیر است:
- علم و دانش: GPQA Diamond (۹۴.۴۴٪) و MMLU-Pro (۸۸.۱۲٪).
- ریاضیات: AIME 2026 (۱۰۰٪) و HMMT 2026 (۱۰۰٪).
- حقوق: LEXam (۶۸.۹۴٪) و LEXam-hard (۴۵.۷۲٪).
- سازمانی/عملیاتی: ExtractBench (۹۰.۲۹٪) و IFStruct (۹۸.۹۵٪).
- استدلال بصری/تجزیه: MMMU-Pro (۷۹.۴۸٪) و MDPBench (۸۳.۶۵٪).
این تنوع اهمیت زیادی دارد، زیرا MMLU-Pro و GPQA از رقابتیترین محکها هستند که به ترتیب ۱۴۱ و ۱۱۱ مدل در آنها شرکت کردهاند. توانایی BeDraft در حفظ صدر جدول در شلوغترین دستهها و همزمان تسلط بر وظایف سازمانی، تعادلی نادر میان قدرت خام و دقت عملیاتی است.
تحلیل: بازتعریف مدل «باهوش»
این تغییر در رهبری نشان میدهد که «مرز» هوش مصنوعی از قابلیتهای عمومی به سمت پایداری عملیاتی در حال حرکت است. برای متخصصان فنی، امتیاز ۹۸.۹۵٪ در IFStruct بسیار ارزشمندتر از یک نمره کامل در ریاضی است، زیرا تضمین میکند که خط لولههای مبتنی بر AI به دلیل نبود یک کاما در پاسخ JSON کرش نکنند.
علاوه بر این، سازوکار ZTC نقطه اصطکاک اصلی در گردش کارهای عاملمحور، یعنی تأخیر در حلقه «منتقد» را برطرف میکند. BeDraft با انتقال تایید صحت از لایه خروجی به لایه وضعیت داخلی، به جای تمرکز صرف بر کیفیت پاسخ، بر سرعت اجرا بهینهسازی کرده است.
این نوآوری در حال حاضر توجه زیادی جلب کرده است. اپلیکیشن Gate Arcade متعلق به BeDraft که به کاربران اجازه میدهد قضاوت عاملهای AI را تجربه کنند، به عنوان یکی از «Spaces of the Week» در Hugging Face انتخاب شد؛ انتخابی که هر هفته تنها ۸ اپلیکیشن را از میان تقریباً ۱.۵ میلیون اپلیکیشن برمیگزیند. این دومین بار در یک ماه است که BeDraft توسط جامعه هوش مصنوعی مورد تقدیر قرار میگیرد.
برای کسانی که مایل به بررسی این قابلیتها هستند، مدلها در آدرسهای huggingface.co/FINAL-Bench/Darwin-180B-RSI و huggingface.co/FINAL-Bench/Darwin-180B-RSI-R3 در دسترس هستند.
گام بعدی شما
- اگر از مدلهای زبانی برای تولید JSON استفاده میکنید، مدلهای سری Darwin را در Hugging Face تست کنید تا نرخ خطای فرمتبندی خود را بسنجید.
- برای کاهش تأخیر در سیستمهای عاملمحور، معماری ZTC را جایگزین مدلهای منتقد (Critic) متنی کنید.
- مستندات RSI را مطالعه کنید تا متوجه شوید چگونه میتوان بدون دادههای انسانی، مدل را از طریق پاسخهای تاییدپذیر ارتقا داد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو