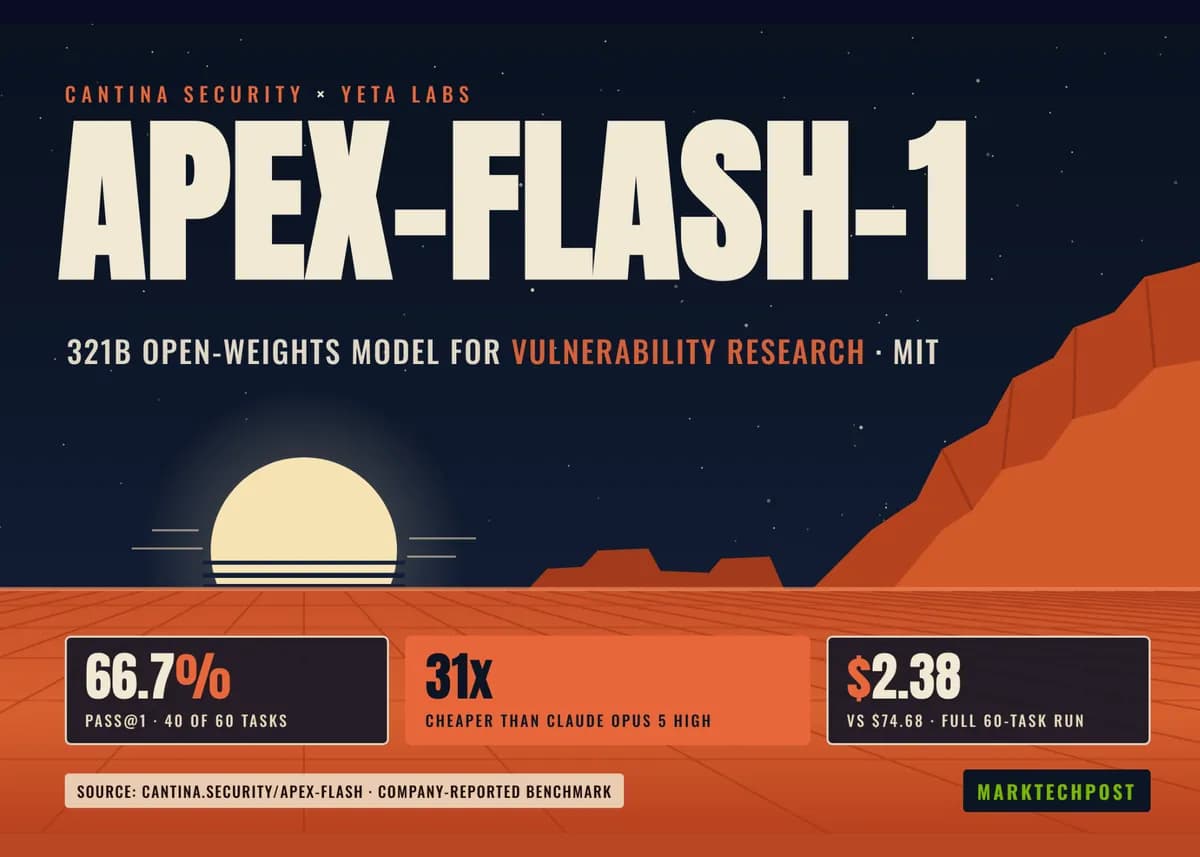
هزینهٔ اتوماسیون پژوهشهای آسیبپذیری بهطور ناگهانی سقوط کرد. Cantina Security در همکاری با Yeta Labs، در ۵ اکتبر ۲۰۲۶ مدل apex-flash-1 را منتشر کرد تا ثابت کند یک مدل تخصصی با وزنهای باز (Open Weights) میتواند با کسری از هزینه، عملکرد سیستمهای تجاری تراز اول را شبیهسازی کند.
بسیاری از پژوهشگران امنیتی در حال حاضر به مدلهای ابری عظیم و چندمنظوره متکی هستند که مقیاسپذیری آنها گران است و اجرای محلیشان غیرممکن است. این وضعیت برای مدافعانی که نیاز به تحلیل کدهای حساس دارند بدون اینکه دادهها را به ارائهدهندگان شخص ثالث درز دهند، یک گلوگاه ایجاد میکند. همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، کنترل روی دادهها در محیطهای حساس، اولویت اول تیمهای قرمز است.
به نقل از گزارش Marktechpost، مدل apex-flash-1 حاصل یک تنظیم دقیق (Fine-tuning) با استفاده از یادگیری تقویتی روی مدل GLM-5.3-Flash متعلق به شرکت Z.ai است. این رویکرد در ادامه تلاشهای جامعه امنیتی برای بهینهسازی مدلهای پایه قرار دارد؛ برای مثال، پیش از این فرآیند تبدیل GLM-5.3 به یک مدل متراکم برای محیطهای بدون ابر بررسی شده بود تا دسترسی محلی به این مدلها تسهیل شود. این مدل از معماری ترکیب خبرهها (Mixture of Experts) با ۳۲۱.۳ میلیارد پارامتر کل و ۱۸ میلیارد پارامتر فعال بهره میبرد. آموزش این مدل از طریق بهینهسازی سیاست نسبی گروهی (GRPO) روی ۱۵۰ تسک استخراجشده از ۵۰ مورد واقعی آسیبپذیری صورت گرفته است.
مشخصات فنی و عملکرد
- تمرکز آموزشی: ۷۲٪ موارد مربوط به نقصهای احراز هویت، شناسیت و محدوده دسترسی و ۱۸٪ روی محاسبات عددی و دقت بود.
- نتایج محک: در یک مجموعه آزمون ۶۰ تسکی، این مدل به نرخ pass@1 معادل ۶۶.۷٪ رسید و ۴۰ مورد از ۶۰ تسک را حل کرد.
- بهرهوری هزینه: هزینه یک اجرای کامل حدود ۲.۳۸ دلار بود، در حالی که برای Claude Opus 5 High این رقم ۷۴.۶۸ دلار است؛ در حالی که مدل کلود تنها ۳ تسک بیشتر (۷۱.۷٪) را حل کرد.
- استقرار: این مدل تحت لایسنس MIT منتشر شده و روی vLLM، SGLang یا Transformers قابل سرویسدهی است، هرچند وزنهای BF16 آن به حدود ۶۴۰ گیگابایت حافظه GPU نیاز دارند.
به گزارش منابع فنی، Cantina این مدل را نه بهعنوان یک ارکستراتور مستقل، بلکه بهعنوان یک مدل «کارگر» با بازدهی بالا معرفی کرده است. هدف این مدل مهارتهای خاصی است: خواندن کد، استفاده از ابزارها، توسعه اکسپلویتها و تایید نهایی.
این تغییر، معیار سنجش هوش مصنوعی امنیتی را از «حداکثر توانایی» به «توانایی بهازای هر دلار» تغییر میدهد. با دستیابی به هزینه ۰.۰۶ دلار برای هر تسک حلشده در برابر ۱.۷۴ دلار برای Opus، ثابت شد که تنظیم دقیق RL در حوزههای تخصصی میتواند شکاف میان مدلهای باز و مدلهای پیشرو (Frontier) را پر کند.
برای جامعه امنیتی، برد واقعی در کنترل محلی است. دسترسی به مدلی با لایسنس MIT یعنی مدافعان اکنون میتوانند ابزارهای پژوهش آسیبپذیری را در محیطهای ایزوله (Air-gapped) بدون افت شدید عملکرد مستقر کنند.
گام بعدی شما
- بررسی مخازن جامعه برای یافتن نسخههای کوانتیده (Quantization) ۴ بیتی جهت اجرای مدل روی تکGPU.
- تست مدل در محیطهای ایزوله برای تحلیل کدهای حساس سازمانی.
- مقایسه نرخ خطای مدل در تسکهای مربوط به احراز هویت در برابر مدلهای عمومی.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو