تصور کنید ساعتها وقت صرف خواندن یک گزارش پیچیده میکنید و وقتی از هوش مصنوعی میپرسید «کدام بخش به این موضوع اشاره کرده»، مدل با اطمینان صفحهای را نام میبرد که اصلاً وجود ندارد. این کابوس پژوهشگران، دقیقاً همان نقطهای است که CiteWise برای حل آن طراحی شده است. تنها پاسخی که این ابزار در صورت عدم یافتن یک عبارت خاص در PDF ارائه میدهد، عبارت «ناکافی» (Insufficient) است. این رویکرد تضمین میکند که ابزار هرگز در ارجاعدهی دچار توهم نشود.
این پروژه برای «چالش هوش مصنوعی متنباز هکتوبرفست» (Hacktoberfest Open-Source AI Challenge) در هفته دوم با موضوع «کسبوکار جانبی» توسعه یافته است. CiteWise در واقع یک میز تحقیق محلی است که به کاربران اجازه میدهد بدون ریسک اختراع استنادات جعلی توسط هوش مصنوعی، از اسناد خصوصی خود پرسوجو کنند.
بسیاری از سیستمهای تولید بازیابیافزا (RAG) — که شبیه دانشآموزی است که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — اولویت را به روانی متن میدهند. به همین دلیل، وقتی مدل نمیتواند پاسخ دقیقی بیابد، شروع به «بلوف زدن» میکند. این نقص برای دانشجویان که بستههای مطالعاتی را بررسی میکنند، پژوهشگرانی که با PDFهای آپلود شده کار میکنند، یا دفاتر کوچک حقوقی که نمیخواهند فایلهایشان به یک API چت ابری ارسال شود، یک شکست بحرانی است. این چالشها در ابزارهای پژوهشی رایج است، مشابه آنچه در سیستم خودکارسازی خط لولهی پژوهشهای آکادمیک Researcher Campus برای مدیریت حجم بالای دادهها دیده میشود. این کاربران اغلب ساعتها وقت خود را صرف «بازبینی دوم» میکنند؛ یعنی باز کردن مجدد PDF، یافتن صفحه و بررسی اینکه آیا آن جمله روانِ تولید شده توسط هوش مصنوعی، واقعاً در فایل وجود داشته است یا خیر.
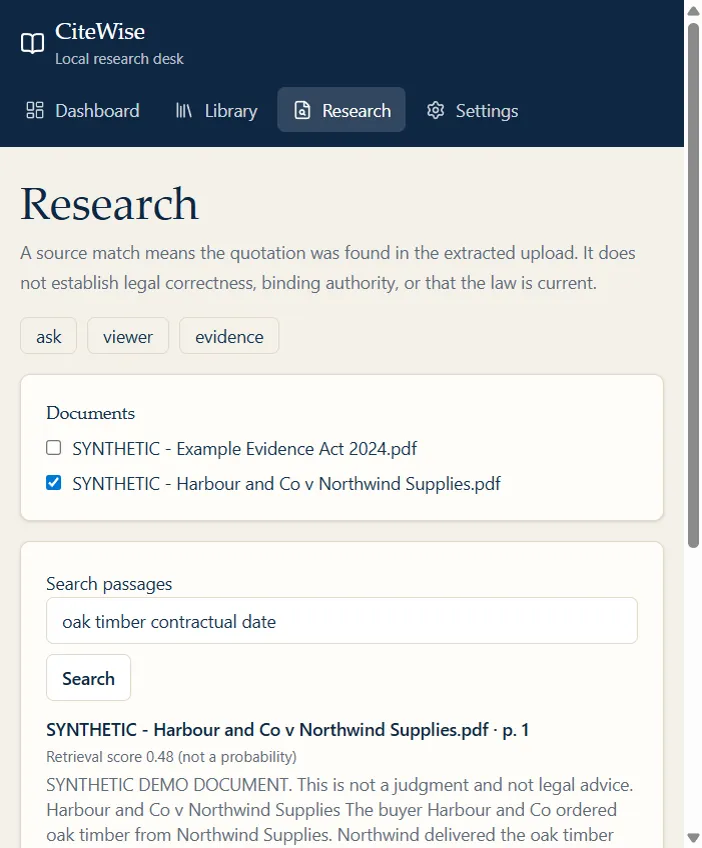
CiteWise این مشکل را با تبدیل استناد به یک عملیات «تطبیق دقیق متنی» حل میکند. طبق مستندات این پروژه، یک نقلقول تنها زمانی پذیرفته میشود که چهار شرط برقرار باشد: تکه متن باید وجود داشته باشد، شماره صفحه باید درست باشد، تکه متن باید به مدل نشان داده شده باشد و عبارت نقلشده پس از نرمالسازی با متن استخراجشده مطابقت کند. باید توجه داشت که این ابزار به عنوان یک وکیل یا پایگاه دادهای از مراجع قانونی طراحی نشده است؛ تطبیق منبع صرفاً به معنای یافتن عبارت در متن است، نه لزوماً اینکه آن اظهارنظر از نظر قانونی الزامآور یا یک قانون جاری باشد.
به گزارش وبسایت dev.to در ۱۶ اکتبر ۲۰۲۶، این سامانه بهطور کامل محلی است. در لایه بکاند از FastAPI (تحت مسیر /api/v1)، برای ذخیرهسازی از SQLite و برای استخراج اسناد از PyMuPDF استفاده میکند. در لایه هوش مصنوعی، این ابزار به Ollama در آدرس 127.0.0.1:11434 متصل شده و از مدل llama3.2:3b برای تولید متن و nomic-embed-text برای ایجاد بردار معنایی (Embedding) — که مثل کارت معرفی عددی برای هر واژه است تا همسایگان معناییاش را بشناسد — بهره میبرد. رابط کاربری نیز با React, TypeScript و Vite توسعه یافته است.
معماری فنی و محدودیتها
- پشتهٔ محلی-محور: برنامه با پایتون ۳.۱۲ و Node روی سیستم کاربر اجرا میشود و از هرگونه API تجاری ابری دوری میکند. برای بازیابی دادهها از rank-BM25 و یک شاخص محلی FAISS استفاده میکند.
- منطق اعتبارسنجی: پرسیدن یک سوال ابتدا باعث بازیابی تکههای متن میشود و سپس آنها با یک طرحواره JSON به Ollama ارسال میگردند. اگر مدل تولیدکننده خروجی JSON را بهگونهای برگرداند که با طرحواره مطابقت نداشته باشد، برنامه یک بار تلاش مجدد میکند و در نهایت خروجی را به عنوان
invalid_model_outputعلامتگذاری میکند. - مکانیزمهای جایگزین: اگر مدل بردار معنایی (Embedding) موجود نباشد، سیستم به یک هش قطعی (Deterministic Hash) روی میآورد و نام این جایگزین را در رابط کاربری نمایش میدهد. در صورت قطع بودن Ollama نیز پاسخ به عنوان
model-unavailableذخیره میشود. - معیارهای بازیابی: توسعهدهنده از یک مجموعه داده کوچک برچسبدار (Development Fixture) و یک اسکریپت برای چاپ معیارهای Recall@k، MRR و nDCG استفاده کرده است. در این آزمایش، بازیابی کلمات کلیدی در ۸ پرسوجوی مصنوعی به امتیاز ۱.۰ رسیده است.
زمینه و تأثیرات توسعه
این پروژه تحت تأثیر سه پست تخصصی در وبسایت DEV شکل گرفته است. پست «RAG فراتر از دمو» نوشته xinyangwuethz، دیدگاهی صریح درباره استنادات و خطر جلوه دادن یک دمو به عنوان یک ارزیابی رسمی ارائه داد. پروژه «Picard OSS» نوشته iamsaurabhc به عنوان یک الگوی نزدیک عمل کرد؛ یک دستیار حقوقی محلی که از بلوف زدن خودداری میکند. در نهایت، پستی از pingredsai در مورد یک پشته RAG خود-میزبان بدون APIهای ابری، محدودیتهای زیرساختی این ابزار را شکل داد.
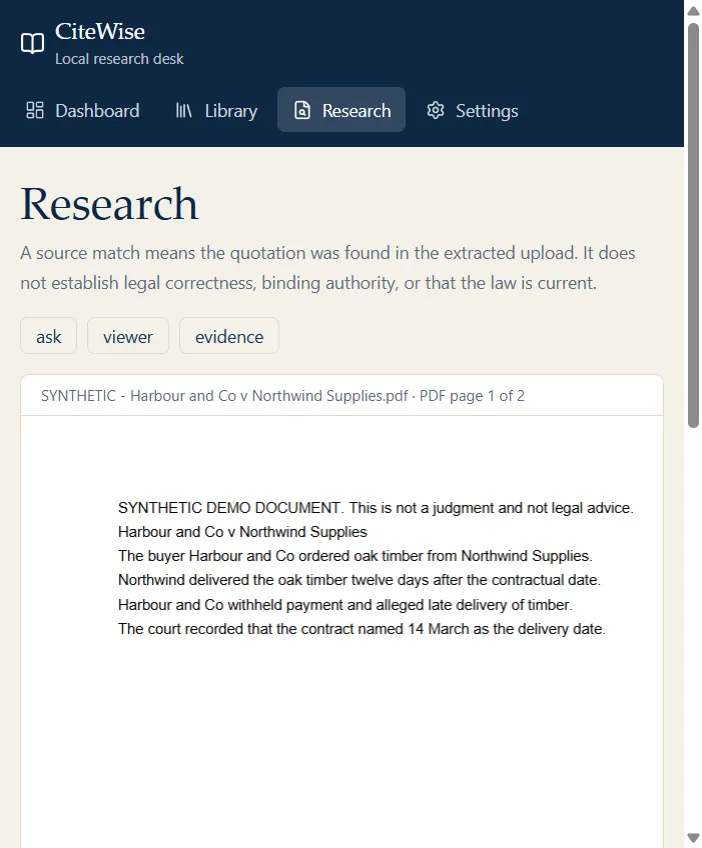
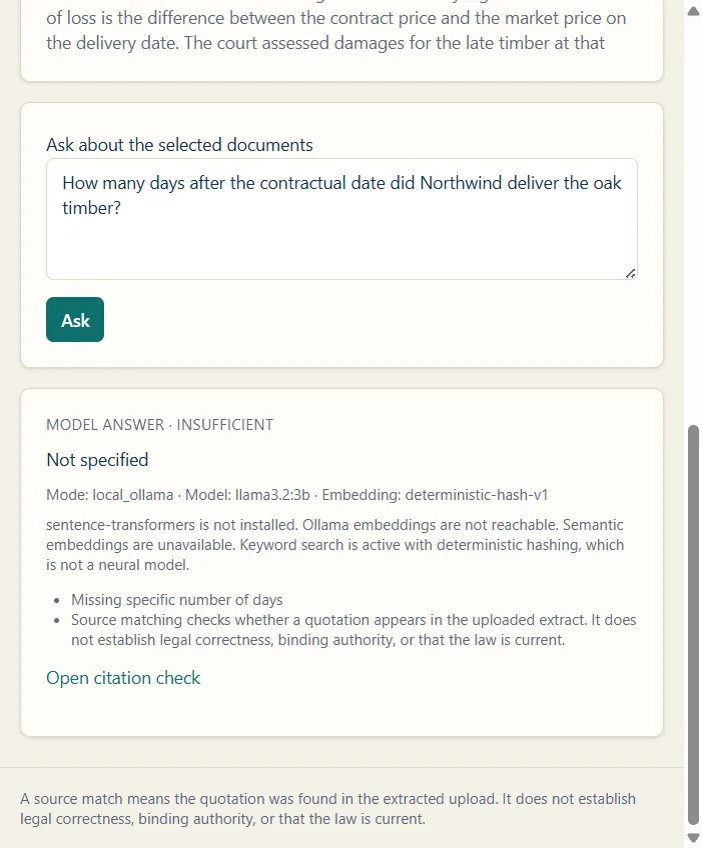
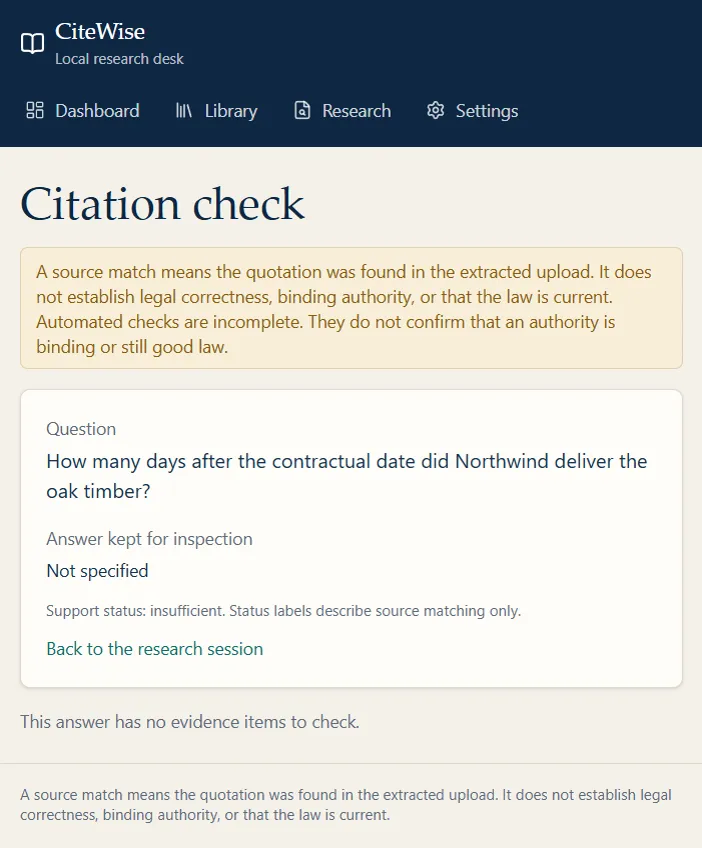
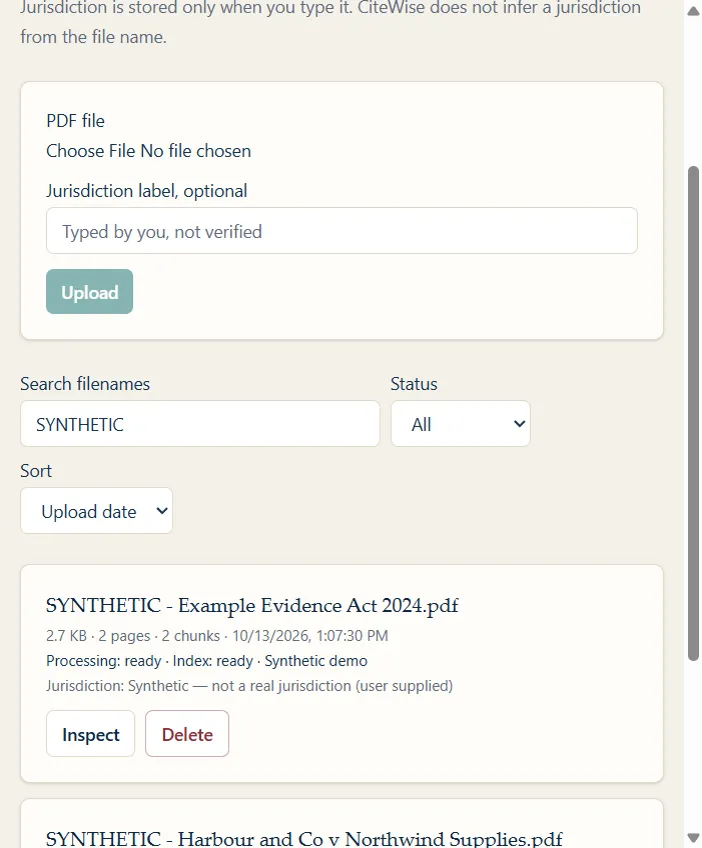
سختگیری این ابزار در دموهای آن با PDFهای مصنوعی (که در برنامه با برچسب SYNTHETIC مشخص شدهاند) بهوضوح دیده میشود. در دموی Northwind، سندی ذکر میکند که چوب بلوط ۱۲ روز پس از تاریخ قرارداد رسیده است. وقتی از مدل llama3.2:3b پرسیده شد چند روز تأخیر وجود داشته، مدل پاسخ داد: «مشخص نشده است». با اینکه شواهد در متن موجود بود، اما CiteWise شکست صادقانه مدل را حفظ کرد و پاسخ را «ناکافی» برچسب زد تا از جعل استناد و تبدیل عبارت «۱۲ روز» به استنادی که مدل واقعاً تولید نکرده بود، جلوگیری کند. این رویکردی است که در پروژه OpenBrief برای مقابله با اتکای بیش از حد به هوش مصنوعی و تحریک تفکر انتقادی کاربر نیز به کار گرفته شده است.
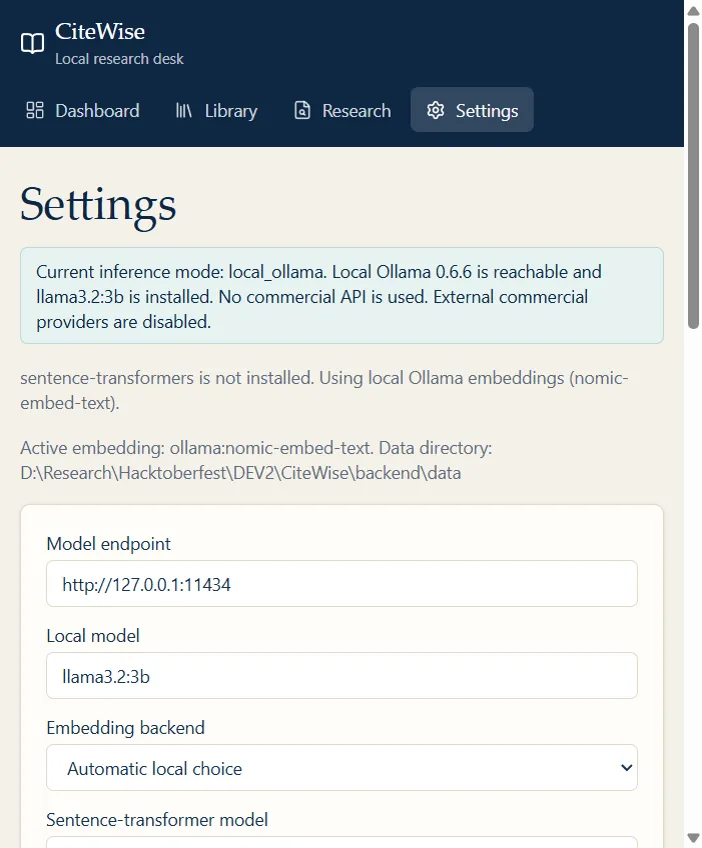
این رویکرد، هوش مصنوعی را از یک «جعبه سیاه» به ابزاری قابل بازرسی تبدیل میکند. چون مدل دارای وزنهای باز (Open Weights) — یعنی دستور پخت مدل علناً منتشر شده و نه فقط غذای آماده — است و محلی اجرا میشود، تمام خطاها شفاف هستند. کاربر دقیقاً میبیند کدام صفحه بازیابی شده و چرا مدل پاسخ را پیدا نکرده است، که این سطح از قابلیت حسابرسی را APIهای بسته فراهم نمیکنند. همچنین تغییر تگ مدل نیازی به ایجاد حساب کاربری در یک شرکت فروشنده جدید ندارد.
در نهایت، CiteWise حاکمیت داده را بر راحتی ترجیح میدهد. این ابزار برای کاربرانی است که به دلیل الزامات قانونی یا اخلاقی، اجازه ندارند فایلهای حساس را به سرورهای شخص ثالث بفرستند. توسعهدهنده اشاره میکند که اگرچه هزینههای برق یا سختافزار را در برابر APIهای ابری اندازهگیری نکرده است، اما ادعای اصلی این است که سند هرگز ماشین کاربر را ترک نمیکند. در مقابل، ابزارهایی مانند CiteKit با تمرکز بر بهینهسازی وبسایتها برای عاملهای هوش مصنوعی، رویکردی متفاوت در جهت تسهیل دسترسی مدلها به دادههای عمومی دارند.
برای بررسی پیادهسازی، میتوانید به مخزن Abishethvarman/CiteWise دسترسی پیدا کنید. برای اجرای محلی، کاربران باید یک مدل را دریافت کنند (مثلاً ollama pull llama3.2:3b)، یک محیط مجازی پایتون بسازند و بکاند را از طریق uvicorn روی پورت ۸۰۰۰ اجرا کرده و همزمان رابط کاربری Vite را اجرا کنند.
گام بعدی شما
- اگر با اسناد محرمانه کار میکنید، مخزن Abishethvarman/CiteWise را بررسی کنید تا متوجه شوید چگونه بدون خروج داده از سیستم، استنادات را تأیید کنید.
- مدلهای کوچکتر مثل Llama 3.2 را در Ollama تست کنید تا سرعت استنتاج محلی را با دقت مدلهای بزرگتر مقایسه کنید.
- برای کاهش نرخ توهم، منطق «تطبیق دقیق متنی» را در پروژههای RAG خود جایگزین اعتماد مطلق به مدل کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو