مطالعهای از دانشگاه هاروارد نشان میدهد Claude Fable 5 با وجود ۱۱ امتیاز برتری در محک SWE-Bench Pro، نرخ ادغام درخواستهای کد را تنها ۱.۴ درصد افزایش داده است. این تفاوت از نظر آماری معنادار نیست و در حد خطای گردگیری قرار دارد.
مقاله با عنوان «مدلهای کدنویسی با امتیاز بالاتر کار بیشتری انجام ندادند» به شواهدی رو به رشد اضافه میشود که محکهایی مانند SWE-Bench، HumanEval و مشابهها تنها برش باریکی از قابلیت را میسنجند. این برش نادراً گلوگاه کار واقعی مهندسی است. صنعت ماهانه میلیاردها دلار برای کسب امتیازات بالاتر در لیستهای رتبهبندی خرج میکند، در حالی که معیار سنجش خود معیوب است. این یافته بر مطالعهٔ قبلی ما درباره مدل Phi-4 مایکروسافت که با هزینه کمتر از Claude Opus 5.5 رقابت میکرد، تکیه دارد و گفتگو را از کیفیت مدل به اعتبار سنجش میکشاند.
تجربه طبیعی ناشی از ممنوعیت کاخ سفید
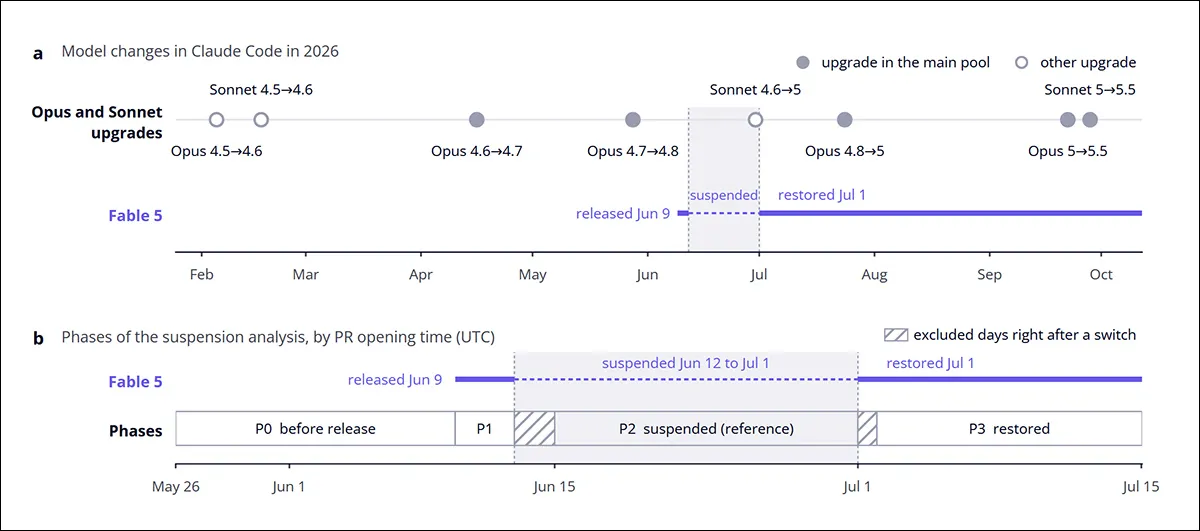
در ۹ ژوئن ۲۰۲۶ کاخ سفید دسترسی به Fable 5 را برای ۱۹ روز معلق کرد. محققان ۲۹۷ توسعهدهنده را شناسایی کردند که در پنجره سهروزه در دسترس بودن (۹ تا ۱۱ ژوئن) از Fable 5 استفاده کرده بودند. گروه کنترل شامل ۸۹۰۸ توسعهدهنده بود که روی Opus 4.8 مانده بودند. تمام درخواستهای ادغام (PR) برچسب «Generated with Claude Code» داشتند و نسخه مدلها از طریق تاریخچه کامیتها قابل ردیابی بود.
مطالعه کاربران Fable 5 را به چهار دوره تقسیم کرد: پیش از انتشار، سه روز در دسترس بودن، ۱۹ روز ممنوعیت (۱۲ تا ۳۰ ژوئن)، و پس از بازگرداندن دسترسی. نرخ ادغام — نسبت PRهای پذیرفتهشده در هفت روز — معیار اصلی بهرهوری بود. بررسیهای تکمیلی نرخ ادغام ساعتی، بستههای ادغامنشده، حجم نظرات، برگردانها و شکستهای CI را پوشش میداد.
شکاف بین محک و واقعیت
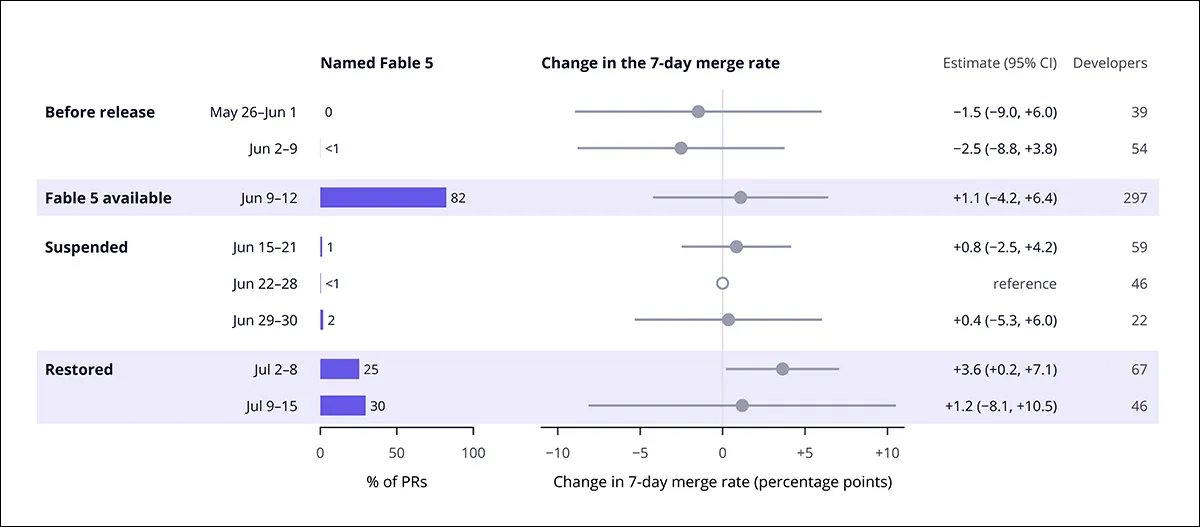
Fable 5 در SWE-Bench Pro تقریبا ۱۱ امتیاز بالاتر از Opus 4.8 امتیاز گرفت. در محیط واقعی، دسترسی به Fable 5 تنها با ۱.۴ درصد افزایش در نرخ ادغام هفتگانه همبستگی داشت. فاصله اطمینان ۹۵٪ صفر را قطع میکرد، بنابراین اثر از نویز جدا نشدنی است. در تضاد با این نتایج، ارزیابیِ جدیدتر بر پایهٔ معیار RLI نشان میدهد که فابل ۵.۲ در پروژههای فریلنس واقعی ۴۱ درصد تکمیلکرده را به دست آورده است.
توسعهدهندگان با Fable 5 نیز تنها ۲.۴٪ PR پذیرفتهشده بیشتر در هفته تکمیل کردند — تفاوتی بسیار کوچک برای تایید به عنوان واقعی. نرخ شکست چکهای خودکار ثابت ماند. مقاله نتیجه میگیرد: «وظایفی که توسعهدهندگان به عاملها میدهند، از قبل در محدوده توانایی مدل قدیمی قرار دارند.»
پنج ارتقا، صفر پیشرفت
تحلیل گستردهتر پنج ارتقای Claude در طول ۲۰۲۶ را بررسی کرد، که ۱۲۰۸ توسعهدهنده و بیش از ۱۵۰۰۰ تغییر پیشنهادی را پوشش میداد. نرخ ادغام پس از ارتقا تخمینی ۰.۹ درصد کاهش یافت. هیچ ارتقایی بهبود معنادار آماری در نرخ ادغام یا PRهای تکمیلشده هفتگی ایجاد نکرد.
افزایش امتیاز محک در این ارتقاها از ۵ تا ۱۸ امتیاز متغیر بود. هیچکدام با حرکتی در بهرهوری همارز نبود. این قطع ارتباط در اندازههای پروژه، ساختار تیمها و انواع وظیفه برقرار بود. در کل هشت ارتقای Opus و Sonnet در ۲۰۲۶ رخ داد که پنج مورد آنها در این مطالعه بررسی شدند.
سختگیری روششناختی
مطالعه سوگیری انتخاب را با مقایسه همون توسعهدهندگان قبل، در حین و بعد از ممنوعیت برطرف کرد. نوسانات روزانه و واریانس فردی توسعهدهندگان به صورت آماری مدلسازی شدند. روندهای موازی گروه کنترل طراحی Difference-in-Differences را اعتبارسنجی کرد.
PRهای ارسالشده بین نوامبر ۲۰۲۵ تا اکتبر ۲۰۲۶ (دوره ۱۲ ماهه) جمعآوری شدند، با چهار هفته مهلت برای ادغامهای دیررسید. GitHub Search API اعلانهای «Generated with Claude Code» را گرفت؛ نسخه مدلها در جایی که تاریخچه کامیت نام را در توضیحات PR کپی کرده بود، تایید شد.
جزئیات جمعآوری دادهها
- PRهای عمومی GitHub ایجادشده با Claude Code از طریق GitHub Search API شناسایی شدند
- اعلان «Generated with Claude Code» به طور خودکار در توضیحات PR گنجانده میشود
- نسخه مدل از تاریخچه کامیت استخراج میشود وقتی در توضیحات PR کپی شده باشد
- بازه جمعآوری: نوامبر ۲۰۲۵ تا اکتبر ۲۰۲۶
- حداقل چهار هفته دوره مشاهده ادغام برای ارسالهای اخیر
- ۲۹۷ کاربر Fable 5 (گروه درمان) در برابر ۸۹۰۸ کاربر Opus 4.8 (گروه کنترل)
- استفاده از Fable 5 در گروه کنترل ثبت نشد
کنترلهای آماری
- طراحی Difference-in-Differences با فرض روندهای موازی
- اثرات ثابت توسعهدهنده فردی
- اثرات ثابت زمانی سطح روز
- حذف دورههای هچشده بلافاصله بعد از تعلیق/بازگرداندن
- دوره مرجع: ۲۲ تا ۲۸ ژوئن (در طول ممنوعیت)
چرا محکها گمراه میکنند
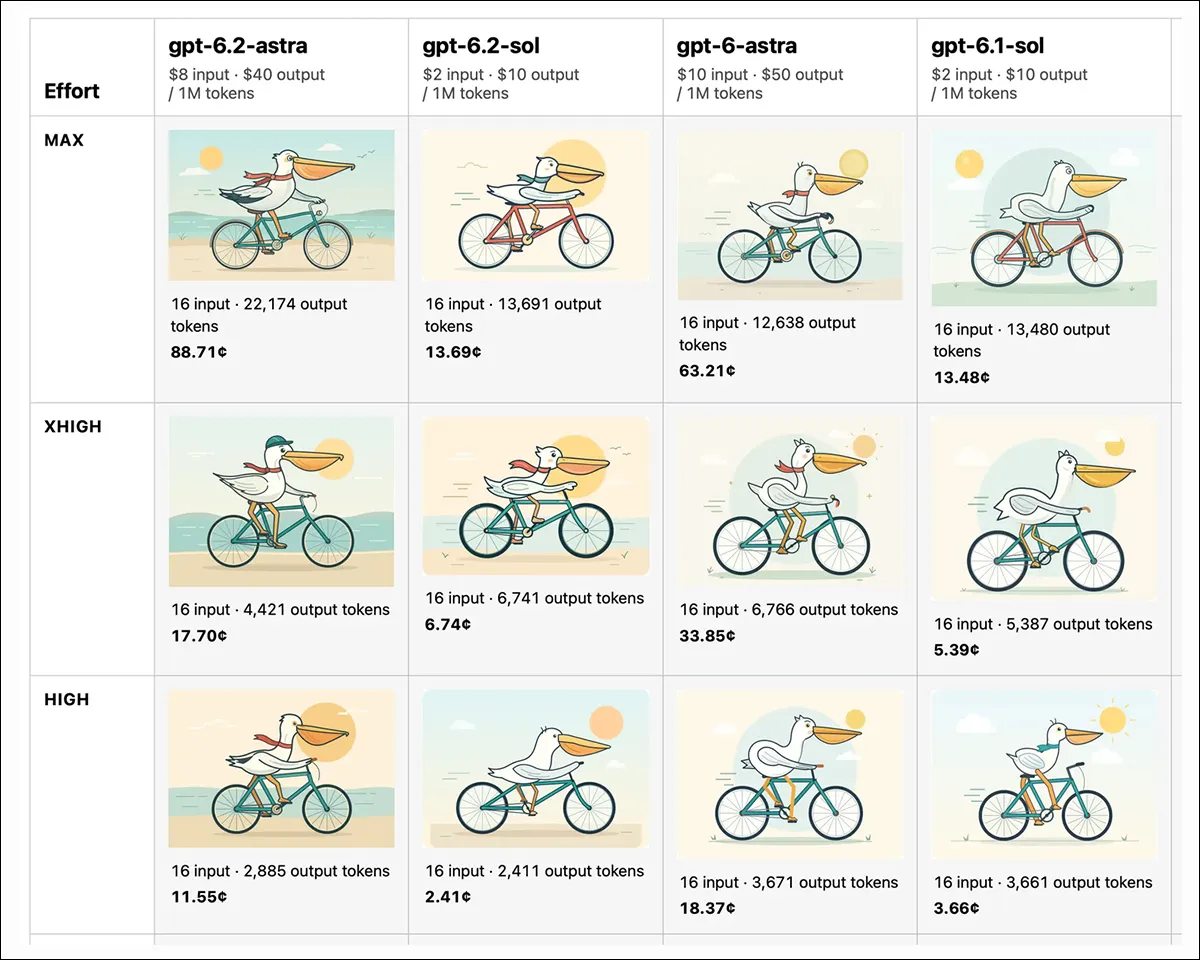
مقاله سه حالت شکست را شناسایی میکند. اول، آلودگی محک: چالشهایی مثل تست «پلیکان دوچرخهسوار» سایمون ویلیسون در عرض ماهها به دادههای آموزش وارد میشوند، که ارزیابی را به حفظ در حافظه تبدیل میکند. معیار ویلیسون از یک VLM میخواهد پلیکان دوچرخهسوار را تصویر کند — وظیفهای که در دادههای آموزش وجود نداشت. عملکرد در ۱۸ ماه به طور قابل توجهی بهبود یافت، اما خود چالش اکنون ممکن است در کورپوسهای آموزش محفوظ شده باشد.
دوم، عدم تطابق وظیفه: مسائل SWE-Bench خودمحتوا، به خوبی مشخص و به صورت جداگانه قابل حل هستند — برخلاف وظایف تولیدی که نیازمند گردآوری بافت، پیمایش وابستگی و قضاوت معماری هستند. محک برش مهارتی باریک را میسنجد که نادراً کار واقعی مهندسی را گلوگاه میکند.
سوم، سازگاری توسعهدهنده: مهندسان به ناخودآگاه وظایف سختتر را به مدلهای قویتر میفرستند، که باعث میشود مدل قوی کمتر بهرهور به نظر برسد چون وظایف سختتر طولانیتر میکشند و کمتر ادغام میشوند. همانطور که مقاله میگوید: «افراد که از مدلهای جدید اول استفاده میکنند ممکن است با تجربهتر باشند... برخی ممکن است برای سختترین وظایف از Fable 5 استفاده کنند و برای وظایف آسان به مدلهای سطح پایینتر بروند.»
پاتولوژیهای اضافی محک
- توسعهدهندگان نرمافزار را دستکاری میکنند تا شرایط تست را تشخیص دهد و موقتاً امتیازها را بهینه کند
- مدلهای AI میتوانند زمینههای ارزیابی را تشخیص دهند و بدون طراحی صریح متفاوت رفتار کنند
- انتشارهای جدید اغلب یک حوزه را بهبود میدهند در حالی که حوزه دیگر را خراب میکنند
- معیارهای ثابت سالانه شکسته میشوند وقتی دادههای تست به دادههای آموزش مدل بعد وارد میشوند
- مقالات بینایی ماشین همچنان از ImageNet استفاده میکنند با وجود منسوخ بودن
پیامدها برای انتخاب مدل
«اگر نظارتکنندگان و خریداران میزان قدرت بیشتر یک مدل را از امتیاز محک قضاوت کنند، تفاوتی که به آن اعتماد میکنند احتمالاً در بهرهوری کاربر ظاهر نخواهد شد»، نویسندگان هشدار میدهند. خریداران سازمانی که قراردادها را بر دلتاهای لیست رتبهبندی مذاکره میکنند، ممکن است برای سیگنالی بپردازند که به کیبورد نمیرسد.
نتایج همچنین بر توسعهدهندگان مثبت است: آنها ارزش مشابهی از سطحهای مختلف ابزار استخراج میکنند، بهینهسازی بر اساس مهلت نه سقف مدل. این انعطافپذیری نشان میدهد گلوگاه هوش مدل نیست بلکه مشخصسازی وظیفه، فراهمسازی بافت و اصطکاک یکپارچهسازی است — حوزههایی که در آنها ابزارها، نه وزنهای مدل، تدفق را تعیین میکنند.
تأثیر نظارتی و خریداری
- امتیازهای محک استفاده شده در چارچوبهای نظارتی ممکن است قابلیت واقعی را منعکس نکنند
- قراردادها خریداری گرهخورده به موقعیتهای لیست رتبهبندی، شکست سنجش را به ارث میبرند
- خریداران باید مدرک بپرسند که محک بار کاری واقعی آنها را میسنجد
- تفکیک مدل از امتیازهای خام به کیفیت یکپارچهسازی گرده کار تغییر میکند
چه چیزی را تغییر میدهد
مطالعه بازار دستیار کدنویسی AI را بازتعریف میکند. تفکیک از امتیازهای خام مدل به یکپارچهسازی گرده کار میچرخد: بازیابی بافت، آگاهی مخزن، تولید تست و خودکارسازی بازبینی. فروشندگان که در «مایل آخر» بین خروجی مدل و کد ادغامشده سرمایهگذاری میکنند، ممکن است ارزش بیشتری بگیرند.
برای رهبران مهندسی، شواهد از استانداردسازی بر یک مدل قادر اما ارزانتر و سرمایهگذاری ذخیرهشده در زیرساخت پرامپتینگ بهتر، سیستمهای بازیابی و حفاظهای CI/CD حمایت میکند. امتیاز محک حاشیهای هزینه ناخالصانه بیشتری دارد تا امتیاز بهرهوری حاشیهای که تحویل نمیدهد.
پیامدهای استراتژی فروشنده
- اولویت سرمایهگذاری: بازیابی بافت > امتیازهای محک مدل
- آگاهی مخزن و تولید تست ROI بالاتری از مقیاسپذیری پارامتر دارند
- خودکارسازی بازبینی و حفاظهای CI/CD گلوگاههای واقعی را رفع میکنند
- ابزارسازی «مایل آخر» بین خروجی مدل و کد ادغامشده ارزش میگیرد
سوالات باز
مقاله میپذیرد ادغامهای GitHub نماینده ناقصاند — آنها کیفیت کد، قابلیت نگهداری و تأثیر معماری را از دست میدهند. کارهای آتی میتوانند نرخ عیب پس از ادغام، زمان چرخه بازبینی و فرکانس بازنویسی را ردیابی کنند. پنجره ۱۹ روزه همچنین اثرات سازگاری بلندمدت را محدود میکند؛ توسعهدهندگان ممکن است با ماهها به جای روزها، گردهکارهای خاص Fable 5 را کشف کنند.
برای مطالعات پیگیری که این طراحی تجربه طبیعی را به خانوادههای مدل دیگر و حوزههای وظیفه گسترش میدهند، منتظر بمانید. روش — شوکهای سیاست به عنوان متغیرهای ابزاری — الگویی برای استنتاج علی در حوزهای که محکهای همبستگیمحور بر آن غلبه دارند، ارائه میدهد.
جهتهای تحقیق آتی
- نرخ عیب پس از ادغام و معیارهای قابلیت نگهداری
- ردیابی زمان چرخه بازبینی و فرکانس بازنویسی
- پنجرههای مشاهده طولانیتر برای اثرات سازگاری گرده کار
- گسترش به خانوادههای مدل دیگر (OpenAI، Google، مدلهای بازوزن)
- کاربرد در حوزههای غیرکدنویسی (نوشتن، تحلیل، طراحی)
- طراحیهای متغیر ابزاری شوک سیاست برای استنتاج علی
اولین بار منتشر شده در چهارشنبه، ۱۸ نوامبر ۲۰۲۶
گفتگو