تصور کنید به جای خواندن یک مقاله خشک درباره اشتباهات یک تئوری توطئه، با کسی گپ میزنید که با صبوری شما را به تناقضات منطقی خودتان میرساند. این دقیقاً همان نقطهای است که هوش مصنوعی در نبرد با اطلاعات گمراهکننده، بر روشهای سنتی پیروز میشود. تفاوت میان خواندن یک دفترچه راهنما درباره اینکه چرا یک تئوری غلط است و داشتن یک دیالوگ سقراطی که به شما اجازه میدهد نقصهای منطق خود را کشف کنید، بسیار زیاد است.
طبق گزارشی که در ۵ سپتامبر ۲۰۲۶ در وبسایت the-decoder.com منتشر شد، محققان دانشگاه کارنگی ملون (Carnegie Mellon)، امآیتی (MIT) و کرنل دریافتند که یک گفتگوی ۷ دقیقهای با یک چتبات، باور به تئوریهای توطئه را بسیار مؤثرتر از مطالعه یک لیست ایستا از حقایق کاهش میدهد. در واقع، روشهای سنتی «راستیآزمایی» (Fact-checking) که بر ارائه لیستی از حقیقتها برای جایگزینی یک دروغ تکیه میکنند، اغلب شبیه به یک سخنرانی یکطرفه هستند و همین موضوع باعث میشود مخاطب گارد بگیرد؛ اما گفتگوهای تعاملی، فضای کشف خطا را برای کاربر فراهم میکنند.
همانطور که در تحلیلهای قبلی ما دربارهی اثرات شناختی مدلهای زبانی اشاره کردیم، نحوه ارائه اطلاعات به اندازه خودِ اطلاعات اهمیت دارد. در این مطالعه، پژوهشگران از دو رویداد واقعی — سوءقصد به دونالد ترامپ و قتل شخصی به نام کرک — برای آزمایش فرضیه خود استفاده کردند. آنها از طریق یک پلتفرم نظرسنجی، بزرگسالان آمریکایی را جذب کردند و سپس از GPT-4o برای فیلتر کردن و شناسایی افرادی که پیش از این باورهای توطئهآمیز داشتند، استفاده کردند.
حجم نمونهها در این پژوهش قابل توجه بود: در آزمایش مربوط به ترامپ، ۴۷۲ شرکتکننده باقی ماندند و در آزمایش مربوط به کرک، ۱۰۳۵ نفر حضور داشتند. پس از اندازهگیری باورهای اولیه، شرکتکنندگان بهطور تصادفی به یکی از سه گروه زیر اختصاص یافتند:
- گروه گفتگو: این افراد حداقل ۵ دور گفتگو (رفت و برگشت) با گوگل جمینای (Google Gemini) داشتند. در آزمایش اول از نسخه ۱.۵ (مورخ فوریه ۲۰۲۴) و در آزمایش دوم از نسخه ۲.۵ (مورخ ژوئن ۲۰۲۵) استفاده شد. به مدل دستور داده شده بود که از طریق گفتگوهای مبتنی بر شواهد، باورهای توطئهآمیز را کاهش دهد.
- گروه برگه حقیقت: این افراد تنها یک برگه حقیقت ایستا (Static Fact Sheet) را دریافت کردند که حاوی استنادات و منابع بود.
- گروه کنترل: این گروه درباره موضوعی کاملاً بیربط، یعنی اینکه سگها یا گربهها همراهان بهتری هستند، با مدل گپ زدند.
به نقل از مستندات این پژوهش، از آنجایی که رویدادها پس از تاریخ قطع آموزش مدلها (Training Cutoffs) رخ داده بود، محققان یک پایگاه دانش دقیق و منتخب را مستقیماً در پرامپت سیستمی (System Prompt) — دستورالعملهای پنهانی که رفتار مدل را تعیین میکند — قرار دادند. این پایگاه دانش به سه بخش تقسیم شده بود: حقایق تأییدشده، ادعاهایی که پیشتر رد شده بودند و پرسشهایی که صراحتاً به عنوان «باز» یا «نامشخص» علامتگذاری شده بودند. در آزمایش مربوط به کرک، دسترسی به جستوجوی وب مجاز بود، اما فقط برای تأیید ادعاهای واقعی.
سازوکار متقاعدسازی در این دو مورد متفاوت بود. در پرونده ترامپ که انگیزههای ضارب در آن زمان مبهم بود، مدل از استراتژی «تواضع معرفتی» (Epistemic Humility) استفاده کرد؛ یعنی پذیرفت که محدودیتهایی در دانش خود دارد و با پرسشهای سقراطی، کاربر را واداشت تا درباره شواهد و مدارک خود فکر کند. اما در پرونده کرک که دادههای بیشتری در دسترس بود، مدل بر استدلالهای مستقیم واقعی تکیه کرد و آسیبهای اجتماعی ناشی از تفکر توطئهآمیز را برجسته ساخت.
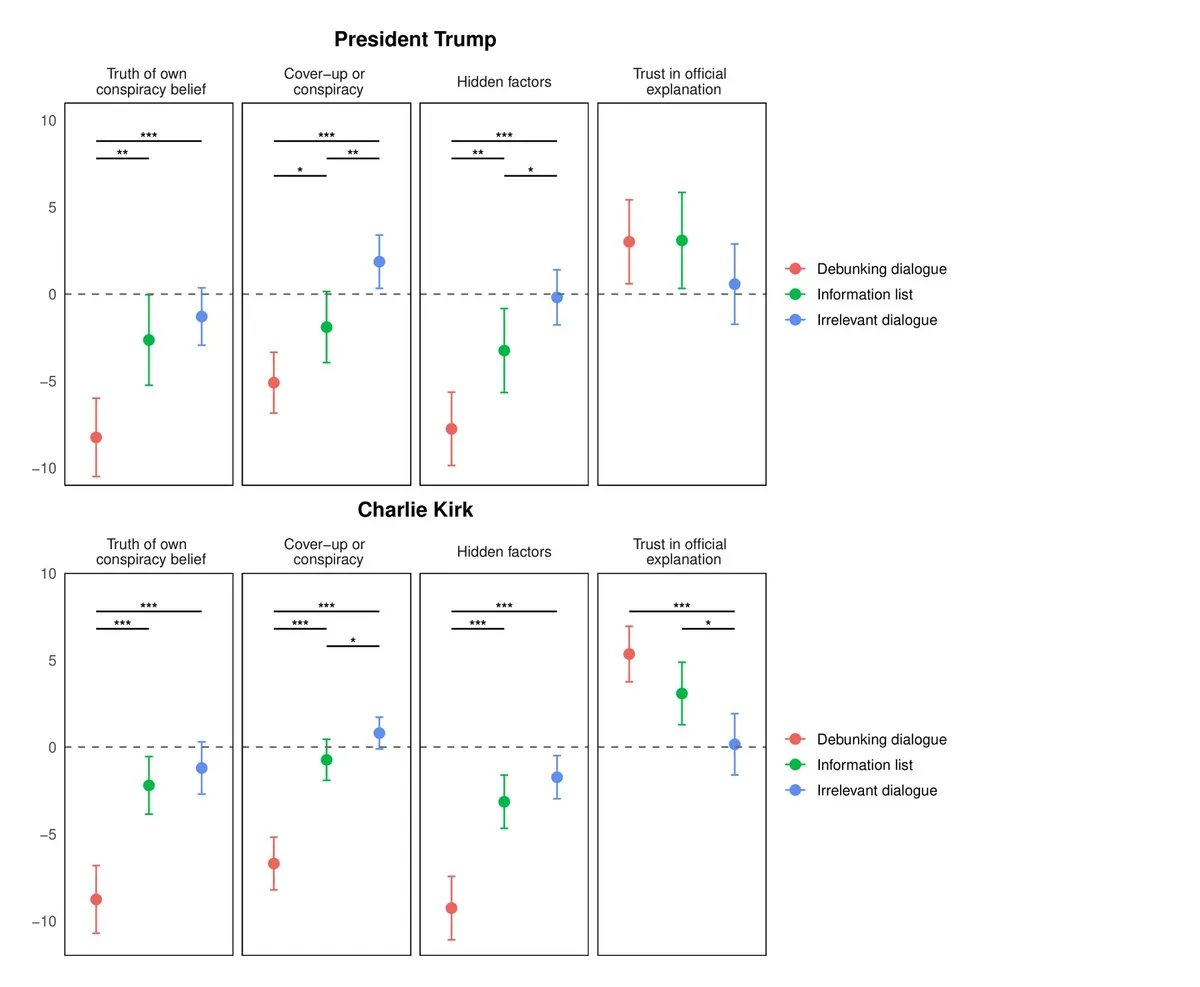
نتیجه در هر دو مورد یکسان بود: گروه گفتگو، کاهش چشمگیرتری در باور به تئوریهای شخصی خود را نسبت به گروه برگه حقیقت تجربه کردند. همچنین میزان موافقت با جملاتی مانند «وجود عوامل پنهان یا افشا نشده» و «پوشاندن حقیقت یا توطئه» در این گروه کاهش یافت.
با این حال، تأثیر این گفتگوها بر اعتماد به روایتهای رسمی متفاوت بود. در پرونده کرک، جایی که مقامات پیش از این جزئیات مربوط به عامل جنایت را به اشتراک گذاشته بودند، اعتماد به توضیحات رسمی در مقایسه با گروه کنترل، اندکی افزایش یافت. اما در پرونده ترامپ، اعتماد به روایت رسمی افزایش نیافت. نویسندگان این موضوع را به نبود یک توضیح رسمی و شفاف در آن زمان نسبت میدهند؛ چرا که شکستهای امنیتی شناخته شده بود، اما انگیزه تیرانداز حتی تا زمان نگارش مطالعه نامشخص باقی مانده بود. نکته قابل توجه این است که گفتگوهای مربوط به پرونده کرک هیچ اثر قابل اندازهگیری بر حمایت از خشونتهای سیاسی نداشت.
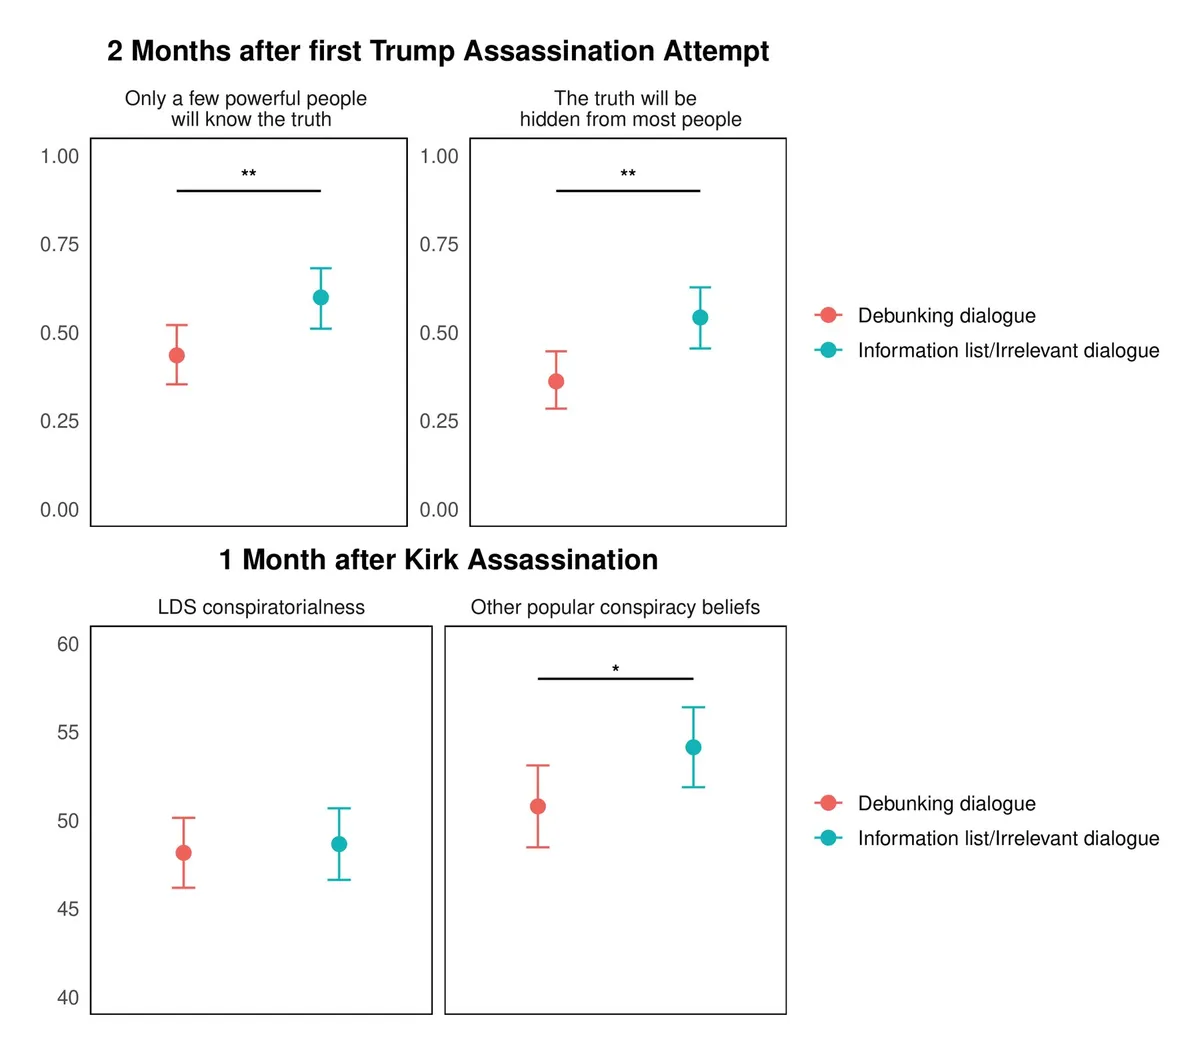
یکی از تکاندهندهترین یافتهها، «اثر سرریزی» (Spillover Effect) یا نوعی واکسیناسیون ذهنی بود. دو ماه پس از آزمایش اول مربوط به ترامپ، مرد مسلح دیگری در ملک او دستگیر شد. شرکتکنندگانی که پیش از این در گفتگوی رد توطئه با هوش مصنوعی شرکت کرده بودند، کمتر تمایل داشتند باور کنند که حقیقت از مردم پنهان شده یا تنها توسط چند فرد قدرتمند شناخته شده است.
این موضوع نشان میدهد که مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — تنها یک داستان خاص را رد نکرد، بلکه به عنوان نوعی «پیشدستی در رد توطئه» (Prebunking) عمل کرد. در واقع، AI کاربران را آموزش داد تا بهطور کلی نسبت به روایتهای توطئه بدبینتر باشند، حتی برای رویدادهایی که هرگز با هوش مصنوعی درباره آنها بحث نکرده بودند. این اثر در طول زمان باقی ماند، هرچند برای حادثه تیراندازی در شهر گرند بلانک (حمله به کلیسا و آتشسوزی که دو هفته و نیم پس از قتل کرک رخ داد) تکرار نشد.
اما این قدرت، یک شمشیر دو لبه است. محققان هشدار دادند که همین سازوکار میتواند برعکس عمل کند و از گفتگوهای مشابه برای متقاعد کردن مردم به باورهای توطئهآمیز در بحرانهای جدید استفاده شود. این موضوع بهویژه برای توطئههای نوظهوری که در آنها حقایق کمی در دسترس است، یک ریسک سوءاستفاده جدی محسوب میشود. برای کاربر عادی، این یعنی هوش مصنوعی دیگر فقط جایگزینی برای جستوجو نیست، بلکه ابزاری قدرتمند برای تغییر ساختار شناختی است.
پژوهشگران پیش از این دریافتند که گفتگو با GPT-4 میتواند باور به تئوریهای توطئه تثبیتشده را حدود ۲۰ درصد کاهش دهد و این اثر تا دو ماه باقی بماند. بر اساس بررسی منابع متعدد، موفقیت مدل در اینجا مدیون ترفندهای زبانی «شیک» نبود، بلکه حجم بالای ادعاهای مستند بود که در قالب یک رابط طبیعی ارائه شد. مطالعه دیگری با حضور نزدیک به ۷۷ هزار شرکتکننده نیز تأیید کرد که گفتگوهای مدلهای زبانی ۴۱ تا ۵۲ درصد متقاعدکنندهتر از پیامهای متنی کوتاه هستند. همین سازوکار در یک آزمایش غیررسمی در دانشگاه زوریخ روی کاربران ردیت (Reddit) نیز مشاهده شد.
اگرچه این مطالعه یک مورد خاص (Case Study) است، اما ثابت میکند که «رسانه ارائه» — یعنی گفتگو در مقابل متن — به اندازه خودِ حقایق اهمیت دارد. چالش اصلی همچنان این است که چگونه میتوان مردم را در وهله اول ترغیب کرد تا با هوش مصنوعی وارد این گفتگوها شوند.
گام بعدی شما
- برای به چالش کشیدن پیشفرضهای خود، از مدلهای زبانی بخواهید با متد «پرسشگری سقراطی» (Socratic Questioning) با شما بحث کنند.
- هنگام مواجهه با اخبار جنجالی، به جای جستوجوی تکبعدی، از AI بخواهید شواهد متضاد را در قالب یک گفتگو به شما ارائه دهد.
- مراقب روایتهای تعاملی باشید؛ به یاد داشته باشید که قدرت متقاعدکنندگی AI میتواند برای ترویج روایتهای نادرست نیز به کار رود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو