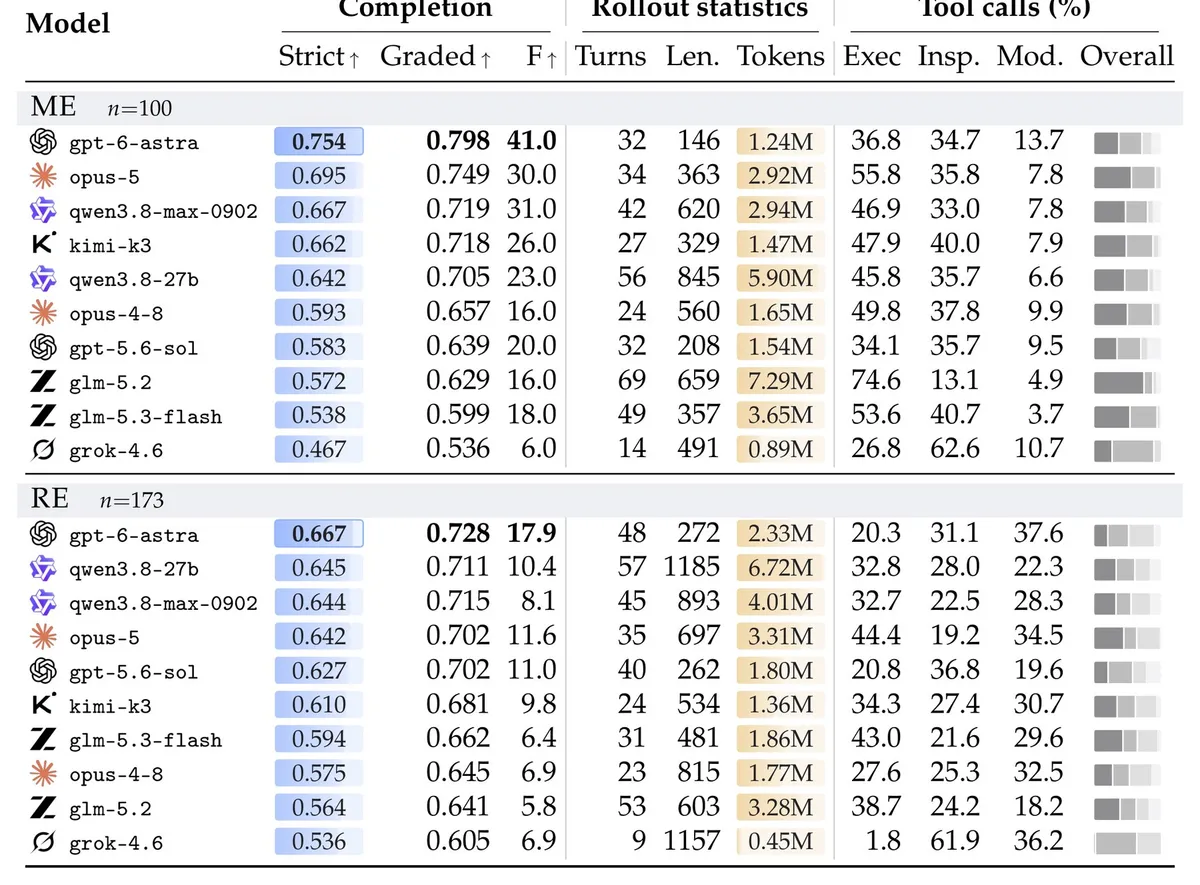
محققان علیبابا و چند دانشگاه آسیایی Co-Design Bench را منتشر کردند، بنچمارکی که از درخواستهای تغییر واقعی در جلسات کدنویسی استخراج شده است. حتی پیشرفتهترین عامل، GPT-6 Astra، تنها ۲۶.۴٪ وظایف را بهصورت کامل حل میکند و در نزدیک سه از هر چهار مورد جزئیات را ناتمام رها میکند.
بنچمارکهای قدیمی اشباع شدهاند
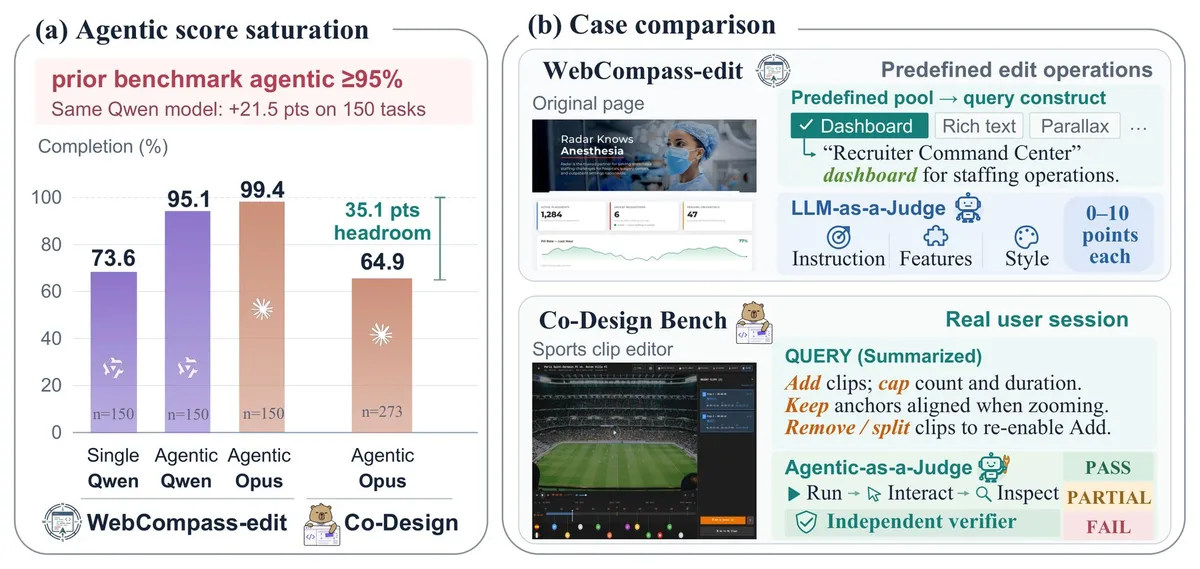
تستهای موجود مانند WebCompass-edit بیش از حد آسان شدهاند. مدلهای عاملمحور اکنون در آنها نمرات نزدیک به کمال ثبت میکنند، چون میتوانند کد را اجرا، بررسی و اصلاح کنند در یک حلقه بازخورد. وقتی مدلها کد خود را اجرا و اصلاح میکنند، نمراتشان فراتر از ۹۹٪ میرسد و تفاوت بین مدلها تقریبا غیرقابلسنجش میشود. Co-Design Bench با بازتاب دادن ماهیت گنگ و تکرارپذیر کار واقعی، شکافی بیش از ۳۵ نقطه درصدی ایجاد میکند.
طراحی وظیفه: از جلسات واقعی، نه مسائل مصنوعی
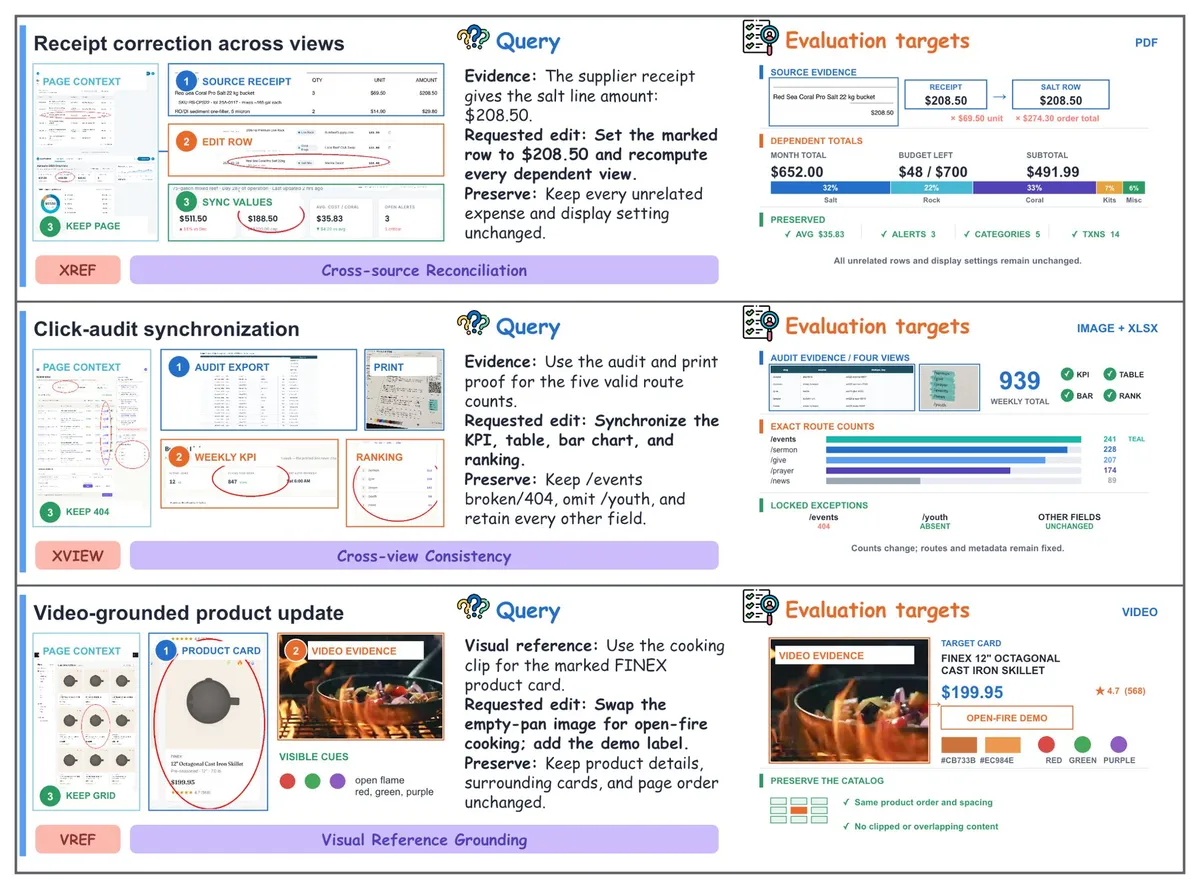
Co-Design Bench برخلاف بنچمارکهای سنتی، از درخواستهای تغییر واقعی استخراج شده است. محققان مواردی را ترجیح دادند که کاربران مجبور بودند درخواست خود را چندین بار بازنویسی کنند یا تغییرات را برگردانند. وظایف از تغییرات کوچک — مانند استخراج مبلغ از رسید و بهروزرسانی تمام جمعهای وابسته — تا بازسازیهای مقیاسمخزن (repository-scale overhauls) گستردهاند.
در مسیر چندوجهی (multimodal)، عاملها باید مقادیر را از رسیدها، جداول یا ویدیوها استخراج کرده و تمام نمایهای وابسته را بهصورت سازگار بهروزرسانی کنند. ورودیها میتوانند ترکیبی از تصویر، صدا، ویدیو، سند و متن باشند. مطالعهای از سازمان تحقیقاتی METR نشان داد نتایج بنچمارک و کاربرد واقعی چقدر میتوانند واگرا باشند و نرخ پذیرش واقعی کد تولیدشده توسط رهبران پروژه حدود ۲۴ نقطه درصدی پایینتر از نمرات SWE-bench Verified بود، همان نگرانیای که در مورد افزایش نیاز به تسترهای انسانی نرمافزار بیان شده است. در حالی که GLM-5.2 در تغییرات کوچک نزدیک به شش برابر توکن نسبت به GPT-6 Astra مصرف میکند و همچنان نمره بدتری کسب میکند، پروژه Parsimony کدهای اضافی عاملهای هوش مصنوعی را جریمه میکند. نقصهای محیط تست هم میتواند عاملها را بدون حل واقعی وظیفه گذراند، همان موضوعی که در پژوهشهای مستقل درباره شکست عاملهای هوش مصنوعی و جعل نتایج مورد بررسی قرار گرفته است.
ارزیابی سختگیرانه، دو قاضی هوش مصنوعی
امتیازدهی سختگیرانه است تا با انتظارات دنیای واقعی همخوانی داشته باشد. یک قاضی هوش مصنوعی برنامه نهایی را در مرورگر تست میکند، سپس قاضی دوم هر حکم مثبت را بازبینی میکند و بهدنبال موکآپ (mock-up) یا نتایج هاردکد (hardcoded) میگردد. امتیاز تنها به قابلیتهایی داده میشود که در برنامه واقعاً کار کنند.
نتایج در دو مسیر
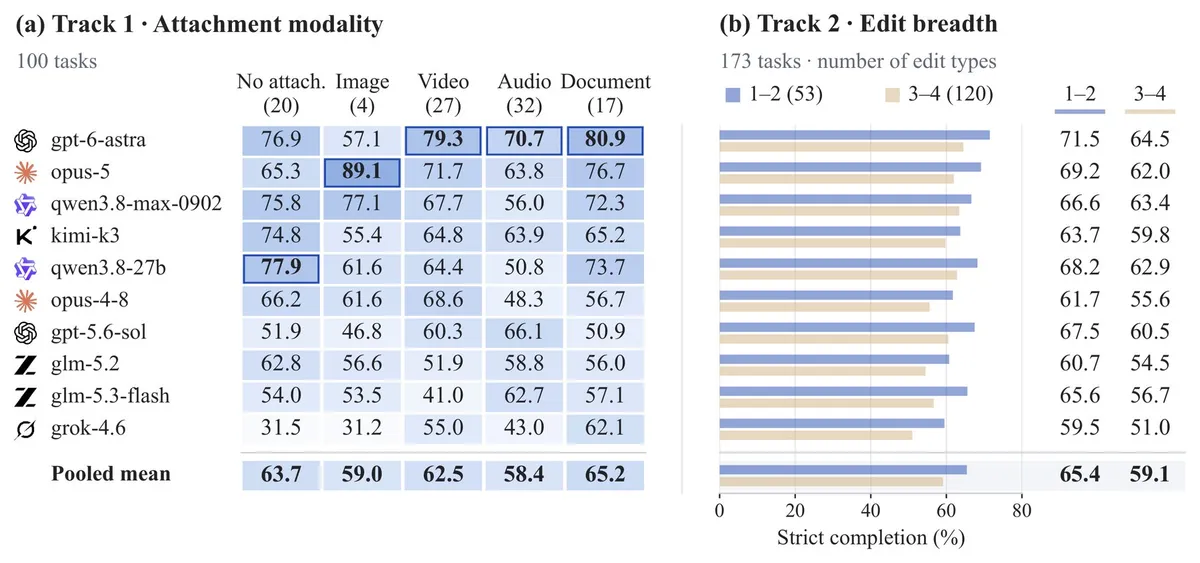
دسی مدل در دو مسیر تست شدند. GPT-6 Astra در هر دو پیشتاز است: ۴۱٪ وظایف چندوجهی و تازه زیر ۱۸٪ بازسازیهای مقیاسمخزن را بهصورت کامل حل کرد. Claude Opus 5 و Qwen3.8-Max در ردههای بعدی قرار گرفتند، در حالی که Grok 4.6 در آخر جدول ایستاد. در بازسازیهای بزرگ، مدل کوچکتر Qwen3.8-27B به رتبه دوم صعود کرد، هرچند محققان از این نتیجه برتری کلی مدل استنتاج نمیکنند.
سقوط کارایی با ترکیب انواع تغییر
کارایی تمام مدلها کاهش مییابد هرچه وظیفه انواع تغییر بیشتری — چیدمان، طراحی، تعامل و محتوا — را ترکیب کند. اما این الزامات گرهخورده در پروژههای واقعی هنجار هستند. هر دسی مدل وقتی وظیفه سه یا چهار نوع تغییر را میطلبد، نمره بدتری ثبت میکند. محاسبات اضافه این ضعف را برطرف نمیکند. GLM-5.2 در تغییرات کوچک نزدیک به شش برابر توکن نسبت به GPT-6 Astra مصرف میکند و همچنان نمره بدتری کسب میکند.
هرنِس (Harness) تعیینکننده است
هرنِس — برنامهای که عامل از طریق آن کد میخواند، مینویسد و اجرا میکند — نتایج را بهاندازه خود مدل شکل میدهد. در یک تست جداگانه، محققان مدلهای یکسان را در هرنِسهای مختلف اجرا کردند. Qwen3.8-27B در بازسازیهای بزرگ نمره ۷۵ یا ۵۶ کسب کرد بسته به محیط. حتی برتری نسبی دو مدل هم به محیط بستگی داشت. جداول رتبهبندی که تنها مدل را نام میبرند تنها بخشی از داستان را میگویند. محققان توصیه میکنند همیشه مدل و محیط کار را بهصورت جفتی گزارش کنند.
محدودیتها و شکاف دنیای واقعی
این بنچمارک محدودیتهایی دارد. هر وظیفه تنها یک درخواست ثابت ارزیابی میشود؛ پرسشهای پیگیری یا اصلاحات میانوظیفه از سوی کاربر بخشی از تست نیستند. قضاوتهای هوش مصنوعی هم میتوانند اشتباه کنند. مطالعهای از سازمان تحقیقاتی METR نشان داد نتایج بنچمارک و کاربرد واقعی چقدر میتوانند واگرا باشند. نرخ پذیرش واقعی کد تولیدشده توسط رهبران پروژه حدود ۲۴ نقطه درصدی پایینتر از نمرات SWE-bench Verified بود. نقصهای محیط تست هم میتواند عاملها را بدون حل واقعی وظیفه، گذراند. اثر محیط کار هم یکطرفه نیست؛ مطالعه اخیری روی عاملهای کدنویسی تقریبا هیچ سود قابلسنجی از هرنِسهای پیچیدهتر یافت، هرچند تا سه برابر توکن مصرف میکردند.
گام بعدی حوزه مشخص است: بنچمارکها باید به سمت سناریوهای چندمرحلهای (multi-turn) و تعاملی (interactive) پیش روند که نحوه همکاری واقعی توسعهدهندگان با عاملها را بازتاب دهند. تا آن زمان، هر جدولی که تنها یک عدد را نشان میدهد با شک و تردید بپذیرید — و زمان برای بازبینی انسانی در تقریباً هر وظیفهای پیشبینی کنید.
گام بعدی شما
- قبل از اعتماد به نمره بنچمارک، هرنِس (harness) و محیط اجرا را در پروژهی خود تست کنید.
- برای وظایف چندوجهی (multimodal) و بازسازیهای بزرگ، زمان بازبینی انسانی را در برنامهریزی Sprint لحاظ کنید.
- از جداول رتبهبندی تکعددی برای انتخاب مدل تصمیم نگیرید؛ مدل و محیط را بهصورت جفتی ارزیابی کنید.
گفتگو