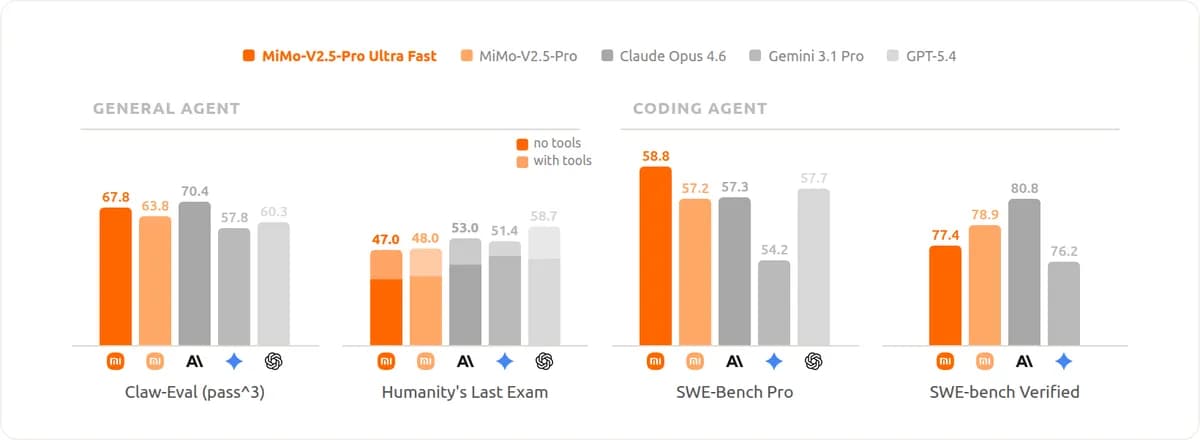
اگر در حال ساخت عاملهای هوش مصنوعی در زمان واقعی هستید، گلوگاه تأخیر همین حالا از بین رفت. شیائومی توانسته است یک مدل ۱ تریلیون پارامتری را به سرعت تولید ۱۰۰۰ توکن در ثانیه (tps) برساند. در ۸ ژوئن ۲۰۲۶، این شرکت مدل MiMo-V2.5-Pro-UltraSpeed را منتشر کرد. طبق اعلام این شرکت، سرعت خام اکنون هوش مصنوعی را از ابزاری که باید منتظرش بمانید، به افزونهای در زمان واقعی برای تفکر انسانی تبدیل میکند. این سرعت اجازه میدهد مدل در لحظه پاسخ دهد، فوراً تکرار کند و بدون هیچ اصطکاکی همکاری کند.
برای اکثر توسعهدهندگان، مدلهای تریلیون-پارامتری برای استفاده تعاملی بسیار کند هستند و اغلب برای یک پاسخ پیچیده، چندین ثانیه تأخیر دارند. این تأخیر باعث ایجاد چرخه «منتظر باش و دعا کن» میشود؛ جایی که کاربر امیدوار است همان تکپاسخ تولید شده درست باشد. شیائومی با شکستن سد ۱۰۰۰ توکن در ثانیه، قصد دارد پارادایم را به سمت استدلال موازی و تکرار آنی تغییر دهد. وقتی مدلی به اندازه کافی سریع باشد، دیگر یک ابزار نیست، بلکه بخشی از تفکر شما میشود.
به نقل از گزارش رسمی در mimo.xiaomimimo.com، این عملکرد از طریق یک «طراحی مشترک» سختافزاری-نرمافزاری عمیق بین تیم MiMo و TileRT (یک سامانه استنتاج تخصصی) به دست آمده است. برخلاف رقبایی مثل Groq که از معماری سفارشی SRAM روی تراشه استفاده میکند یا Cerebras که بر یکپارچگی Wafer-Scale متکی است، شیائومی این سرعت را روی GPUهای تجاری استاندارد و تنها با یک گره ۸-GPU معمولی به دست آورده است.
موتور فنی: کوانتیزاسیون و DFlash
برای حذف گلوگاههای پهنای باند حافظه که در مدلهای ۱ تریلیون پارامتری رایج است، شیائومی دو تغییر الگوریتمی اصلی ایجاد کرد. در مقیاس تریلیون پارامتر، استنتاجهای سنتی ۸ بیتی (FP8/INT8) یا ۱۶ بیتی، اثرپای حافظه (Memory Footprint) بسیار زیاد و فشار شدیدی به پهنای باند وارد میکنند. کاهش عرض بیت پارامترها، مستقیمترین راه برای افزایش سرعت رمزگشایی است.
- کوانتیزاسیون انتخابی FP4: تیم از فرمت کوانتیزاسیون MXFP4 (اعشاری ۴ بیتی) استفاده کرد که بهطور گسترده اعتبارسنجی شده و عملاً بدون افت کیفیت است. برای جلوگیری از تخریب در استدلالهای پیچیده، منطق و تولید کد، آنها FP4 را بهصورت ساده روی کل مدل اعمال نکردند. در عوض، آنها بهصورت انتخابی فقط بخشهای MoE (مخلوط متخصصان) را کوانتیزه کردند؛ زیرا این بخش از معماری، اکثریت قریب به اتفاق پارامترها را تشکیل میدهد و بیشترین تحمل را در برابر کوانتیزاسیون دارد. با استفاده از آموزش آگاه از کوانتیزاسیون (FP4 QAT) و حفظ دقت اصلی برای تمامی ماژولهای دیگر، آنها بهرهوری پهنای باند سختافزار را به حداکثر رساندند در حالی که تواناییهای مدل را با مدل اصلی برابر نگه داشتند.

- رمزگشایی گمانهزن DFlash: در رمزگشایی گمانهزن سنتی، یک مدل پیشنویس کوچک توکنها را حدس میزند و مدل بزرگ آنها را تأیید میکند. این امر تضادی ایجاد میکند که در آن یک مدل پیشنویس قویتر، سربار محاسباتی را افزایش میدهد. شیائومی این بنبست را با DFlash شکست؛ یک روش نوآورانه پیشبینی موازی ماسکشده در سطح بلوک. در اینجا مدل گمانهزن بهجای پیشبینی خودرگرسیونی (Autoregressive)، یک بلوک کامل از جایگاههای ماسکشده را در یک گذر پیشرو پر میکند و محدودیتهای سریالی را از بین میبرد.
جزئیات پیادهسازی DFlash
برای بهینهسازی DFlash در مدلهای MoE مقیاس تریلیون و سناریوهای با متن طولانی، شیائومی مکانیزمهای خاصی را اجرا کرد:
تراز SWA: مدل گمانهزن منحصراً از توجه پنجره لغزان (SWA) استفاده میکند. این کار با طراحی سری MiMo-V2 تراز است و وابستگی به پیشوندهای کامل را حذف میکند. این تغییر باعث میشود محاسبات هر پیشبینی از حالت خطی (نسبت به طول متن) به حالت ثابت تبدیل شود.
نمونهبرداری تکه محلی: در طول آموزش، نمونهبرداری سیگنال ماسک به تکههای محلی GPU منتقل شده است. این یعنی یک توالی میتواند دهها هزار سیگنال آموزشی مستقل را در جایگاههای متنوع متن در یک مرحله تولید کند، بدون اینکه نیاز به ارتباط بین دستگاهها (Cross-device communication) باشد.
ابزارهای بهینهسازی: تیم از بهینهساز درجه دوم Muon و تقطیر مدل (Self-distillation) استفاده کرد تا اطمینان حاصل شود که بلوکهای ماسک فشرده، نرخ پذیرش بالایی دارند در حالی که سربار مرحله پیشنویس در حداقل تئوریک باقی بماند.
محدودیت اندازه بلوک: اندازه بلوک برای کاهش سربار تأیید و افزایش همروندی به ۸ محدود شده است. این امر اجازه میدهد طول پذیرش بالا مستقیماً به افزایش نرخ خروجی (Throughput) تبدیل شود.
در سناریوهای با ارزش بالا، DFlash بازدهی را بهشدت افزایش میدهد. نتایج طول پذیرش توکنها را نشان میدهد:
- برنامهنویسی: ۶.۳۰ (بیشینه ۷.۱۴)
- ریاضی و استدلال: ۵.۵۶
- عامل (Agent): ۴.۲۹
در برنامهنویسی، یعنی ۶ تا ۷ توکن از هر ۸ توکن گمانهزنی شده در هر دور تأیید پذیرفته میشوند. با این حال، شیائومی اشاره میکند که در گفتگوهای عمومی با عدم قطعیت بالا و واگرایی معنایی، نرخ پذیرش در حال حاضر کمتر است و نیاز به بهینهسازیهای بیشتر دارد.
TileRT: عصر فشار بر GPU
در حالی که الگوریتمها بار را کم میکنند، سامانه TileRT اجرا را بهینه میکند. در سرعت ۱۰۰۰ توکن در ثانیه، چرخه عمر هر عملگر به میکروثانیه میرسد. سامانههای سنتی از «شکافهای اجرایی» رنج میبرند؛ تأخیرهای میکروثانیهای ناشی از اجرای عملگرها، همگامسازی سختافزاری و رفتوبرگشتهای حافظه جهانی که جریان اجرا را تکهتکه میکند.
TileRT این مشکل را با یک هسته موتور پایدار (Persistent Engine Kernel) حل میکند. این رویکرد الگوی سنتی اجرای تکتک عملگرها را بهطور کامل کنار میگذارد و کل خط لوله محاسباتی را بهصورت پایدار در GPU نگه میدارد و در آن جاری میکند. این کار اجازه پیشخوانی مداوم کل خط لوله را میدهد: در حالی که یک Tile در حال محاسبه روی هستههای تنسور است، دادههای بعدی از پیش در سلسلهمراتب حافظه در جریان هستند و به همپوشانی شدید بین جابجایی داده و محاسبه دست مییابند.
علاوه بر این، TileRT از تخصصیسازی Warp (همکاری خط لوله ناهمگن) استفاده میکند. این روش، ارتباطات، جابجایی دادهها و محاسبات تنسور را به قطعات ریزتر تقسیم میکند. با شکستن مدل اجرای همگام و یکنواخت، گروههای مختلف رشتهها (Warps) و دامنههای اجرایی ناهمگن در سراسر GPU بهطور مستقل اما با هماهنگی دقیق عمل میکنند. این کار GPU را به یک سامانه اجرایی ناهمگن تبدیل میکند که بهطور دقیق سازماندهی شده است.
همگرایی عمیق سختافزار و نرمافزار
این عملکرد نتیجه همگرایی در مقیاس میکروثانیه بین تیم TileRT و تیم MiMo است. آنها مرزهای سنتی لایههای نرمافزاری را شکستند تا رفتار مدل با خط لوله با تأخیر بسیار کم تراز شود. این مهندسی مشترک شامل موارد زیر بود:
- کامپایل سفارشی: TileRT یک موتور کامپایل و هستههای محاسباتی مخصوص ارائه داد که بهطور ویژه برای خط لوله کوانتیزاسیون FP4 و رمزگشایی گمانهزن DFlash بهینه شده بودند.
- تبادلات فیزیکی: هر دو تیم بر اساس فیزیک سختافزار، تبادلات مهندسی عمیقی انجام دادند تا اطمینان حاصل شود فشار اجرا بهطور نرم در مرزهای سختافزاری بسته میشود.
تیم TileRT یک تیم معماری سامانههای پیشرو است که بر شکستن موانع سنتی ذخیرهسازی-محاسبه متمرکز است. هدف آنها ممکن ساختن پاسخهای میلیثانیهای برای مدلهای بزرگ پیشرو در محیطهای عملیاتی از طریق پیشرفتهای تمامعیار در هستههای پایدار و خط لولههای Tile است.
اثرات واقعی و دسترسی
شیائومی استدلال میکند که ۱۰۰۰ توکن در ثانیه فقط بحث بهرهوری نیست، بلکه کلاس جدیدی از برنامهها را ممکن میکند. این شرکت سه مورد استفاده اصلی را برجسته میکند:
۱. عاملهای برنامهنویسی پیشرفته: توسعهدهندگان دیگر منتظر استریم شدن بلوکهای طولانی کد نمیمانند؛ تولید کد تقریباً آنی میشود و گلوگاه تأخیر استنتاج از بین میرود.
۲. حلقههای تصمیمگیری در زمان واقعی: این سرعت اجازه میدهد مدلهای ۱ تS در سناریوهای حساس به زمان وارد شوند، مانند تولید سیگنالهای معاملاتی کمّی فرکانس بالا، شناسایی آنی کلاهبرداری یا مناقصات هوشمند.
۳. کمکهای پزشکی حیاتی: در محیطهای جراحی، تحلیل ضایعات و پیشبینی ریسک در سطح میلیثانیه میتواند دادههای حیاتی را در زمان واقعی به جراح ارائه دهد. در موقعیتهای مرگ و زندگی، هر ثانیه ذخیرهشده، بردی در رقابت با مرگ است و به جراح آزادی عمل بیشتری میدهد.


دسترسی به API UltraSpeed در حال حاضر محدود و مبتنی بر درخواست است. از ۹ تا ۲۳ ژوئن ۲۰۲۶، تا ساعت ۲۳:۵۹ (به وقت پکن، UTC+8 / ۰۸:۵۹ PDT)، شرکتهای تأییدشده و توسعهدهندگان حرفهای میتوانند از طریق platform.xiaomimimo.com/ultraspeed به این API دسترسی داشته باشند. قیمت تشویقی ۳ برابر هزینه مدل استاندارد MiMo-V2.5-Pro است، در حالی که سرعت تولید تقریباً ۱۰ برابر است. طرحهای توکنی (Token Plans) برای این نسخه پشتیبانی نمیشوند.
برای کاربران تأییدشده، دسترسی رایگان به چت در ultraspeed.xiaomimimo.com در این بازه دو هفتهای فراهم است. برای رعایت عدالت در محدودیت منابع، هر حساب به ۱۰ ورودی در صف در روز محدود شده و جلسات پس از ۵ دقیقه بیکاری بهطور خودکار بسته میشوند و منابع آزاد میگردند.
تحلیل: تغییر به سمت «سرعت به مثابه هوش»
این پیشرفت فرض بنیادی را که مدلهای بزرگتر باید کندتر باشند، تغییر میدهد. با treating سرعت به عنوان جایگزینی برای عمق، شیائومی به سمت معماری استدلال «بهترین از N» (Best-of-N) یا جستجوی درختی حرکت میکند. وقتی مدلی میتواند دهها مسیر استدلالی را در زمانی که قبلاً برای تولید یک مسیر صرف میشد تولید کند، میتواند بهطور خودکار منطق خود را در پسزمینه تأیید و اصلاح کند و مستقیماً کیفیت استدلال را ارتقا دهد.
برای کاربر تجاری، این بدان معناست که «هزینه به ازای هر توکن» دیگر تنها معیار مهم نیست. وقتی مدلی میتواند چندین فرضیه را فوراً بررسی کند، «هزینه به ازای هر تصمیم درست» کاهش مییابد. همچنین، تکیه بر GPUهای تجاری بهجای سختافزارهای عجیب و غریب نشان میدهد که این سطح از عملکرد میتواند در سراسر زیرساختهای ابری موجود دموکراتیزه شود.
برای حمایت از جامعه، شیائومی چکپوینت MiMo-V2.5-Pro-FP4-DFlash را در HuggingFace (huggingface.co/XiaomiMiMo/MiMo-V2.5-Pro-FP4-DFlash) بهصورت بازمتن منتشر کرده است و وزنهای کوانتیزه شده FP4 و پارامترهای مدل DFlash را برای آزمایشهای عمومی فراهم کرده است. توسعهدهندگان و پژوهشگران اکنون باید رصد کنند که آیا این رویکرد رمزگشایی گمانهزن میتواند نرخ پذیرش خود را در سناریوهای گفتگوهای عمومی و واگراتر (که در حال حاضر نرخهای پایینتری نسبت به کدنویسی یا ریاضی دارند) حفظ کند یا خیر.



گفتگو