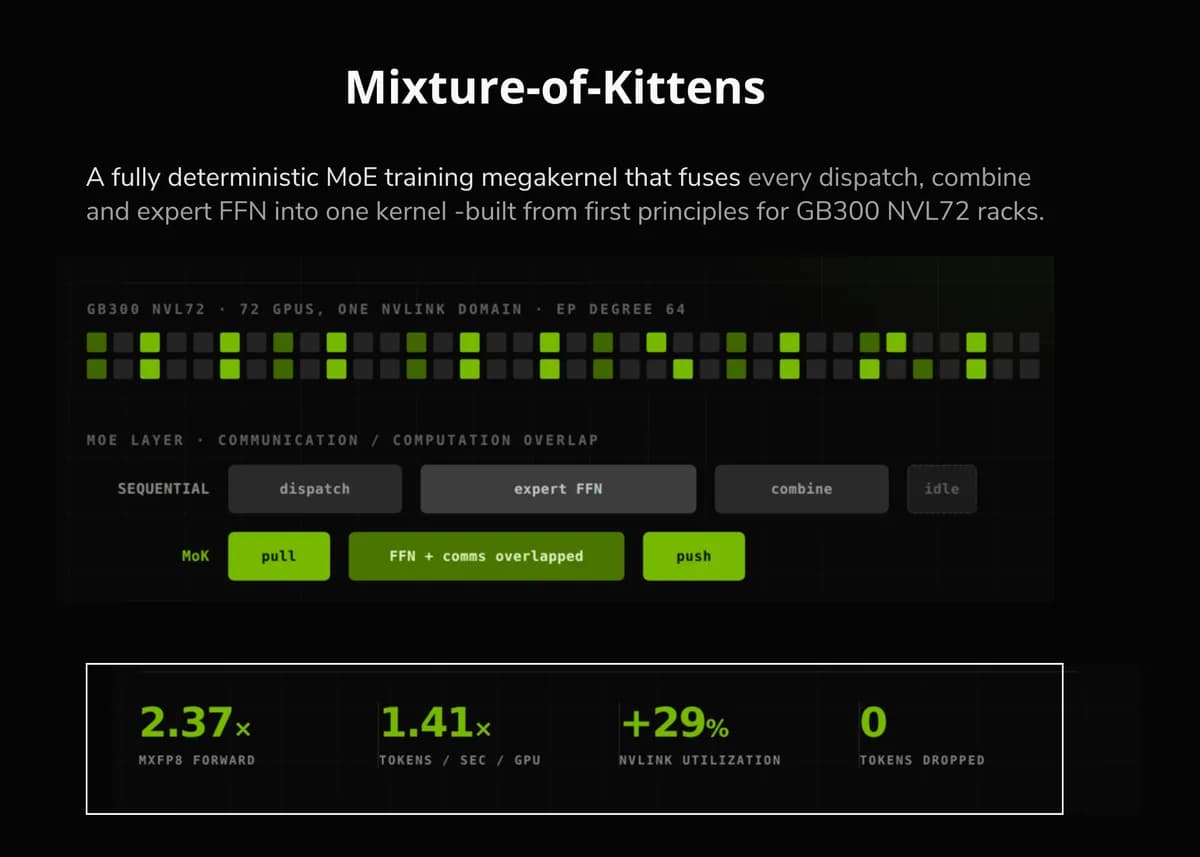
آموزش مدلهای پیشرو دیگر یک مسئلهٔ محاسباتی نیست، بلکه یک جنگ برای مدیریت ترافیک داده است. اگر از زیرساختهای Blackwell استفاده میکنید، باید بدانید که تأخیر در جابهجایی توکنها بین GPUها اکنون بزرگترین مانع پیش روی شماست. برای حل این گلوگاه، Cursor Research ابزار Mixture-of-Kittens (MoK) را معرفی کرده است؛ یک مگاکرنل (Megakernel) قطعی برای آموزش که بهطور اختصاصی برای رَکهای NVIDIA Blackwell GB200 و GB300 NVL72 طراحی شده است.
طبق اعلام کرسور (Cursor)، در معماریهای ترکیب خبرهها (Mixture-of-Experts یا MoE)، لایه ارتباطی — یعنی جابهجایی توکنها بین GPUها برای رسیدن به خبره درست — میتواند بیش از ۵۰٪ از کل زمان آموزش را ببلعد. این چالشهای بهینهسازی در معماریهای خبرهمحور، مشابه مواردی است که در رکوردهای عملکردی مدل Instella-MoE شرکت AMD مشاهده شد، جایی که مدیریت بهینه وزنها کلید دستیابی به بالاترین ردههای عملکردی بود. در حالی که دامنه NVLink در یک رَک ۷۲ گرافیکی اجازه همپوشانی (Overlap) دقیقی را میدهد، اما CPUهای Grace بهشدت کندتر از GPUها هستند. این تفاوت سرعت باعث ایجاد یک وقفه در همگامسازی (Synchronization Lag) میشود که در نهایت توان عملیاتی (Throughput) کل سیستم را نابود میکند.
زمینه: حل گلوگاه MoE
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازیهای سطح هسته اشاره کردیم، تمرکز پیشین کرسور روی بخش محاسبات بود. این تلاشها شامل توسعه هستههای آموزشی MXFP8 و NVFP4 و همچنین ایجاد یک مسیر «رمزگشایی وارپ» (warp decode) برای استنتاج MoE بود. با این حال، تمامی این راهکارها بر این فرض استوار بودند که ارتباطات بین-گرافیکی بهطور جداگانه مدیریت میشوند. در محیط عملیاتی و تولیدی، مشخص شد که همین بخش ارتباطات، عامل محدودکننده و اصلی است.
انتقال به رَکهای GB300 NVL72 مسئله را دوباره تغییر داد. هر رَک شامل ۷۲ پردازنده گرافیکی در یک دامنه واحد NVLink است. اگرچه این ساختار امکان همپوشانی ریزدانه را فراهم میکند، اما به دلیل اینکه CPUهای یکپارچه Grace در مقایسه با GPUها کند هستند، همگامسازی CPU-GPU باید بهطور تهاجمی به حداقل برسد تا از اتلاف زمان جلوگیری شود. این نیاز به همگامسازی دقیق، یادآور مکانیسمهای مدیریت گرههای جایگزین در PyTorch برای کاهش زمان توقف آموزش در مقیاسهای بزرگ است.
بر اساس گزارش فنی Cursor، راهکار MoK این مشکل را با ادغام (Fuse) تمام مراحل ارتباطی و محاسباتی در یک تکهسته (Megakernel) حل میکند. تغییر کلیدی در اینجا، جایگزینی روش «توزیع فشار-محور» (Push-based) با «توزیع کشش-محور» (Pull-based) برای پاسهای رفت (Forward Passes) است. در حالی که روشهای سنتی مانند DeepEP از انتقالهای Push استفاده میکنند، میکروبنچمارکهای کرسور نشان میدهند که روش Push بایتهای کمتری را در یک جهت جابهجا میکند و در نتیجه مسیر معکوس NVLink را تا حد زیادی بیکار میگذارد. در مقابل، توزیع Pull-based در زمان عدم توازن خبرهها (Expert Imbalance)، بهرهوری پهنایباند NVLink را تا ۲۹٪ افزایش میدهد.

این چرخش معماری، سربار سیگنالدهی را بهشدت کاهش میدهد. طبق دادههای منتشر شده، زمان سیگنالدهی در روش Push حدود ۱۰۳ میکروثانیه اندازهگیری شده بود، اما در رویکرد Pull-based در MoK، این مقدار به ۱۸ میکروثانیه کاهش یافته است که نشاندهنده یک بهبود ۵.۸ برابری است. این سامانه از یک بافر حلقوی توکن (Ring Token Buffer) منحصربهفرد استفاده میکند که چند صد مگابایت داده را در سطح مینیبچ میچرخاند و بهطور مؤثر CPU را بهطور کامل از چرخه خارج میکند.
جزئیات فنی مکانیزم MoK
کتابخانه MoK برای بهینهسازی توان عملیاتی از چندین تصمیم طراحی خاص بهره میبرد:
- ارتباط ترکیبی (Hybrid Communication): MoK از توزیع Pull-based برای پاس رفت (Forward Dispatch) و Push-based برای ترکیب رفت (Forward Combine) استفاده میکند. پاس برگشت (Backward Pass) نیز دقیقاً عکس این روند است و از Pull Reverse-Combine و Push Reverse-Dispatch بهره میبرد. یک جدول زمانبندی واحد تمام این چهار عملیات را مدیریت میکند که هزینه محاسباتی آن کمتر از ۳٪ زمان اجرای MoE است.
- دانه-بندی همپوشانی (Overlap Granularity): این سیستم حد وسطی بین رویکردهای ریزدانه (مانند Comet) و درشت-دانه (مانند DeepEP) است. MoK از یک روش اکتشافی (Heuristic) استفاده میکند تا برای هر GEMM گروهبندیشده با خبرهها، حداقل دو موج کامل SM هدف قرار گیرد. برای ابعاد مدل Kimi 2.5 (که پایه Composer 2.5 است)، این حد پایین ۲,۳۶۸ توکن است.
- منطق بافر حلقوی (Ring Buffer Logic): برای جلوگیری از ریزش توکنها یا تکیه بر سایزبندی بافر توسط CPU، MoK یک بافر حلقوی ثابت را میچرخاند. این سیستم توزیع و ترکیب را در مرزهای ماکروبچ در هم میتند و برای به حداقل رساندن بازپخش فعالسازهای رفت (Forward Activation Replay) در طول پاس برگشت، بافر حلقه را بهصورت معکوس پیمایش میکند.
- دقت و زمانبندی (Precision and Scheduling): این مگاکرنل از دقتهای BF16 و MXFP8 پشتیبانی میکند. اجرای آن از طریق Cluster Launch Control در سختافزار Blackwell صورت میگیرد تا اطمینان حاصل شود که RDMAهای بین-رکی بهصورت سریال پشت آن قرار نمیگیرند. علاوه بر این، گرادینتهای وزنهای روتر (Router Weight Gradients) با استفاده از محاسبات سبک SonicMoE در پاس برگشت SwiGLU ادغام شدهاند.
الزامات فنی این کتابخانه که تحت لایسنس Apache-2.0 منتشر شده، بسیار سختگیرانه است:
- پردازندههای NVIDIA Blackwell SM100 یا SM103 (بهطور خاص رکهای GB200 NVL72 یا GB300 NVL72)
- کیت CUDA 13.0 یا بالاتر
- PyTorch 2.10+ و پایتون 3.12+
- قابلیت حافظه متقارن (Symmetric Memory) در PyTorch برای بافرهای بین-گرافیکی

نتایج و بنچمارکها
نتایج بنچمارات ثبت شده در یک رَک واحد NVL72 با درجه EP برابر ۶۴، دستاوردهای قابلتوجهی را نشان میدهد. در این تستها، هر GPU پیش از مسیریابی (Routing)، ۲۰۴۸ توکن را در اختیار داشت. تیم کرسور عملکرد MoK را در برابر خطبارهای مختلفی از جمله NCCL+PyTorch، DeepEP+PyTorch، DeepEP+TransformerEngine و HybridEP+Megatron در مدلهایی مانند Kimi K2.7 Code، GLM-5.2، Qwen3.5-397B-A17B و DeepSeek-V4-Pro آزمایش کرد.
برای پاسهای رفت با دقت MXFP8، مدل MoK تا ۲.۳۷ برابر سریعتر از قویترین خطبارهای عمومی موجود عمل کرد. سایر بهبودها شامل افزایش ۱.۷۸ برابری برای پاس برگشت MXFP8، بهبود ۱.۹۲ برابری برای پاس رفت BF16 و افزایش ۱.۵۸ برابری برای پاس برگشت BF16 است. در تستهای سراسری (End-to-End) با استفاده از ۵۱۲ پردازنده گرافیکی در چندین رَک GB300 NVL72، میزان توکن در ثانیه برای هر GPU از ۷۶۰.۹ به ۱٬۰۷۰.۲ رسید که نشاندهنده یک افزایش کلی ۱.۴۱ برابری در توان پردازشی است.
برای جامعه فنی، این دستاورد این فرض را که همگامسازی CPU-GPU یک «مالیات اجتنابناپذیر» و همیشگی در آموزش مدلهای MoE است، میشکند. با انتقال زمانبندی به Cluster Launch Control در Blackwell و استفاده از یک مگاکرنل قطعی، کرسور ثابت کرد که ارتباطات را میتوان تقریباً بهطور کامل پنهان کرد. این موضوع بهویژه برای مدلهایی با معماری DeepSeek-V3 و آموزشهای RL پساز-آموزش (On-policy RL) که قطعیت (Determinism) در آنها برای تحلیلهای داخلی (Ablations) حیاتی است، بسیار ارزشمند است. این پیشرفت برای صنایعی مانند تحقیقات کمی (Quantitative Research)، ابزارهای تولید کد و زیرساختهای ابری GPU بسیار مرتبط است.
با این حال، کف سختافزاری این ابزار بهشدت بالاست. به دلیل تکیه بر نسخههای خاص SM در Blackwell و ظرفیتهای خاص رَکهای NVL72، این ابزار برای تیمهایی که تنها ۸ گرافیک دارند یا در سطح تک-گره (Single-node) فعالیت میکنند، عملاً بیفایده است. بهرهمندی از MoK محدود به آزمایشگاههای پیشرو (Frontier Labs)، استارتاپهای مدلساز با بودجههای کلان، Neocloudهای گرافیکی و مراکز محاسباتی ملی است که در حال حاضر در حال استقرار زیرساختهای GB300 هستند. در این رقابت سختافزاری، حتی رقبایی مانند AMD با معماری MI355X در برابر Blackwell تلاش میکنند تا با تکیه بر شاخص قیمت به عملکرد، جایگاه خود را در آموزش مدلهای عظیم تثبیت کنند.
گام بعدی شما
- مهندسان زیرساخت و توسعهدهندگان میتوانند اکنون پیادهسازی MoK را از طریق گیتهاب دسترسی داشته باشند تا خط لولههای پیشآموزش MoE خود را بهینهسازی نمایند.
- بررسی سازگاری حافظه متقارن (Symmetric Memory) در نسخههای جدید PyTorch برای استقرار بهینه در کلاسترهای Blackwell.
- تحلیل اثر حذف کامل CPU از چرخه توزیع توکنها بر پایداری آموزش در مقیاسهای بسیار بالا (بیش از ۵۱۲ GPU).
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره معماری تراشههای Blackwell و ارتباط آنها با پهنایباند حافظه مراجعه کنید.



گفتگو