تصور کنید صاحب یک کسبوکار کوچک غذای خانگی هستید و در ساعت ۱ بعدازظهر، تلفن شما از تماس مشتریان عصبانی که میپرسند «غذای من کی میرسد؟» قطع نمیشود. شاید ساعت ۱۲ باران شروع شده باشد، یکی از پیکهای شما تازهکار باشد و هشت سفارش بهطور همزمان ارسال شده باشند. اگر هنوز برای مدیریت ارسالها به حافظه یا اکسلهای ساده تکیه میکنید، ابزار DabbaETA میتواند این آشفتگی را با پیشبینی دقیق تأخیرها به پایان دهد.
طبق اعلام توسعهدهنده، این دستیار دیسپچینگ که در ۱۷ اکتبر ۲۰۲۶ منتشر شد، اجازه میدهد صاحبان کسبوکارهای خرد بدون آپلود حتی یک آدرس مشتری در فضای ابری، تأخیرات ارسال را پیشبینی کنند. DabbaETA ترکیبی از یادگیری ماشین جدولی (Tabular ML) و مدلهای زبانی بزرگ محلی (Local LLMs) است تا مشکل «غذای من کجاست» را برای کسبوکارهای بسیار کوچک حل کند.
در حالی که ابزارهای بهینهسازی ارسال برای غولهایی مثل Swiggy ساخته شدهاند و نیاز به اشتراکهای ماهانه SaaS و آپلود دادهها در فضای ابری دارند، DabbaETA محاسبات را به لپتاپی منتقل میکند که مالک کسبوکار از قبل دارد. برای یک آشپزخانه کوچک با ۴۰ سفارش، آپلود شماره تلفن و آدرس خانگی در یک API ناشناس، هم یک ریسک امنیتی برای حریم خصوصی است و هم یک بار مالی. با این رویکرد، نیاز به پرداخت صورتحسابهای متغیر API حذف میشود.
همانطور که در تحلیلهای قبلی ما دربارهی رایانش لبه (Edge Computing) اشاره کردیم، انتقال پردازش از سرورهای مرکزی به دستگاه کاربر، کلید حل مشکل حریم خصوصی در مدلهای هوش مصنوعی است. اکثر مالکان کوچک ماهها تاریخچه ارسالات خود را در یک دفترچه یا صفحه گسترده (Spreadsheet) ذخیره کردهاند، اما هرگز از این دادهها برای پیشبینی گلوگاهها استفاده نکردهاند، زیرا آنها تیمهای متخصص یادگیری ماشین (ML) که پلتفرمهای بزرگ دارند را در اختیار ندارند. DabbaETA این قابلیت را بهصورت محلی فراهم میکند و تضمین میکند که دادههای مشتری در جای خود باقی بماند و هرگز به یک API مدل زبانی نرسد.
این سامانه از یک خط لولهی هماهنگ از ابزارهای محلی استفاده میکند:
- TabPFN: هستهی پیشبینی است که زمان رسیدن (ETA) را محاسبه کرده و ریسک تأخیر را با برچسبهای «بالا» (HIGH)، «متوسط» (MODERATE) یا «پایین» (LOW) مشخص میکند.
- Gemma: یک مدل زبانی بزرگ (LLM) — شبیه کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — که از طریق Ollama روی همان ماشین اجرا میشود تا پرسوجوهای متنی را پاسخ دهد و پیشنویس پیامهای مشتری را بنویسد. این رویکرد استفاده از مدلهای محلی برای کسبوکارهای خرد، مشابه پروژه Parchi است که با مدل Gemma 4 مدیریت صورتحسابهای دستی مغازههای کوچک را خودکار کرد.
- SQLite: برای ذخیرهی محلی تاریخچهی ارسالهای CSV پس از اینکه مالک فایل را آپلود کرد.
- Temporal: مدیریت جریان کاری «اجرای صبحگاهی» را بر عهده دارد. این ابزار یک مرحله پیشبینی را با چندین فراخوانی LLM زنجیر میکند. اگر Temporal در دسترس نباشد، اپلیکیشن به حالت اجرای داخلی (In-process run) باز میگردد.
- Sentry: تأخیر و تعداد توکن (Token) — تکههای کوچکی از متن، مثل برشهای یک کیک طولانی که مدل تکهتکه میخورد — را برای هر فراخوانی مدل ردیابی میکند. بازههای سفارشی (Custom spans) برای
llm.gemmaوtabpfn.predictتعریف شده تا مقادیرlatency_ms(تأخیر میلیثانیهای)،tokens_in(توکنهای ورودی) وtokens_out(توکنهای خروجی) را ثبت کنند.
بر اساس مستندات فنی، گردش کار دیسپچینگ با یک کلیک روی دکمه "Run dispatch" آغاز شده و یک جریان کاری Temporal شامل پنج فعالیت اصلی را اجرا میکند:
۱. load_orders: استخراج دادهها از فایل محلی SQLite.
۲. predict_all: محاسبه ETA برای تمام سفارشات در انتظار.
۳. flag_risky: شناسایی سفارشاتی که ریسک تأخیر بالایی دارند.
۴. explain: استفاده از Gemma برای شناسایی گلوگاههای خاص.
۵. draft_messages: استفاده از Gemma برای ایجاد اعلانهای اطلاعرسانی به مشتریان.
موتور پیشبینی این ابزار پشت یک رابط به نام BasePredictor قرار دارد. این ساختار هم از API tabpfn-client و هم از پکیج محلی tabpfn پشتیبانی میکند. بنابراین، تغییر وضعیت به حالت کاملاً آفلاین بهجای بازنویسی کد، تنها با یک تغییر ساده در تنظیمات (Config) امکانپذیر است. تنها دادهای که هرگز از ماشین خارج میشود، جدولی از اعداد است که شامل مسافت، ترافیک، وضعیت آبوهوا و زمان آمادهسازی است.
عامل Gemma در این سیستم بهجای تکیه بر فراخوانی توابع داخلی (Native tool-calling) که در مدلهای محلی کوچک میتواند ناپایدار باشد، طوری هدایت (Prompt) شده است که رشتههای JSON را در قالب {"tool": ..., "args": ...} تولید کند. سپس یک لایه استخراج با Regex و یک حلقه تلاش مجدد (Retry loop)، این درخواستها را به سه ابزار خاص هدایت میکند:
predict_eta: محاسبه زمان رسیدن برای یک سفارش خاص.list_risky_orders: شناسایی اینکه کدام ارسالها احتمالاً دیر میرسند.draft_message: تولید یک اعلان مودبانه.
این قابلیت به مالک کسبوکار اجازه میدهد به زبان ترکیبی (Hinglish) بپرسد: «Aaj kaunsi orders late hongi?» (امروز کدام سفارشات دیر میرسند؟). سیستم سفارشات پرریسک را شناسایی کرده و پیشنویس پیامهای تأخیر را به زبانهای هندی، انگلیسی یا Hinglish آماده میکند تا کاربر آنها را در واتساپ کپی کند.
برای سنجش عملکرد، توسعهدهنده از ۵,۰۰۰ سفارش مصنوعی بر اساس مجموعهداده Kaggle Food Delivery Times استفاده کرد. این دادهها شامل متغیرهایی مانند مسافت، ترافیک، آبوهوا، نوع وسیله نقلیه، زمان آمادهسازی، تجربه پیک، شلوغی عصرگاهی و اثرات فصل مونسون (بارانهای شدید) بود.
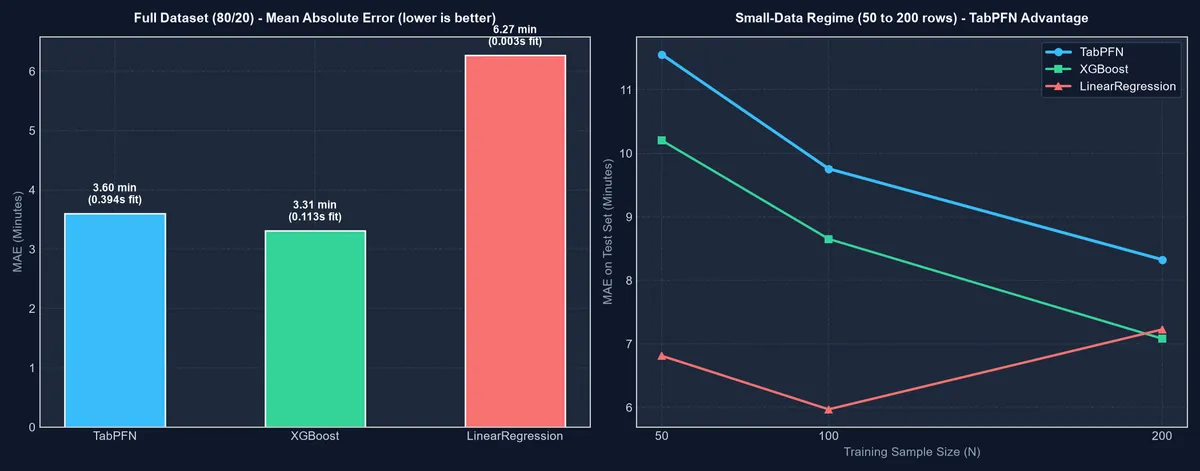
به گزارش dev.to، نتایج بنچمارک برای مجموعهداده کامل (۴,۰۰۰ مورد برای آموزش و ۱,۰۰۰ مورد برای تست) به شرح زیر بود:
- TabPFN: میانگین خطای مطلق (MAE) ۳.۶۰، RMSE ۶.۰۵ و R² برابر ۰.۹۳۷ (زمان برازش: ۰.۳۹ ثانیه).
- XGBoost: میانگین خطای مطلق (MAE) ۳.۳۱، RMSE ۵.۲۲ و R² برابر ۰.۹۵۳ (زمان برازش: ۰.۱۱ ثانیه).
- Linear Regression: میانگین خطای مطلق (MAE) ۶.۲۷، RMSE ۱۰.۱۵ و R² برابر ۰.۸۲۲ (زمان برازش: ۰.۰۰۳ ثانیه).
در حالی که XGBoost در مواجهه با هزاران ردیف داده برنده است، اما یک مالک کسبوکار کوچک معمولاً تنها چند هفته تاریخچه دارد. اسکریپت بنچمارک آزمایشهایی را روی دادههای کوچک (۵۰، ۱۰۰ و ۲۰۰ ردیف آموزشی) نیز انجام داد. از آنجایی که زمان ارسال به تعاملات پیچیده (مسافت × ترافیک × آبوهوا) بستگی دارد، رویکردهای مبتنی بر درخت (Tree-based) بسیار بهتر از رگرسیون خطی عمل میکنند. رابط BasePredictor به کاربر اجازه میدهد اگر حجم دادههایش زیاد شد، تنها با یک خط کد به XGBoost سوییچ کند.
این پروژه نشان میدهد که برای کسبوکارهای با حاشیه سود پایین، مانند یک نانوایی محلی یا سرویس غذای خانگی، مدل «هوش مصنوعی به عنوان سرویس» (AIaaS) بهدلیل هزینهی هر توکن، غیرمنطقی است. تبدیل هوش مصنوعی به یک «ابزار کاربردی» (Utility) که تنها هزینه آن راهاندازی اولیه است، مانع ورود این لایه فناوری به بازارهای خرد را میشکند.
علاوه بر این، این ابزار «شکاف اعتماد» در پذیرش هوش مصنوعی را برطرف میکند. مالکان کسبوکارهای کوچک اغلب نسبت به حاکمیت دادههای خود حساس هستند. با تضمین اینکه اطلاعات شناسایی شخصی (PII) روی دیسک باقی میماند و تنها جداول عددی پردازش میشوند، مانع اصلی ورود کاربر حذف میشود. همچنین، استفاده از یک متغیر محیطی (OLLAMA_MODEL) به این معناست که مالک میتواند بدون دست زدن به کد، مدل خود را به مدل بهتری که پشتیبانی زبان هندی قویتری دارد ارتقا دهد و از وابستگی به یک فروشنده خاص (Vendor lock-in) جلوگیری کند.
البته این سیستم محدودیتهایی دارد؛ دادههای دمو مصنوعی هستند، بنابراین دقت در دنیای واقعی ممکن است متفاوت باشد. همچنین کلید API رایگان TabPFN غیرتجاری است، به این معنی که برای فروش این ابزار، لایسنس تجاری از Prior Labs مورد نیاز است. علاوه بر این، در حالی که Gemma برای پیشنویسهای کوتاه مؤثر است، در گرامر زبان هندی بینقص نیست و کاربر باید پیامها را پیش از ارسال بازبینی کند.
توسعهدهنده هنوز کاربر paying (پرداختکننده) جذب نکرده و قصد دارد سیستم را روی فایل CSV یک مالک واقعی تست کند تا نقاط شکست آن را بیابد. بهروزرسانیهای آینده بر افزودن ویژگیهای سطح پیک (Rider-level)، ساخت جریان ارسال تککلیکی در واتساپ و اجرای بازآموزی (Retraining) خودکار با ثبت هر ارسال جدید متمرکز خواهد بود.
گام بعدی شما
- اگر دادههای ارسال خود را در CSV دارید، از مدلهای محلی برای شناسایی الگوهای تأخیر استفاده کنید.
- برای کاهش هزینهها، جایگزینی APIهای ابری با مدلهای کوانتیده شده روی Ollama را بررسی کنید.
- برای کسبوکارهای محلی، روی ابزارهایی تمرکز کنید که دادههای حساس را هرگز از دستگاه خارج نمیکنند.
اما داستان سختافزاری اجرای مدلهای محلی روی لپتاپهای معمولی حتی شگفتانگیزتر است — به تحلیل ما دربارهی شتابدهندههای NPU در پردازندههای جدید مراجعه کنید.



گفتگو