اگر امروز برای استخراج دادههای ساختاریافته از اسناد حجیم روی مدلهای تجاری حساب میکنید، باید بدانید که یک مدل وزنباز (Open Weights) اکنون در این حوزه استانداردهای جدیدی تعریف کرده است. مدل Darwin-180B-RSI با تصاحب رتبه اول در ۱۰ بنچمارک (Benchmark) رسمی Hugging Face، نشان داد که تمرکز صنعت از نمرات آزمونهای آکادمیک به سمت حل مسائل واقعی دنیای کسبوکار در حال چرخش است. این دستاورد که در ۶ اکتبر ۲۰۲۶ توسط وبسایت dev.to گزارش شد، سیگنالی از تغییر رویکرد کلی در توسعه مدلهاست.
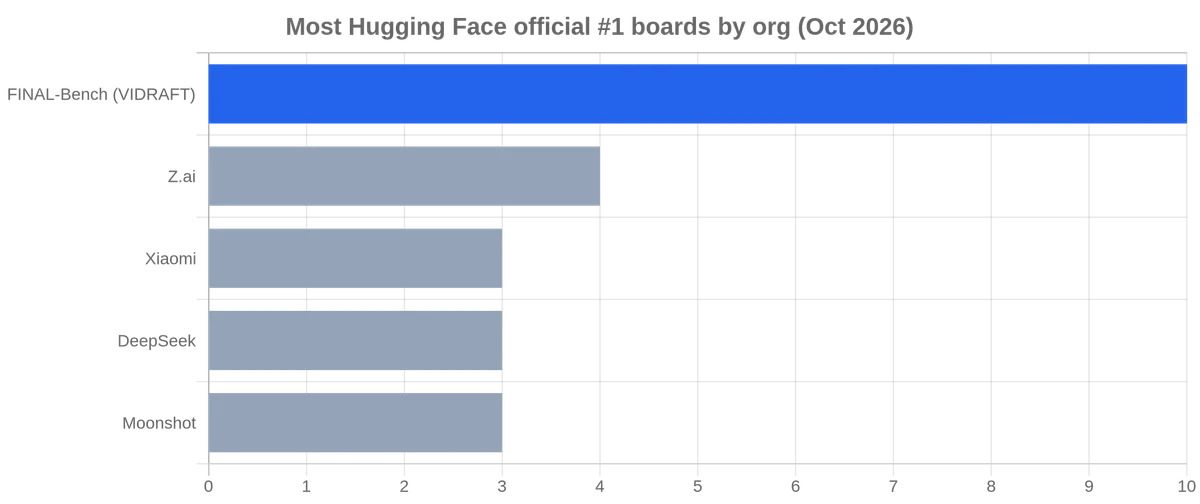
در میان ۹۵ سازمان شرکتکننده، شکاف عملکردی بسیار چشمگیر است: این مدل بیشترین تعداد رتبههای اول را در ۴۸ محک ارزیابی منتخب کسب کرده است، در حالی که نزدیکترین رقیب آن در رده دوم، تنها ۴ رتبه اول در اختیار دارد. این تفاوت نشان میدهد که Darwin-180B-RSI نه تنها پیشتاز است، بلکه فاصله زیادی با سایر رقبا ایجاد کرده است.
بسیاری از پیروزیها در جداول ردهبندی بهطور سنتی به استدلالهای سبک آزمونی پاداش میدهند. اما آخرین موفقیتهای بازوی پژوهشی VIDRAFT با نام FINAL-Bench، دقیقاً روی نقاط اصطکاک و چالشهایی تمرکز دارد که تیمهای فنی هنگام استقرار هوش مصنوعی در محصولات واقعی با آن مواجه میشوند: خروجی دادههای ساختاریافته و تجزیه و تحلیل اسناد طولانی. این تغییر رویکرد بازتابدهنده یک درک گستردهتر در صنعت است؛ این ایده که «ضریب هوشی» (IQ) یک مدل اگر نتواند یک طرحواره (Schema) سختگیرانه JSON را دنبال کند یا یک فیلد خاص را از یک فایل PDF ۱۹۰ صفحهای استخراج کند، عملاً بیفایده است.
همانطور که در تحلیل قبلی ما دربارهی مدلهای استدلالی و نسخههای کوانتایز شده (Quantization) برای لپتاپها اشاره کردیم، دادههای جدید تأیید میکند که قابلیتهای استدلالی این مدل به حوزههایی منتقل شده که هرگز بهطور صریح برای آنها آموزش ندیده است. این مدل بر پایه Qwen3.8-Flash-Next شرکت علیبابا ساخته شده، اما برتری فعلی آن بیش از آنکه به وزنهای پایه مربوط باشد، نتیجهی حلقه آموزش خاص آن است.
تسلط بر وظایف سازمانی و محکهای ارزیابی
مهمترین پیروزیهای این مدل در وظایفی است که مستقیماً با نیازهای سازمانی گره خوردهاند. بر اساس مستندات، در محک IFStruct (ارائه شده توسط Liquid AI) که سختگیری در رعایت ساختارهای JSON و YAML را میسنجد، Darwin-180B-RSI امتیاز ۹۸.۹۵ را کسب کرد و ۱۹۷۹ مورد از ۲۰۰۰ مورد را بهدرستی پاسخ داد. این عدد بهطور قابلتوجهی بالاتر از مدلهای پیشین پیشتاز مانند Agents-A1 (۹۳.۲۵)، gpt-oss-20b (۹۱.۹۵) و Nemotron-3-Nano-30B (۸۶.۸۰) است. در یک خط لوله تولیدی که در آن یک برنامه باید خروجی مدل را بخواند تا مرحله بعد را اجرا کند، حتی یک کاراکتر اشتباه یا یک فیلد گمشده میتواند کل فرآیند را متوقف کند؛ بنابراین رعایت دقیق ساختار (Schema Adherence) یک پیشنیاز حیاتی برای پذیرش مدل در محیطهای عملیاتی است.
در زمینه تحلیل اسناد، نسخه Darwin-180B-RSI-R3 در محک ExtractBench متعلق به LlamaIndex امتیاز ۹۰.۲۹ را به دست آورد. این آزمون شامل ۳۷۰ فایل PDF بود که حجم آنها از چند صفحه تا تقریباً ۱۹۰ صفحه متغیر بود. این نتیجه حتی از مدل پایه خود یعنی Qwen3.8-Flash-Next که امتیاز ۸۹.۸۸ را کسب کرده بود، پیشی گرفت.
علاوه بر وظایف سازمانی، این مدل در چندین حوزه سخت آکادمیک نیز پیشتاز است. این نتایج صرفاً پیروزیهای اتفاقی در حوزههای محدود (Thin-field) نیستند؛ زیرا مدل در شلوغترین جداول ردهبندی، یعنی MMLU-Pro (با ۱۴۱ مدل شرکتکننده) و GPQA (با ۱۱۱ مدل شرکتکننده)، رتبه اول را در اختیار دارد:
- علوم و دانش: GPQA Diamond (۹۴.۴۴) و MMLU-Pro (۸۸.۱۲)
- ریاضیات: AIME ۲۰۲۶ (۱۰۰) و HMMT ۲۰۲۶ (۱۰۰)
- حقوق: LEXam (۶۸.۹۴) و LEXam-hard (۴۵.۷۲)
- تحلیل اسناد: MDPBench (۸۳.۶۵)
- استدلال بصری: MMMU-Pro (۷۹.۴۸)
این عملکرد خیرهکننده در ریاضیات، تداوم موفقیتهای اخیر این مدل است که پیشتر به عنوان نخستین مدل با امتیاز ۱۰۰٪ در AIME معرفی شد و استانداردهای جدیدی برای استدلال پیچیده تعریف کرد.
سازوکار: بهبود خودکار بازگشتی (RSI)
به نقل از گزارش dev.to، این مدل بهطور خاص برای متون حقوقی یا استخراج داده از PDF تنظیم دقیق (Fine-tuning) نشده است. در عوض، از روش بهبود خودکار بازگشتی (Recursive Self-Improvement یا RSI) در سطح مدل استفاده میکند. در این روش، مدل مسائل قابلراستیآزمایی را بهطور مستقل حل میکند و تنها پاسخهایی را نگه میدارد که از نظر ریاضی یا منطقی درست هستند.
مدل با آموزش روی این مجموعه دادههای فیلترشده و تولیدشده توسط خودش، عادتهای استدلالی را تقویت میکند بدون اینکه خطاهای خود را تکرار یا تقویت کند. این رویکرد در واقع پیادهسازی عملی استراتژی «افزایش بودجه تفکر» است که برای رفع خطاهای توکنی در استدلالهای پیچیده به کار گرفته شده. از آنجا که در این حلقه نیازی به پاسخهای نوشتهشده توسط انسان یا راهکارهای گامبهگام انسانی نیست، مدل هوش خود را از طریق خوداصلاحی مقیاس میکند. موفقیت در حوزههای حقوق و استخراج داده، یک سیگنال قابل مشاهده است که نشان میدهد عادتهای استدلالی کلی، به حوزههای تخصصی منتقل میشوند.
باید توجه داشت که نمرات جداول ردهبندی بازتابدهنده نحوه ارزیابی و ارسال هر بنچمارک است. از آنجا که هر جدول ردهبندی روش نرمالسازی متفاوتی دارد، این رتبهها باید به عنوان یک «پورتفولیو از قابلیتها» دیده شوند، نه یک عدد واحد برای ضریب هوشی جهانی.
ZTC: داور بدون توکن
در کنار این مدل، VIDRAFT متد ارزیابی ZTC (Zero-Token Confidence) را برای عاملهای هوش مصنوعی (AI Agents) معرفی کرد. وقتی عاملها شروع به انجام کارهای حساسی مانند پرداخت وجه، ارسال ایمیل یا اجرای کد میکنند، شناسایی یک اقدام اشتباه پیش از اجرا، یک چالش مهندسی حیاتی است. حفاظهای (Guardrails) سنتی از مدل دومی میخواهند که نظر خود را بهصورت متنی بنویسد که این کار باعث افزایش تأخیر (Latency)، مصرف توکن و اغلب نیاز به ارسال دادهها به یک API خارجی میشود.
اما ZTC بهجای تولید متن، حالتهای نهان (Hidden States) داخلی مدلی که اقدام را تولید کرده است، تنها یک بار میخواند و احتمال درست بودن آن اقدام را محاسبه میکند. در این روش، تعداد توکنهای تولیدشده اضافی صفر است.
در یک تست رودررو روی محیط Gate Arcade (یک snapshot از استقرار شبکه بسته در ۲۴ سپتامبر ۲۰۲۶)، ZTC برتری چشمگیری در سرعت نشان داد:
- زمان داوری: ZTC برای هر فراخوانی ۰.۰۶۱۵ ثانیه زمان برد، در حالی که داور API خارجی (JEV) به ۰.۵۹۱ ثانیه نیاز داشت.
- توان عملیاتی (Throughput): ZTC در ۳۰۰ ثانیه ۱۷۷ داوری را انجام داد، در حالی که داور API تنها ۱۳۵ مورد را پردازش کرد.
- صحت: سطح زیر منحنی (AUC) برای ZTC (۰.۷۲۸۹) از نظر آماری با داور API (۰.۷۳۵۰) برابر بود.
در یک رقابت ۲۰۰۰ دورهای، ZTC بر اساس امتیاز ترکیبی سرعت و صحت، در ۷۳.۷ درصد دورها پیروز شد. با استفاده از این رویکرد، یک مدل مجزا توانست صحت داوری پاسخهای خودش را از ۰.۷۶ به ۰.۸۸ ارتقا دهد.
پیادهسازی ZTC و بستر عملیاتی
ZTC بهصورت محلی روی GPU اجرا میشود و دادهها هرگز شبکه را ترک نمیکنند. این ویژگی آن را برای استقرارهای ایزوله (Air-gapped) در بخشهای مالی، دفاعی یا دولتی ایدهآل میکند. این سیستم مانند یک گیت ارزانقیمت عمل میکند و تنها در موارد مشکوک و نامطمئن، اقدام را به بررسیهای سنگینتر سیاستگذاری (Policy Check) ارجاع میدهد.
مسیر فراخوانی مفهومی ZTC بهطور کامل از حلقه تولیدی عبور میکند:
۱. مدل یک گذر پیشرو (Forward Pass) برای بهدست آوردن لاجیتها (Logits) و حالتهای نهان انجام میدهد.
۲. اقدام کاندید از روی لاجیتها رمزگشایی میشود.
۳. یک لایه مخصوص (ztc_head) حالت نهان را برای تعیین سطح اطمینان میخواند.
۴. اگر اطمینان زیر حد آستانه باشد، اقدام متوقف میشود؛ در غیر این صورت اجرا میگردد.
این فناوری در فضای شلوغی از داورها وارد شده است. APIهای JEV شرکت Typesafe یک رابط استاندارد (de facto) ایجاد کردهاند، جدول عمومی Decision Index بیش از ۷۰ مدل را لیست کرده و Cloudflare اخیراً یک داور سازگار با JEV عرضه کرده که در چند روز ۱۱۰۰ لایک در Hugging Face گرفت. گروههای پژوهشی در استنفورد و انویدیا نیز مدلهای مشابهی منتشر کردهاند. تفاوت بنیادین ZTC در این است که بهجای اینکه از مدل بخواهد «صحبت کند»، مستقیماً «درون» مدل را میخواند.
تحلیل: بازتعریف کاربرد مدلها
برای جامعه فنی، این پیشرفت این فرض را تغییر میدهد که برای استخراج داده با عملکرد بالا یا استدلال حقوقی، حتماً به تنظیم دقیق (Tuning) دامنه خاص نیاز است. اگر RSI بتواند استدلالهای قابل انتقال تولید کند، ارزش مجموعهدادههای تخصصی که توسط انسان برچسبگذاری شدهاند، در مقایسه با ارزش مجموعههای مسائل قابلراستیآزمایی کاهش مییابد.
علاوه بر این، سازوکار ZTC «مالیات تأخیر» (Latency Tax) در ایمنی هوش مصنوعی را برطرف میکند. VIDRAFT با انتقال از داوریهای تولیدی به تحلیل حالتهای داخلی ثابت کرد که میتوانیم حفاظهای ایمنی را بدون قربانی کردن پاسخگویی آنی (Real-time) مورد نیاز برای عاملهای خودمختار حفظ کنیم.
این تغییر نشان میدهد که مرز بعدی مدلهای وزنباز، صرفاً افزایش تعداد پارامترها نیست، بلکه ایجاد حلقههای خوداصلاحی کارآمدتر و سیستمهای نظارتی غیرتولیدی است. برای مشاهده این قابلیتها در عمل، میتوانید نسخههای پایه و R3 را که تحت سازمان FINAL-Bench در Hugging Face منتشر شدهاند، بررسی کنید.



گفتگو