اگر امروز در حال طراحی یک خط لوله اتوماسیون هستید که خروجیهای مدل را مستقیماً به کد متصل میکند، احتمالاً با کابوس خطاهای JSON یا جداول بههمریخته آشنا هستید. مدل Darwin-180B-RSI دقیقاً برای پایان دادن به این خطاهای کوچک اما مرگبار طراحی شده است.
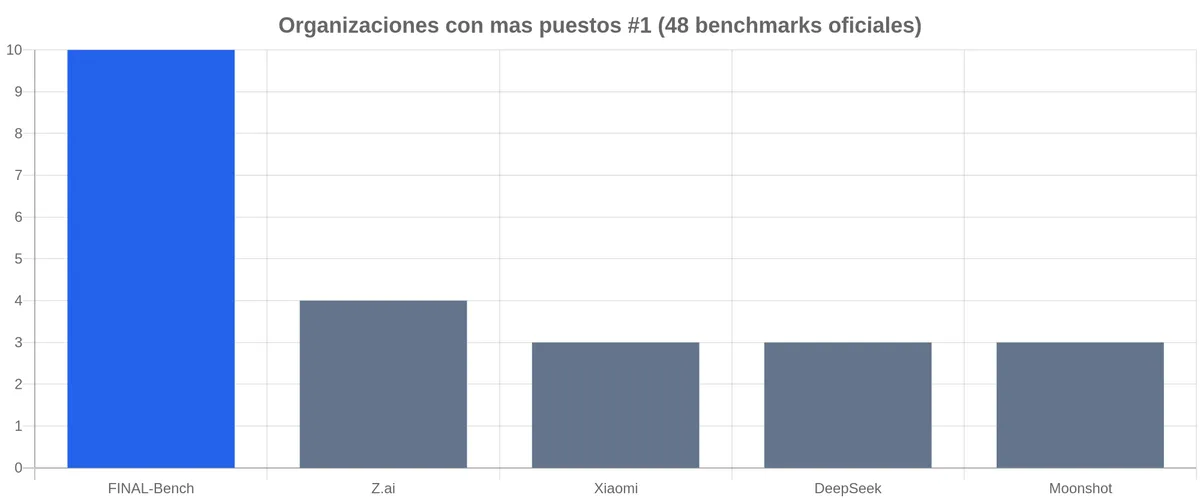
این مدل اکنون در ۱۰ مورد از ۴۸ محک رسمی Hugging Face رتبه اول را در اختیار دارد؛ رقمی که در میان ۹۵ سازمان شرکتکننده، بالاترین است. برای درک این فاصله، کافی است بدانید رتبه دوم (سازمان Z.ai) تنها در ۴ محک پیشتاز است. این دستاورد نشاندهنده یک چرخش استراتژیک است: عبور از مدلهایی که فقط در امتحانات آکادمیک نمره میگیرند و رسیدن به مدلهایی که قادر به اجرای کارهای واقعی در سطح تولید (Production) هستند.
همانطور که در تحلیلهای قبلی ما درباره تسلط سازمانهای چینی بر فهرستهای Hugging Face اشاره کردیم، این نقطه عطف جدید نیز متعلق به مدلی است که بر پایه Qwen3.8-Flash-Next از شرکت Alibaba ساخته شده است. در حالی که اکثر مدلها به دنبال نمرات بالا در ریاضیات یا علوم سطح دکترا هستند، Darwin روی مراحل «نامرئی» اتوماسیون هوش مصنوعی تمرکز کرده است: تجزیه، استخراج و قالببندی سختگیرانه.
چرخش به سمت محکهای «کار واقعی»
به نقل از گزارشی که در ۶ اکتبر ۲۰۲۶ منتشر شد، پیشتازی Darwin تنها در تعداد نیست، بلکه در حوزه کاربرد است. این مدل در آزمونهای پررقابتی مانند MMLU-Pro (با ۱۴۱ مدل ثبتشده) و GPQA (با ۱۱۱ مدل) برنده شده است؛ جایی که پیروزی بسیار دشوارتر از آزمونهای تخصصی و کوچک است.
در حالی که این مدل در حوزههای آکادمیک میدرخشد — کسب نمره ۱۰۰ در AIME ۲۰۲۶ و HMMT ۲۰۲۶ (ریاضیات)، ۹۴.۴۴ در GPQA Diamond و ۸۸.۱۲ در MMLU-Pro (علوم) — حیاتیترین پیروزیهای آن در سه دسته جدید «سازمانی» است که کارهای واقعی شرکتها را میسنجد. در این راستا، تحلیل دقیقتری درباره دلایل دستیابی Darwin به اولین نمره کامل در آزمون AIME پیشتر منتشر کردهایم.
- MDPBench (۸۳.۶۵): سنجش تجزیه اسناد چندزبانه. این محک توانایی تبدیل یک سند واقعی با جداول و سرتیترها به یک نمایش تمیز و قابل استفاده را میسنجد. این اولین قدم برای هر سامانه تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — است؛ اگر تجزیه اولیه شکست بخورد، تمام مراحل بعدی دچار خطا میشوند.
- IFStruct (۹۸.۹۵٪): تست توانایی تولید JSON یا YAML معتبر که دقیقاً از یک طرح (Schema) پیروی کند بدون استفاده از رمزگشاییهای محدود شده (restricted decoding). این محک انضباط خالص مدل را در شمارش دقیق عناصر، کلیدهای پوششی (wrapper keys) و طول لیستهای تو در تو میسنجد. هر فیلد اضافی که در طرح درخواست نشده باشد، منجر به شکست مدل میشود.
- ExtractBench (۹۰.۲۹): ارزیابی استخراج فیلدهای ساختاریافته از ۳۷۰ سند PDF. این اسناد از فرمهای کوتاه تا فایلهای نزدیک به ۲۰۰ صفحه را شامل میشوند. این نمره توسط نسخه دوم بهبود خودکار، یعنی Darwin-180B-RSI-R3 به دست آمده که از مدل پایه Qwen3.8-Flash-Next (۸۹.۸۸) پیشی گرفته است.
کالبدشکافی محدودیتهای IFStruct
در آزمون IFStruct، مدل Darwin از ۲۰۰۰ پرامپت، ۱۹۷۹ مورد را با موفقیت پاس کرد (با استفاده از مقادیر پیشفرض harness شامل دمای ۰، ۱۶ هزار توکن و فعال بودن استدلال). تنها یک مورد به دلیل اتمام زمان ۱۲۰ ثانیهای شکست خورد، بنابراین نمره ۹۸.۹۵٪ یک تخمین محافظهکارانه است.
این تست بسیار سختگیرانه است: تعداد دقیق عناصر (یا یک محدوده خاص)، وجود کلید پوششی درست و رعایت اینکه آیا یک بلوک کد مورد نیاز است یا ممنوع شده است را بررسی میکند. اگر مدل در جایی که ممنوع است کامنت اضافه کند، در رعایت Enums شکست بخورد یا از محدودیتهای عددی فراتر رود، جریمه میشود.
طبق بررسیها، وقتی قابلیت استدلال غیرفعال میشود، عملکرد مدل به ۸۹.۷٪ سقوط میکند. این یعنی فاز داخلی زنجیره تفکر (Chain-of-Thought) — مثل وقتی شاگرد ریاضی پای تخته بلند بلند فکر میکند تا به جواب برسد — همان چیزی است که تخلفات نهایی از قوانین را برطرف میکند. در مقایسه، مدلهایی مانند Agents-A1 (۹۳.۲۵٪)، gpt-oss-20b (۹۱.۹۵٪)، Nemotron-3-Nano-30B (۸۶.۸۰٪) و Granite 4.1 8B (۶۸.۴۵٪) از انضباط Darwin عقبتر هستند.
سازوکار: بهبود بازگشتی در سطح مدل (RSI)
مدل Darwin برای این پیشرفتها به دادههای برچسبگذاریشده توسط انسان تکیه نکرده است. در عوض، از بهبود بازگشتی در سطح مدل (Model-level Recursive Self-Improvement) استفاده میکند. این فرآیند یک حلقه سختگیرانه است که بدون دستورالعملهای داخلی یا هایپرپارامترهای خاص پیش میرود:
۱. مدل مسائلی را حل میکند که پاسخ آنها بهطور خودکار قابل تأیید است.
۲. تنها پاسخهایی که به عنوان «درست» تأیید شدهاند، نگه داشته میشوند.
۳. مدل با استفاده از این مجموعه داده پالایششده، دوباره آموزش میبیند.
۴. این فرآیند تکرار میشود.
به دلیل اینکه مدل هرگز از پاسخهای تأییدنشده یا غلط یاد نمیگیرد، خطاها تقویت نمیشوند. نکته جالب این است که تیم توسعهدهنده متوجه شد عادت به استدلال دقیق که در حین حل مسائل قابل تأیید شکل گرفته، به حوزههایی منتقل شده که مدل هیچ آموزش صریحی در آنها ندیده بود. البته این رویکرد بدون چالش نیست و برخی تحلیلها به موانع فنی اشاره دارند که ممکن است باعث توقف تکامل خودکار مدلها شوند.
این موضوع در عملکرد حقوقی مدل مشهود است، جایی که در محکهایی مانند LEXam (۶۸.۹۴) و LEXam-hard (۴۵.۷۲) و همچنین در استخراج اسناد پیشتاز است. مدل در واقع «چگونگی استدلال» را یاد گرفته و سپس آن را در زمینههای تخصصی حرفهای به کار برده است.
اعتماد صفر-توکنی (ZTC) برای عاملها
در کنار این مدل، تکنیک جدیدی به نام اعتماد صفر-توکنی (Zero-Token Confidence) در حال رایج شدن است. این روش که از طریق اپلیکیشن Gate Arcade در بخش «فضاهای هفته» Hugging Face (انتخاب شده در هفته ۲۸ سپتامبر از میان ۱.۵ میلیون اپلیکیشن) معرفی شد، یک مشکل حیاتی در عاملهای (Agents) هوش مصنوعی را حل میکند: تصمیمگیری برای اجرای یک اقدام، بدون تأخیر ناشی از حضور یک مدل «داور» دوم.
در حالی که APIهای JEV از شرکت Typesafe یک فرمت مرجع برای «شاخص تصمیمگیری» (Decision Index) ایجاد کردند که اکنون بیش از ۷۰ مدل را شامل میشود، ZTC مسیر متفاوتی را میرود. در ۳۰ سپتامبر، شرکت Cloudflare یک مدل داور سازگار با JEV معرفی کرد و تیمهایی از استنفورد و NVIDIA نیز مدلهای مشابهی را ارائه دادند. اما ZTC بهطور کلی از تولید متن اجتناب میکند.
به جای اینکه از یک AI دیگر بپرسد «آیا این پاسخ درست است؟» و منتظر دریافت متن بماند، ZTC حالت داخلی مدل تولیدکننده را میخواند تا احتمال صحت را محاسبه کند. این یعنی صفر توکن اضافی و افزایش شدید سرعت:
- تأخیر: ZTC برای هر قضاوت ۰.۰۶۱۵ ثانیه زمان میبرد، در حالی که JEV به ۰.۵۹۱ ثانیه نیاز دارد.
- توان عملیاتی: در ۳۰۰ ثانیه، ZTC تعداد ۱۷۷ مورد را پردازش کرد، در حالی که JEV تنها ۱۳۵ مورد را پیش برد.
- صحت: سطح زیر منحنی (AUC) برای ZTC برابر ۰.۷۲۸۹ است که از نظر آماری با ۰.۷۳۵۰ در JEV برابر است.
- نرخ پیروزی: در نبردی با ۲۰۰۰ راند، ZTC در ۷۳.۷٪ مواقع برنده شد.
پیامدهای عملیاتی
برای مهندسانی که خط لولههای عاملمحور میسازند، این نتایج محاسبات قابلیت اطمینان را تغییر میدهد. وقتی خروجی مدل توسط کد مصرف میشود (نه انسان)، یک کلید JSON اشتباه، یک کلید ساختگی یا یک جدول بد تجزیه شده، کل فرآیند را متوقف میکند. نمرات بالای Darwin در IFStruct و ExtractBench نشاندهنده مدلی است که واقعاً میتواند در محیط تولید دوام بیاورد.
علاوه بر این، ZTC اجازه میدهد قضاوتهای سریع در شبکههای ایزوله — مانند بانکداری، دفاع یا بخش دولتی — رخ دهد، زیرا دادهها هرگز GPU را ترک نمیکنند و نیازی به فراخوانی API خارجی نیست. این سیستم روی همان واحد پردازش گرافیکی (GPU) مدل اجرا میشود، مسیر رفت و برگشت به یک API خارجی را حذف میکند و هزینههای اضافی را تقریباً به صفر میرساند.
با اعمال ZTC، نسخه Darwin-397B-ZTC دقت خود-قضاوت را از ۰.۷۶ به ۰.۸۸ رساند. ترکیب بهبود بازگشتی و نظارت بر حالت داخلی نشان میدهد که مرز بعدی هوش مصنوعی، لزوماً مدلهای «باهوشتر» نیست، بلکه مدلهای «منضبطتر» هستند که میتوانند کار خود را در میلیثانیهها تأیید کنند.
گام بعدی شما
- اگر از مدلهای باز برای استخراج داده استفاده میکنید، معماری RSI را برای پالایش دادههای آموزشی خود بررسی کنید.
- برای کاهش تأخیر در سیستمهای عاملمحور، به جای مدلهای داور متنی، از روشهای تحلیل حالت داخلی (مانند ZTC) استفاده کنید.
- در طراحی پرامپتها، برای مدلهای استدلالی، محدودیتهای ساختاری (Schema) را بهصورت صریح تعریف کنید تا از قابلیتهای انضباطی مدل بهره ببرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما درباره تراشههای Blackwell مراجعه کنید.



گفتگو