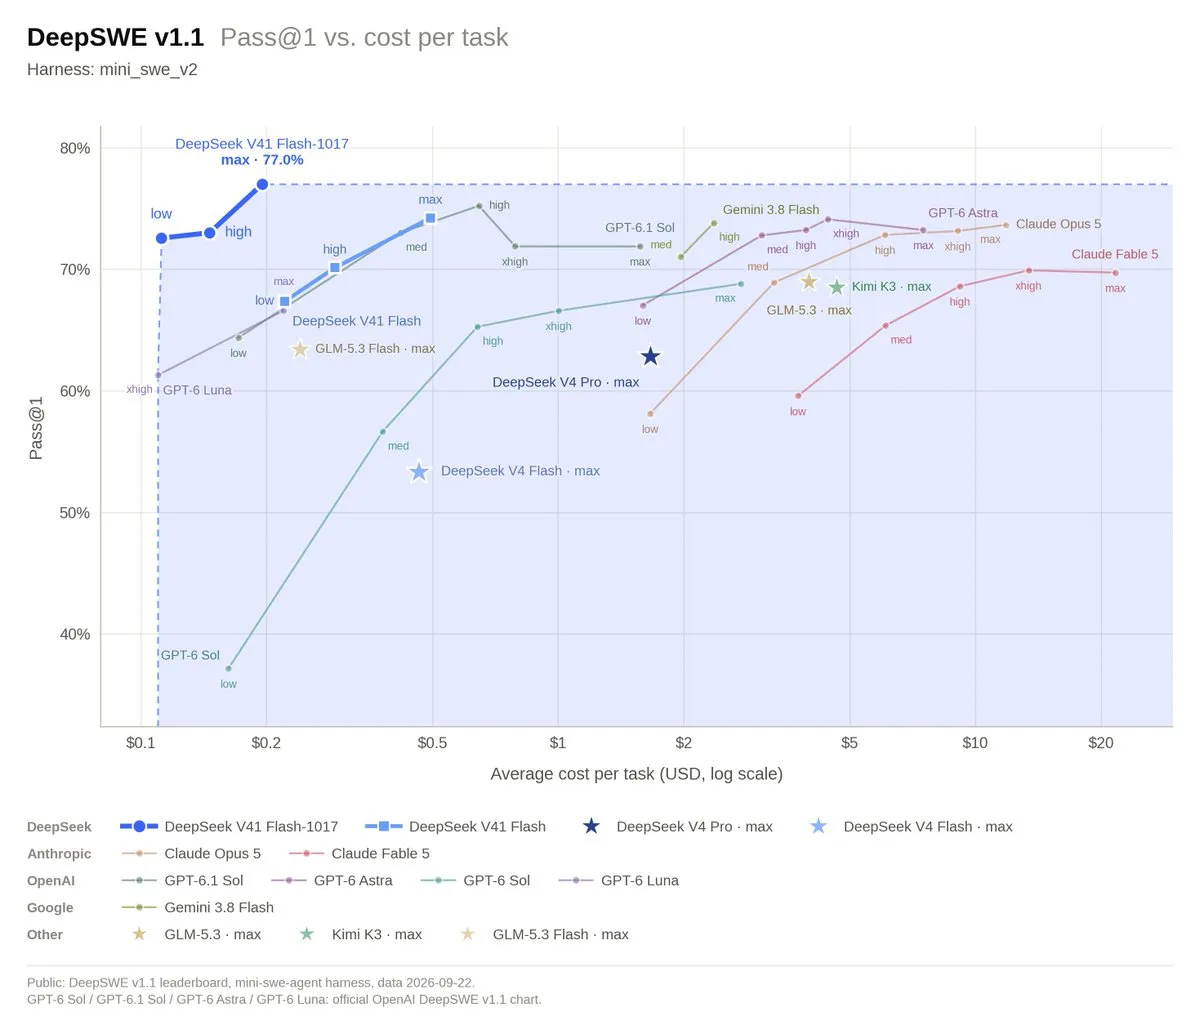
اگر امروز برای اجرای عاملهای کدنویسی هزینه میپردازید، احتمالاً متوجه شدهاید که یا باید مدلهای گرانقیمت و قابلاعتماد را انتخاب کنید یا مدلهای ارزان اما ضعیف. اما مدل جدید DeepSeek V4.1-Flash-1017 این معادله را تغییر داده و هزینه هر تسک را به زیر ۲۰ سنت رسانده است.
این مدل که در ۱۷ اکتبر ۲۰۲۶ منتشر شد، در محک DeepSWE به امتیاز ۷۷.۰٪ رسید. در واقع DeepSeek به دنبال ایجاد یک «بهبود پارتو» است؛ یعنی مدلی که همزمان سریعتر، ارزانتر و دقیقتر از نسل قبلی باشد. همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تعادل میان کارایی و دسترسی همواره چالش اصلی توسعهدهندگان بوده است.
مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در این نسخه با استفاده از یادگیری تقویتی با بازخورد خودکار (RLSF) آموزش دیده است. طبق گزارش the-decoder.com، این سازوکار به هوش مصنوعی اجازه میدهد از نمرات اطمینان داخلی و نقدهای خود به عنوان سیگنال پاداش استفاده کند و نیاز به ارزیابان انسانی در مرحله پسآموزش را حذف کند.
مشخصات فنی و عملکرد
- دسترسی: انتشار با وزنهای باز (Open Weights) — یعنی «دستور پخت» مدل علناً منتشر شده، نه فقط غذای آماده — در Hugging Face و ModelScope.
- محکها: عملکرد برتر نسبت به Claude Opus 5، GPT 5.6-Sol، Kimi K3 و GLM 5.3 در دستههای خاص کدنویسی. این رقابت در مدلهای سریعتر شدت یافته است، بهطوری که مدل GLM-5.3-FlashX نیز پیشتر با تمرکز بر کاهش تأخیر و هزینه معرفی شده بود.
- بهینگی هزینه: در تنظیمات پایین، مدل با دقت ۷۲٪، هر تسک را با هزینه حدود ۱۰ سنت اجرا میکند؛ در حالی که این رقم در نسخه قبلی ۵۰ سنت بود.
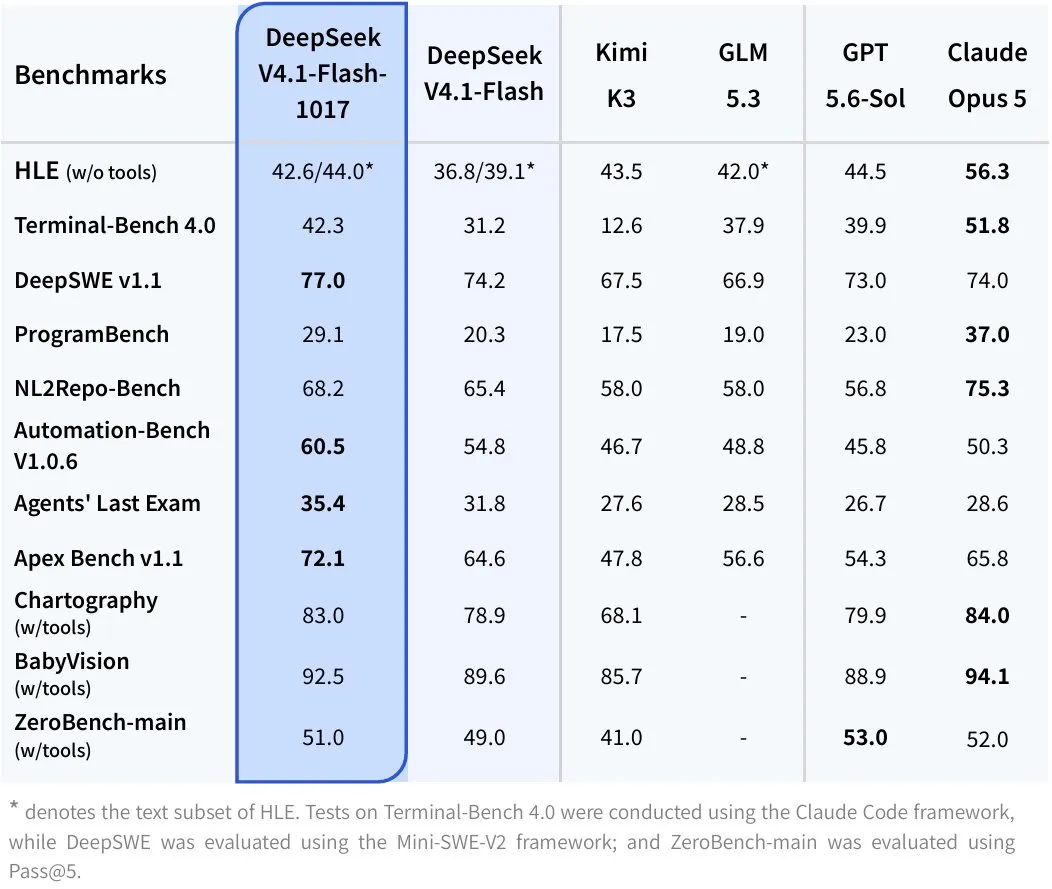
- قابلیتها: پشتیبانی از توسعه جامع پروژهها برای مدلسازی سهبعدی، برنامهنویسی بازی و انیمیشنهای ویدئویی کوتاه.
- یکپارچگی: بهینهشده برای DeepSeek Harness، Tencent CodeBuddy و WorkBuddy. این مدل بهطور مستقیم با معماری پلاگینمحور DeepSeek Harness برای ساخت عاملهای بازمتن سازگار است.
علاوه بر مدل، DeepSeek دسترسی به موتور جستوجوی داخلی خود را از طریق APIهای Search & Fetch باز کرد. بر اساس مستندات این شرکت، این ابزارها که روزانه صدها میلیون پرسوجو را مدیریت میکنند، برای هر ۱۰۰۰ فراخوانی ۰.۷۵ دلار هزینه دارند. کاربران API میتوانند تا ۳۱ اکتبر ۲۰۲۶ از این قابلیتها بهصورت رایگان استفاده کنند.
این حرکت فشار شدیدی بر ارائهدهندگان غربی مانند OpenAI و گوگل وارد میکند. در حالی که GPT-6 Astra و Gemini 3.8 Flash در محکهای مشابه بین ۲ تا ۱۰ دلار برای هر تسک هزینه دارند، DeepSeek با کسری از این قیمت عمل میکند. برای کسبوکارها، این یعنی جریانهای کاری عاملمحور (Agentic) — شبیه به داشتن کارمندانی دیجیتال که میتوانند بهطور مستقل پروژه را پیش ببرند — که پیش از این گران بودند، اکنون توجیهپذیر شدهاند. این تحول در کنار عرضهی اپلیکیشنهای دسکتاپ DeepSeek، دسترسی به این عاملهای متنباز را برای کاربران عادی نیز تسهیل کرده است.
با این حال، سایه مقررات دولتی بر این پیشرفتها سنگینی میکند. گزارشها حاکی از آن است که دولت چین قصد دارد قوانین انتشار مدلهای وزنباز را سختگیرانهتر کند و احتمالاً انتشار سیستمهایی که در ۱۰ مدل برتر جهان هستند را مسدود کند.
گام بعدی شما
- اگر از مدلهای گرانقیمت برای اتوماسیون کدنویسی استفاده میکنید، مدل Flash را در محیط تست جایگزین کنید تا کاهش هزینه را بسنجید.
- API جستوجوی DeepSeek را پیش از پایان مهلت رایگان (۳۱ اکتبر) برای غنیسازی دادههای مدل خود امتحان کنید.
- تغییرات احتمالی در سیاستهای انتشار مدلهای چینی را دنبال کنید تا از قطع دسترسی به نسخههای بازمتن غافلگیر نشوید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو