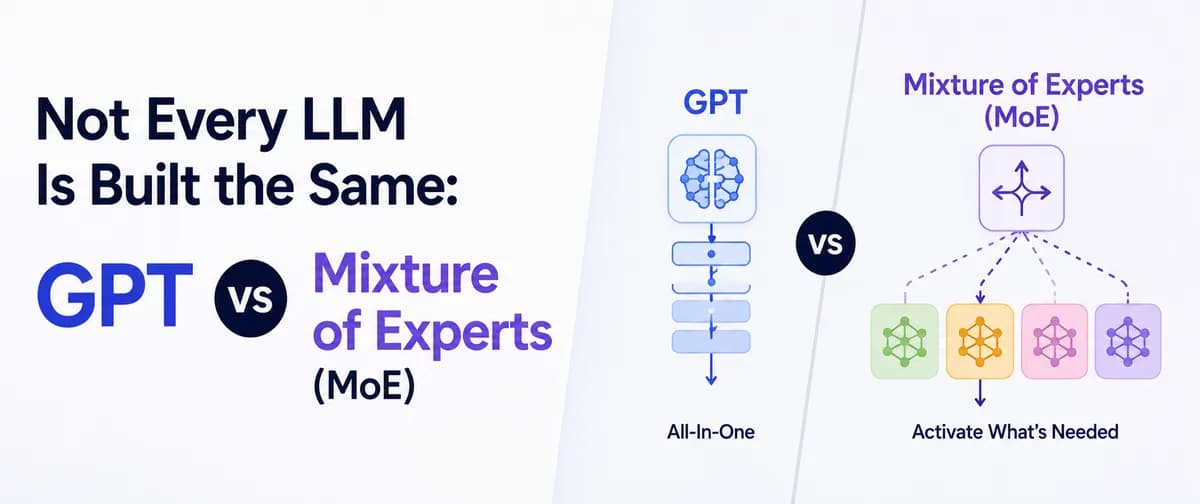
تصور کنید برای پاسخ به یک سؤال ساده، تمام ۱۰۰ کارمند یک شرکت مجبور باشند در یک جلسه شرکت کنند؛ این دقیقاً همان منطق مدلهای متراکم است. اگر امروز از مدلهایی استفاده میکنید که پاسخدهی کندی دارند یا منابع سختافزاری زیادی مصرف میکنند، دلیل آن در ساختار درونی این مدلها نهفته است.
طبق گزارش منتشر شده در وبسایت dev.to در ۱۵ ژوئیه ۲۰۲۶، انتخاب بین دو مسیر ساختاری متراکم و ترکیب خبرهها، سرعت و میزان استفاده از حافظه را در تقریباً تمام مدلهای زبانی بزرگ (LLM) — که شبیه کتابخانهداری هستند که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — تعیین میکند. همانطور که در تحلیل قبلی ما دربارهی نیازهای تجربه کاربری در GPT-Live اشاره کردیم، این سربار ساختاری عامل اصلی تفاوت عملکرد مدلهاست.
بر اساس مستندات فنی، صنعت هوش مصنوعی اکنون به دو جبهه تقسیم شده است:
مدلهای متراکم (Dense Models)
این مدلهای سنتی برای هر پرامپت، ۱۰۰٪ پارامترها (Parameters) خود را فعال میکنند. نمونههای شاخص عبارتاند از:
- OpenAI GPT-3 و GPT-3.5
- نسخههای ۱، ۲، ۳، ۳.۱ و ۳.۲ مدل Meta Llama
- تمامی نسخههای Google Gemma
- مدلهای Microsoft Phi-2، Phi-3 و Phi-4
ترکیب خبرهها (Mixture of Experts - MoE)
مدلهای MoE از یک «مسیریاب» استفاده میکنند تا پرامپت را فقط به متخصصان مرتبط ارسال کنند و سایر بخشها را غیرفعال نگه دارند. این سازوکار اجازه میدهد مدل بدون افزایش خطی در هزینه استنتاج (Inference Cost) — یعنی کرایهی آشپزخانه صنعتی که هرچه دستور پخت سنگینتر باشد، هزینه هر وعده بیشتر میشود — به مقیاسهای عظیم برسد. مثالهای کلیدی عبارتاند از:
- Mixtral 8x7B و 8x22B
- مدلهای DeepSeek V2، V3 و R1
- نسخههای ۱.۵، ۲.۰ و ۲.۵ مدل Gemini
- Grok 2 و Grok 3
- GPT-4 (که طبق گزارشهای متعدد یک مدل MoE است)

مدلهای متراکم سادگی و شبکهای یکپارچه ارائه میدهند، اما در مقیاسپذیری بهینه شکست میخورند. در مقابل، معماری MoE به مدل اجازه میدهد دانش وسیعی داشته باشد اما فقط هزینه محاسباتی متخصصان مورد نیاز را پرداخت کند. به عنوان مثال، یک درخواست برای کد پایتون تنها بخشهای برنامهنویسی و نویسندگی را فعال میکند و متخصص زیستشناسی در حالت خواب باقی میماند.
برای کاربر عادی، این بدان معناست که انتخاب مدل باید بر اساس تکالیف باشد. برای تعاملات روزمره و عمومی از مدلهای متراکم استفاده کنید، اما برای پژوهش در موضوعات پیچیده یا تدوین برنامههای دقیق که نیاز به عمق تخصصی دارند، به سراغ مدلهای MoE بروید.
با رشد مدلها، MoE به مکانیسم اصلی برای مدیریت هزینههای استنتاج تبدیل شده است. باید زیر نظر داشته باشید که مدلهای «کوچک» آینده واقعاً متراکم هستند یا ترکیبی از MoE؛ زیرا این موضوع تعیین میکند که آیا این مدلها روی سختافارهای محلی قابل اجرا باشند یا خیر.
گام بعدی شما
- هنگام انتخاب مدل برای پروژههای تجاری، ابتدا بررسی کنید که آیا مدل هدف از معماری MoE بهره میبرد تا هزینههای API را پیشبینی کنید.
- در تسکهای تخصصی (مانند تحلیل حقوقی یا پزشکی)، مدلهای MoE با پارامترهای بالا را به مدلهای متراکم ترجیح دهید.
- اگر قصد میزبانی شخصی مدل دارید، نسخههای کوانتیده شدهی مدلهای MoE را برای بهینهسازی VRAM امتحان کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو