اگر امروز برای اجرای یک مدل هوش مصنوعی با کیفیت متوسط هزینه میپردازید، سال آینده احتمالاً برای همان سطح از کیفیت، ۱۳ برابر کمتر پرداخت خواهید کرد. این سقوط قیمت، سریعترین نرخ کاهش هزینه در تاریخ فناوریهای تحولآفرین است.
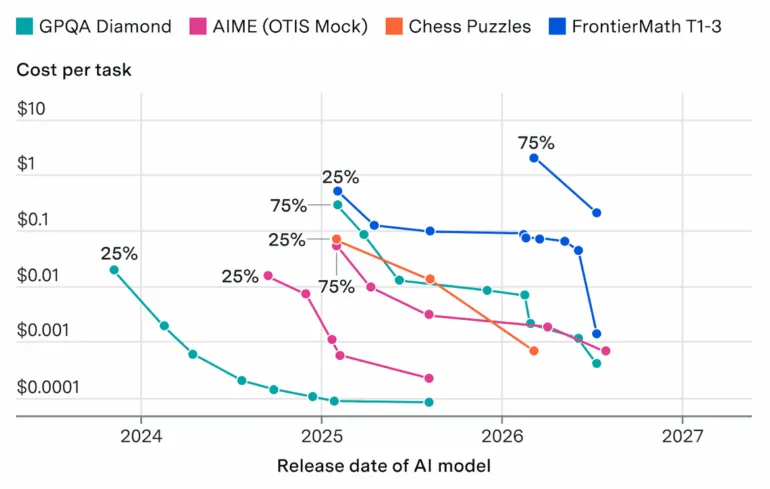
طبق گزارش Epoch AI که در ۲۴ سپتامبر ۲۰۲۶ منتشر شد، هزینه رسیدن به محکهای (Benchmarks) مشخص از سال ۲۰۲۳ تاکنون بهطور متوسط هر سه ماه یکبار ۴۷ درصد کاهش یافته است. برای درک این سرعت، تصور کنید اگر قیمت خودروها با همین نرخ پایین میآمد، یک ماشین ۵۰ هزار یورویی امروز کمتر از ۷۰ یورو قیمت داشت. این تغییر، اقتصاد استقرار هوش مصنوعی زاینده (Generative AI) — که شبیه به آشپزخانهای است که دستور پختهای پیچیده را در مقیاس صنعتی و ارزان اجرا میکند — را بهطور بنیادین تغییر میدهد.
زمینه و متدولوژی
همانطور که در تحلیلهای قبلی ما دربارهی قوانین مقیاسپذیری اشاره کردیم، بهینهسازیهای نرمافزاری همواره نقش کلیدی در کاهش هزینهها داشتهاند. در این گزارش، Epoch AI تحلیل خود را بر پایه پنج محک در حوزههای منطق، علوم و ریاضی بنا کرده است. سازمان Epoch AI به دلیل محدود بودن این نمونه، این نتایج را «اندازهگیریهایی معقول اما تقریبی بر اساس بهترین دادههای موجود» توصیف میکند.
آنها برای جلوگیری از پدیده «بهینهسازی برای آزمون» (Benchmaxxing) — وضعیتی که در آن شرکتها مدلهای خود را صرفاً برای کسب نمره در تستهای شناختهشده بهینه میکنند — یک تست مخفی به نام «پازلهای بازی مرموز» را اضافه کردند که بر اساس یک بازی سری طراحی شده بود. جالب اینجاست که کاهش هزینه در این تست مخفی بسیار کندتر از سایرین بود؛ موضوعی که احتمالاً تایید میکند برخی شرکتها نمرات خود را در آزمونهای عمومی بهصورت مصنوعی بالا میبرند بدون اینکه در دنیای واقعی پیشرفتی داشته باشند.
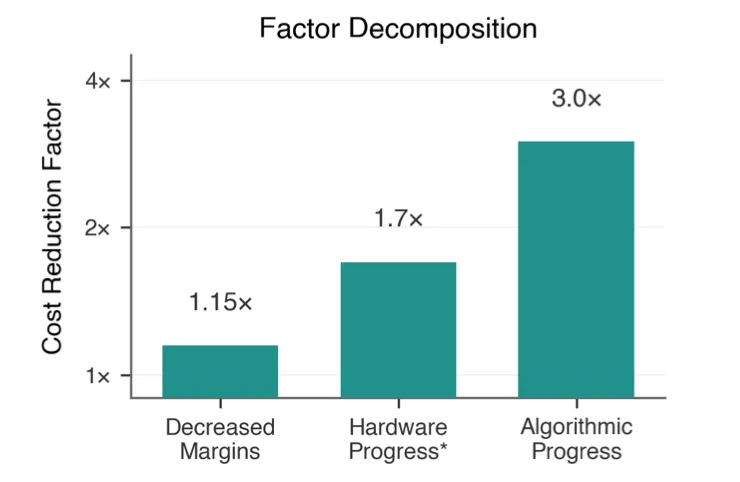
اما تمام این کاهشها یکسان نیستند. پژوهشگران MIT، از جمله هانس گاندلاخ، با بررسی دادههای Artificial Analysis بین آوریل ۲۰۲۴ تا نوامبر ۲۰۲۵ به نتیجه رسیدند که سود خالص حاصل از بهینهسازی الگوریتمی (Algorithmic Efficiency) — یعنی همان پیدا کردن راه کوتاهتر برای رسیدن به جواب، شبیه به اصلاح یک دستور پخت برای مصرف کمتر مواد اولیه — سالانه تنها ۳ برابر است، نه ۱۳ برابر. این محققان در هر تست، مدلهای بسیار بیشتری را نسبت به پژوهشهای قبلی ارزیابی کردند و دریافتند که اگرچه هزینههای کلی در حال سقوط است، اما بهرهوری خالص الگوریتمی رشد کندتری دارد.
محرکهای کاهش قیمت
به نقل از این پژوهشگران، سقوط شدید قیمتها حاصل ترکیب سه عامل متمایز است:
- بهینهسازی الگوریتمی: معماریهای بهتر و روشهای آموزش پیشرفتهتر (حدود ۳ برابر سود سالانه).
- بهبود سختافزاری: تولید تراشههای قدرتمندتر و ارزانتر.
- رقابت بازار: فشار شدید قیمتی و رقابت تهاجمی بین ارائهدهندگان سرویس.
پژوهشگران MIT برای جداسازی این عوامل، مدلهای متنباز (Open Models) را بهطور مجزا بررسی کردند تا اثر رقابت تجاری را کنترل کنند. این رویکرد یادآور چالشهای مشابه در مدلهای متنباز است، مانند مدل MiMo-V2.6 که در تلاش بود تعادلی میان راندمان هزینه و کیفیت عملکرد ایجاد کند. آنها دریافتند که رقم ۱۳ برابری که Epoch AI گزارش کرده، به این دلیل است که اثرات سختافزار و رقابت بازار را از محاسبات خود حذف نکرده است.
پارادوکس استدلال
در اینجا با یک پارادوکس مواجهیم: تفاوت زیادی بین «رسیدن به سطح سال گذشته» و «اجرای بهترین مدل امروز» وجود دارد. مدلهای استدلالی (Reasoning Model) — مدلهایی که قبل از جواب دادن درنگ میکنند، شبیه به شطرنجبازی که چند حرکت جلوتر را میبیند — برای دقت بیشتر، محاسبات (Compute) بسیار بیشتری مصرف میکنند.
بهعنوان مثال، مدل o3 شرکت OpenAI در اوایل ۲۰۲۵ برای هر سوال در آزمون GPQA Diamond (در سطح دکتری علوم) حدود ۳۰ سنت هزینه داشت و نمره ۷۵ درصد را کسب کرد. ۱۸ ماه بعد، یک مدل از خانواده GPT-5.6 همان نمره را با هزینه تنها ۰.۰۴ سنت به دست آورد؛ یعنی ۷۲۵ برابر ارزانتر.
با این حال، مدلهای پیشروتر و قدرتمندترینهای فعلی، مانند مدلهای تازه عرضه شده GPT-6 Sol و Luna، احتمالاً برای هر پرسوجو (Query) گرانتر هستند. دلیل آن استفاده گسترده از «محاسبات زمان استنتاج» (Test-time compute) برای حل مسائل سختتر است. MIT دریافت که برخی از پیشرفتهای عملکردی در محکهای کدنویسی و GPQA Diamond، صرفاً نتیجه صرف قدرت پردازشی بیشتر برای هر سوال است.
این بدان معناست که در حالی که کفِ قیمت برای هوش مصنوعی «به اندازه کافی خوب»، در حال سقوط است، سقفِ قیمت برای هوش مصنوعی «مرزی» (Frontier) همچنان بالا است. یک نمره تک در یک محک، معمولاً ترکیبی از آموزش بهتر، دادههای باکیفیتتر، معماری بهینهتر و افزایش محاسبات زمان استنتاج است.
این وضعیت یک شکاف استراتژیک برای کسبوکارها ایجاد میکند. شما اکنون میتوانید هوش مصنوعی سطح اول سال گذشته را تقریباً رایگان اجرا کنید، اما برای رسیدن به لبه تکنولوژی و پیشرفتهترین قابلیتها، همچنان به بودجهای کلان نیاز دارید.
در این بازار، دیگر «قیمت هر توکن» تنها معیار نیست؛ زیرا توکنها واحدهایی هستند که ارائهدهندگان برای صورتحساب استفاده میکنند، اما تصویر کامل را نشان نمیدهند. تأخیر (Latency)، سرعت خروجی و هزینه تلاشهای مجدد (Retries) اغلب اهمیت بیشتری نسبت به هزینه خام یک پرسوجوی واحد دارند. یک مدل ارزان با تأخیر بالا برای یک چتبات بلادرنگ (Real-time) بیفایده است، در حالی که یک مدل مرزی گرانتر اگر پاسخها را دفعات بیشتری درست بدهد، در نهایت باعث صرفهجویی در هزینهها میشود.
گام بعدی شما
- برای کارهای روتین، از مدلهای بهینهشده سال گذشته استفاده کنید تا هزینههایتان را به شدت کاهش دهید.
- بودجه مدلهای پیشرو را فقط برای تسکهایی اختصاص دهید که نیاز به استدلال عمیق دارند و با مدلهای ارزانتر حل نمیشوند.
- معیارهای ارزیابی خود را از «قیمت توکن» به «هزینه رسیدن به جواب درست» تغییر دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو