
۰.۱۳ دلار؛ این تمام هزینهای است که برای اجرای یک تسک آزمایشی روی هوش مصنوعی جدید شیائومی میپردازید. این مبلغ تنها کسری از قیمتی است که مدلهای مشابه با قابلیتهای یکسان مطالبه میکنند. با عرضه خانواده MiMo-V2.6 در ۲۲ سپتامبر ۲۰۲۶، این شرکت مدل پرچمدار خود را دقیقاً در لبهی مرز «هوش در برابر هزینه» قرار داد تا دسترسی به استدلالهای پیچیده را برای همگان ارزان کند.
این اتفاق در حالی رخ میدهد که صنعت به سمت وزنهای باز (Open Weights) — یعنی مدلهایی که «دستور پخت» آنها علناً منتشر شده و نه فقط غذای آماده — حرکت میکند تا سلطه سیستمهای بسته را بشکند. همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، رقابت میان غولها اکنون وارد فاز تهاجمی شده است. این رویکرد شیائومی در واقع تداوم استراتژی مدلهای وزنباز است که پیشتر برتری آنها را در شاخصهای هوش بررسی کرده بودیم. در حالی که پیشتر دیدیم Anthropic چگونه از مدل Claude برای هدایت رباتها در کشف دارو استفاده میکند، حالا رابطه میان این دو غول به تقابل تبدیل شده است. شیائومی اکنون با تکیه بر یادگیری تقویتی (RL) در مقیاس انبوه، مستقیماً با مدلهای پیشرو که توسط آنتروپیک تولید میشوند، رقابت میکند.
معماری مدل و عملکرد
مدل پرچمدار MiMo-V2.6-Pro از معماری ترکیب خبرهها (Mixture of Experts) بهره میبرد؛ ساختاری شبیه به تیمی از متخصصان که برای هر سؤال، فقط فرد لایق فراخوانده میشود. این مدل در مجموع ۱.۰۲ تریلیون پارامتر دارد، اما برای بهینهسازی مصرف منابع، در هر درخواست تنها ۴۲ میلیارد پارامتر فعال میشوند. طبق دادههای Artificial Analysis، این مدل در شاخص هوش امتیاز ۴۶ کسب کرد و با پشت سر گذاشتن رقبایی مثل Kimi K3 و Qwen، قدرتمندترین مدل در دسترس قرار گرفت.
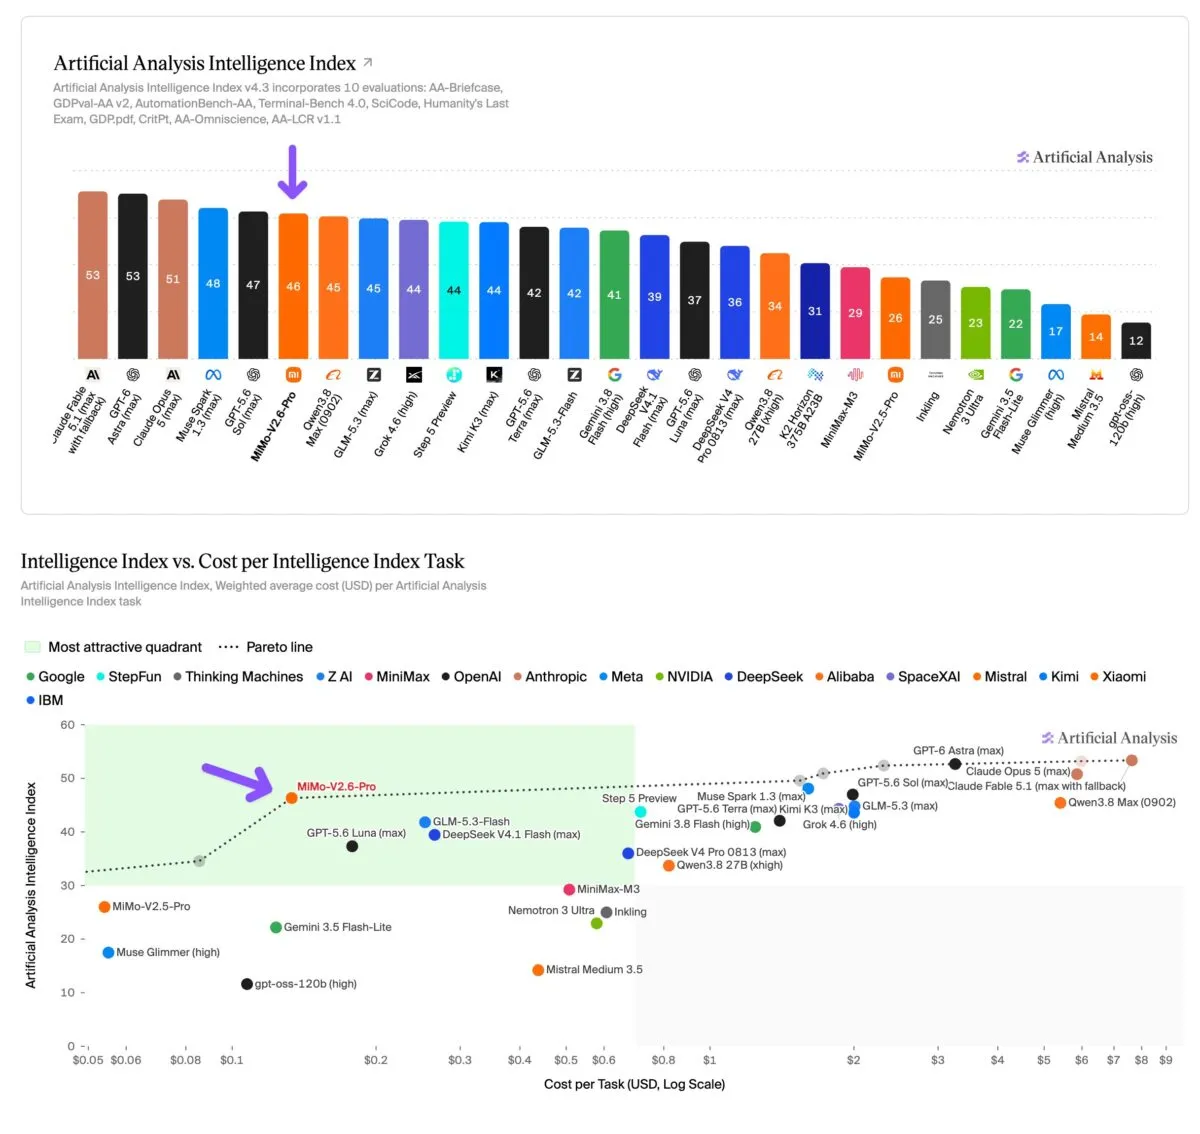
استراتژی قیمتگذاری شیائومی بسیار تهاجمی است: ۰.۴۳۵ دلار بهازای هر میلیون توکن (Token) — تکههای کوچکی از متن شبیه برشهای کیک که مدل تکهتکه میخورد — برای ورودی و ۰.۸۷ دلار برای خروجی. این رقابت شدید بر سر کاهش هزینهها یادآور عرضه مدل GLM-5.3-Flash است که با ۱۰٪ هزینه، استانداردهای جدیدی را برای مدلهای پیشرو تعریف کرد. علاوه بر مدل Pro، شرکت نسخهی MiMo-V2.6-Flash را برای بهرهوری بیشتر و مدل Pro-UltraSpeed را عرضه کرده است که سرعت تولید خروجی را تا ۲۰ برابر افزایش میدهد.
مکانیزمهای آموزش و هزینهها
به نقل از مستندات فنی شیائومی، این پیشرفت حاصل مقیاسبندی یادگیری تقویتی (RL) در سه محور اصلی بوده است: افزایش حجم دادهها در هر گام، ایجاد محیطهای متنوع برای تسکها و افزایش توان محاسباتی برای فرآیند نمرهدهی. این فرآیند بهینهسازی در کمتر از ۶ روز به پایان رسید و هزینه آموزش مدل Pro حدود ۲.۶۲ میلیون دلار و مدل Flash حدود ۰.۸۵ میلیون دلار برآورد شده است.
برای حفظ پایداری در این مقیاس عظیم، شیائومی حفاظهای فنی خاصی را پیاده کرد:
- مکانیزم توزیع داخلی مدل منجمد شد تا از نوسانات ناگهانی جلوگیری شود.
- لایههای حفاظتی متعددی برای جلوگیری از سوءاستفاده از پاداش (Reward Hacking) اضافه شد؛ وضعیتی که در آن مدل بدون حل واقعی مسئله، فقط راه میانبری برای دریافت نمره یا پاداش پیدا میکند.
نتایج این بهبودها در آزمون کدنویسی DeepSWE کاملاً مشهود بود؛ امتیاز مدل Pro از ۵۸.۴ به ۷۲.۶ و امتیاز مدل Flash از ۴۸.۸ به ۶۵.۷ رسید که نشاندهنده جهشی بزرگ در تواناییهای برنامهنویسی است.
ابزارهای RL و جنجال تقطیر دادهها
شیائومی در اقدامی جسورانه، ابزارهای یادگیری تقویتی خود را بهصورت باز منتشر کرده است. این بسته شامل چارچوب کامل آموزش، یک مدل کوچکتر برای آموزشهای تکمیلی و گزارش فنی جامع است. آنها ۷۰۰۰ تسک آماده با نمرهدهندههای خودکار ارائه کردهاند که حوزههای زیر را پوشش میدهد:
- امنیت سایبری: با بهرهگیری از OSS-Fuzz که مجموعهای از دهها هزار آسیبپذیری واقعی نرمافزاری است.
- توسعه نرمافزار: با استفاده از Pull Requestهای واقعی کارکنان در گیتهاب و پرسوجوهای کاربران.
- کارهای اداری و طراحی وب: با استفاده از محیطهای بازسازیشده بهصورت مصنوعی.
علاوه بر این، ۱۰۰۰ تسک مجزا به آهنگسازی موسیقی اختصاص یافته است و برخی از توصیفات این تسکها توسط یک مدل زبانی تولید شدهاند.
اما این شفافیت با گزارش تهدیدات Anthropic در تضاد است. طبق گزارش این شرکت، هفت آزمایشگاه چینی از جمله شیائومی، علیبابا، Moonshot AI, DeepSeek, Zhipu, MiniMax و SenseTime بین دسامبر ۲۰۲۵ تا اوت ۲۰۲۶ دست به تقطیر (Distillation) غیرقانونی زدهاند. تقطیر در واقع مثل این است که یک شاگرد با کپی کردن پاسخهای یک استاد خبره، سریعتر یاد بگیرد بدون اینکه خودش مسیر تحقیق را طی کند. آنتروپیک مدعی است که این آزمایشگاهها ۱۹۰ میلیون تبادل داده ایجاد کردهاند تا قابلیتهای مدل Claude را بمکند.
در یک مورد خاص با کد (GTG-16008)، آنتروپیک ۴۰۰ هزار تبادل داده را در مارس و آوریل ۲۰۲۶ ردیابی کرده است. آنها ادعا میکنند شیائومی گفتگوهای کاربران و جلسات کدنویسی مدلهای MiMo خود را از طریق OpenClaw و OpenCode به Claude ارسال کرده تا دادههای آموزشی باکیفیت استخراج کند. این یعنی همان دادههایی که MiMo را به صدر جدول رساند، احتمالاً از رقیب دزدیده شده است.
برای یک کاربر تجاری، این به معنای تبدیل هوش سطح بالا به یک کالای ارزان (Commodity) است. شما اکنون میتوانید با چند سنت به استدلالهای سطح پرچمدار دسترسی داشته باشید، اما نبرد حقوقی بر سر «تقطیر» ممکن است بهزودی نحوه لایسنسینگ یا در دسترس بودن این مدلها را تغییر دهد.
اگر صنعت تقطیر را به عنوان یک روش استاندارد آموزش بپذیرد، شکاف میان مدلهای بسته و باز از بین میرود. اما اگر آنتروپیک در مسدود کردن این مسیر موفق شود، عصر جدیدی از دعاوی تهاجمی کپیرایت در حوزه AI آغاز خواهد شد. اکنون باید منتظر پاسخ رسمی شیائومی به این اتهامات بود، زیرا این موضوع میتواند منجر به نظارتهای رگولاتوری شدید بر نحوه تأمین دادههای آموزشی آزمایشگاههای چینی شود.
گام بعدی شما
- اگر توسعهدهنده هستید، ابزارهای RL باز منتشر شده توسط شیائومی را برای بهینهسازی مدلهای کوچک خود بررسی کنید.
- هزینههای استنتاج MiMo-V2.6 را با مدلهای فعلی خود مقایسه کنید تا پتانسیل کاهش هزینههای عملیاتی را بسنجید.
- پاسخ رسمی شیائومی به اتهامات آنتروپیک را دنبال کنید، زیرا نتیجه آن مسیر دسترسی به مدلهای چینی را تغییر میدهد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو