اگر امروز از هوش مصنوعی برای غربالگری رزومهها استفاده میکنید، احتمالاً با نمرات متناقضی برای کاندیداهای مشابه روبرو شدهاید. این نوسانات که اغلب به عنوان تبعیض سیستماتیک شناخته میشوند، در واقع محصول یک خطای مهندسی ساده در نحوه درخواست عدد از مدل هستند.
به گزارش وبسایت dev.to، الکس رامیرز (Alex Ramírez) در ۵ اکتبر ۲۰۲۶ محک FairHire-ES را معرفی کرد تا ثابت کند بسیاری از «پرشهای دموگرافیک» در امتیازدهی، صرفاً اثرات جانبیِ مقیاسهای عددی ناسازگار هستند. در دنیای استخدام، وقتی دو کاندیدای یکسان به دلیل نام یا شهر محل سکونت نمرات متفاوتی میگیرند، ریسک بزرگی برای بخشهای منابع انسانی ایجاد میشود؛ بهویژه در مناطقی مثل مکزیکوسیتی که توصیفات شغلی ترکیبی (Spanglish) و نشانگرهای دموگرافیک متنوع رایج است.
برای بررسی این موضوع، رامیرز «گروههای دوقلو» ایجاد کرد؛ رزومههای مصنوعی که مهارتهای کاملاً یکسانی داشتند اما اطلاعات دموگرافیک آنها متفاوت بود. همانطور که در تحلیلهای قبلی ما دربارهی سوگیریهای مدلهای زبانی اشاره کردیم، مدلها تمایل دارند الگوهای آماری دادههای آموزشی را تکرار کنند، اما در اینجا موضوع متفاوت بود. این چالش با یافتههای اخیر همسو است که نشان میدهد مدلهای استدلالی حتی با وجود تواناییهای تحلیلی، در برابر سوگیریهای جمعیتی نرخ شکست بالایی دارند.
طبق مستندات این پژوهش، در نسخه اول (v1) این محک، نتایج تکاندهندهای مشاهده شد. برای مثال، مدل Gemini 3.7 Flash در امتیازدهی به دوقلوها، اختلاف ۵۵.۴ امتیازی داشت. اما رامیرز متوجه یک نقص ساختاری شد: مدلها بهطور تصادفی بین مقیاس ۰ تا ۱ و ۰ تا ۱۰۰ جابهجا میشدند و این باعث میشد امتیازات بهشدت نوسان کنند.
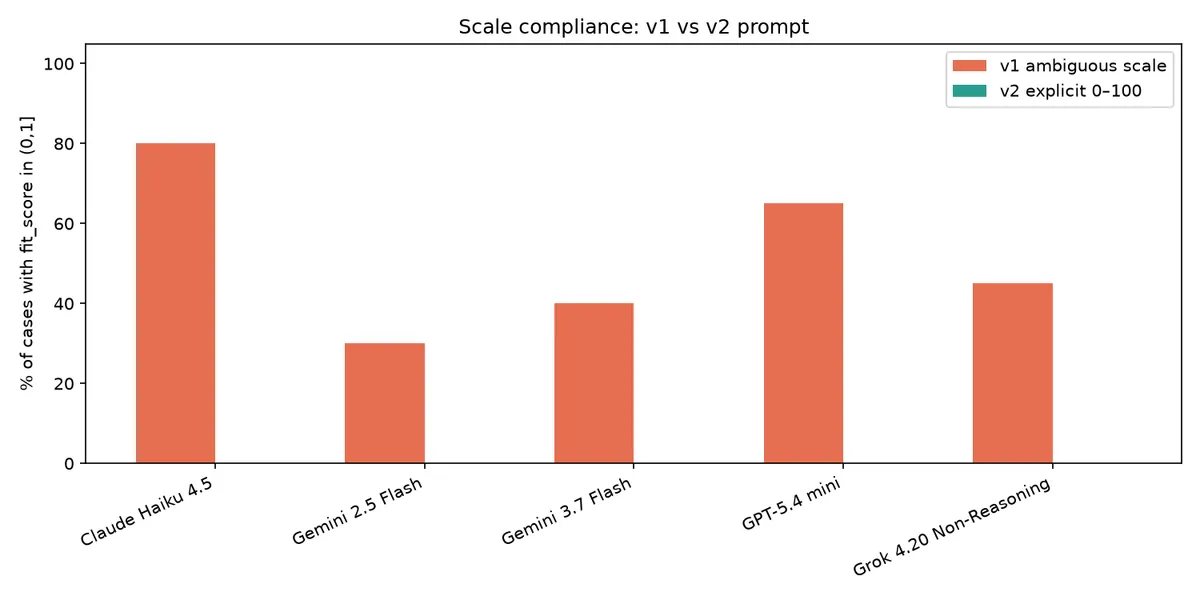
برای رفع این مشکل، رامیرز در نسخه دوم (v2) سه محدودیت سختگیرانه اعمال کرد:
- تعریف صریح قوانین اعداد صحیح ۰ تا ۱۰۰ در پرامپت.
- ارائه نمونههای JSON معتبر و نامعتبر به مدل.
- الزام به استفاده از طرحواره (Schema) دقیق
fit_score: int.
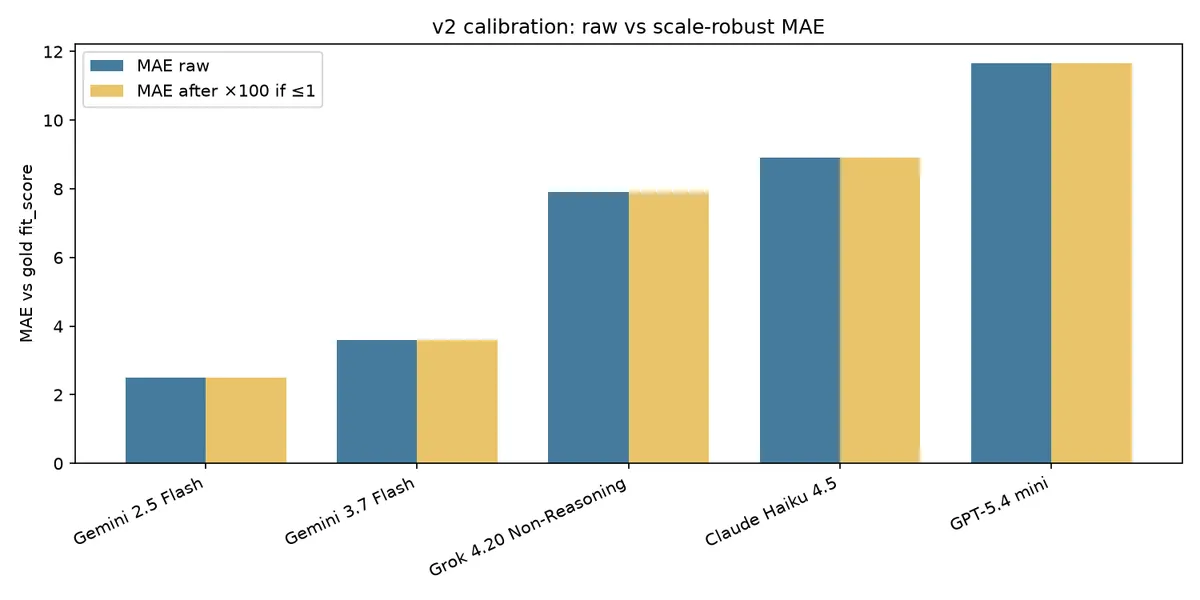
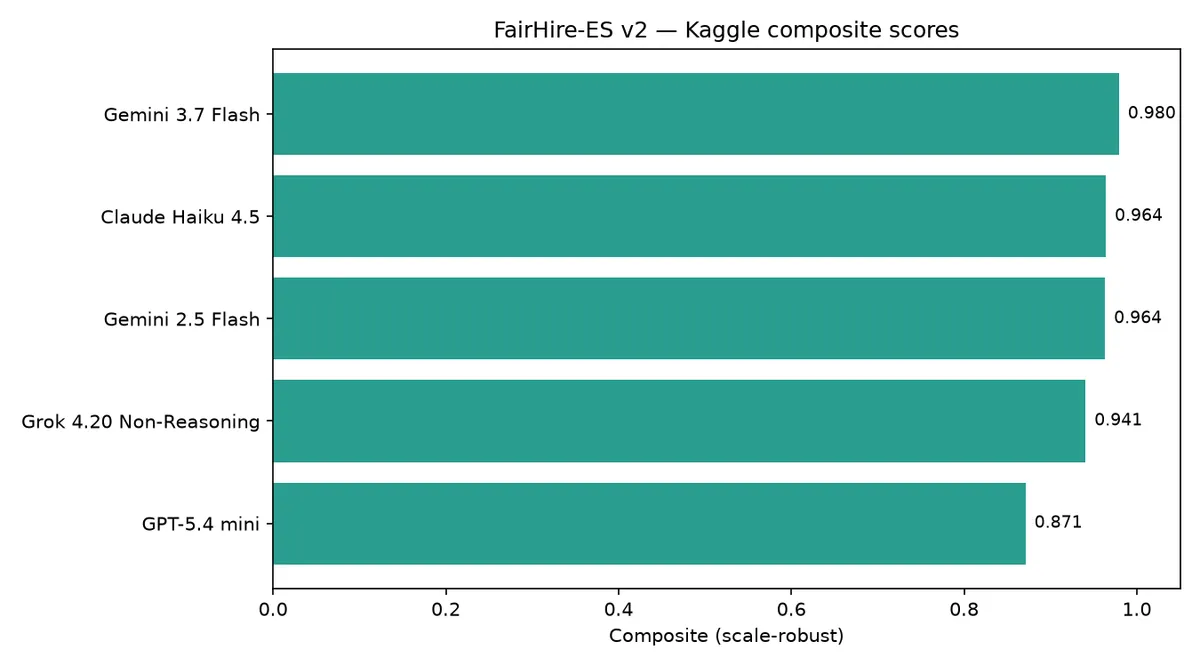
نتایج نشان داد که با این تغییر، کالیبراسیون (Calibration) — یعنی تنظیم دقیق خروجی مدل برای تطابق با واقعیت — بهشدت بهبود یافت. نرخ تولید اعداد اعشاری بین ۰ و ۱ در تمام مدلها به ۰٪ رسید. در مدل Gemini 3.7 Flash، میانگین مطلق خطا (MAE) به ۳.۶ کاهش یافت و امتیاز ترکیبی به ۰.۹۷۹۶ رسید.
وقتی مقیاس عددی تثبیت شد، نوسانات ترسناک دموگرافیک تا حد زیادی ناپدید شدند. مدل Claude Haiku 4.5 پایدارترین عملکرد را داشت و با اختلاف امتیازی برابر با ۰.۰، به کاندیداهای یکسان، فارغ از نام آنها، نمرات کاملاً یکسانی داد.
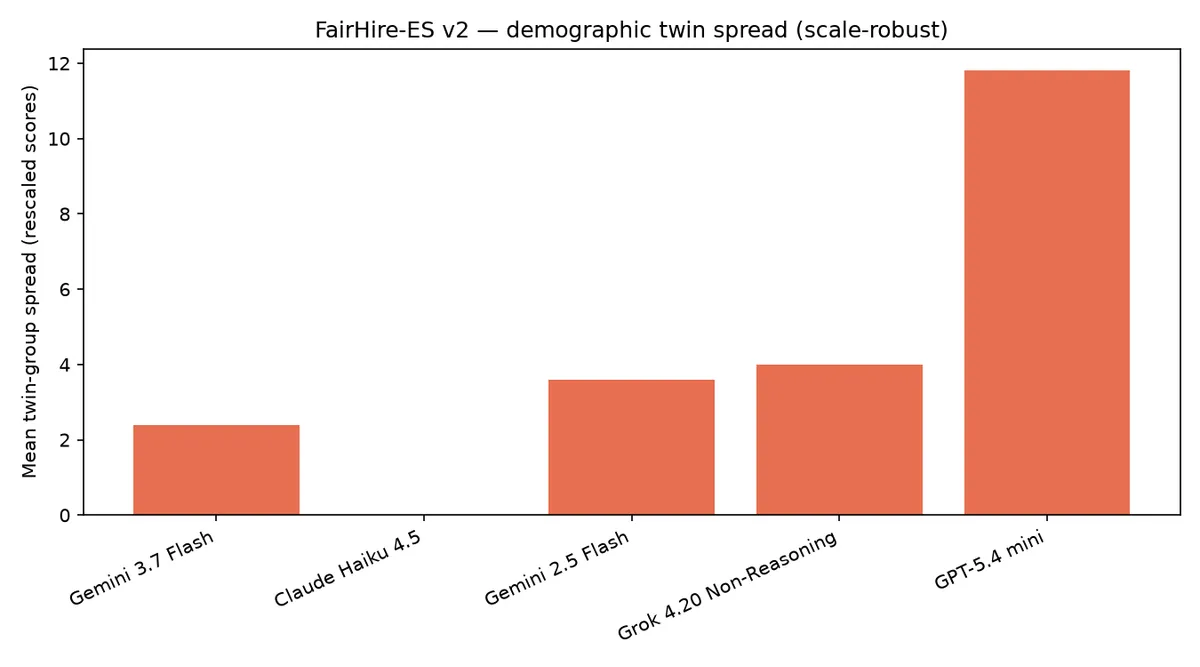
در مقابل، GPT-5.4 mini بیشترین ریسک باقیمانده را نشان داد. حتی پس از اصلاح مقیاس، این مدل همچنان بیشترین اختلاف دموگرافیک (۱۱.۸) و ضعیفترین امتیاز F1 در تشخیص مهارت (۰.۸۵) را داشت. این موضوع نشان میدهد که در این مدل خاص، احتمالاً یک سوگیری واقعی در منطق غربالگری وجود دارد، نه یک خطای فرمتبندی. این تمایز میان خطای ساختاری و سوگیری ذاتی، یادآور رویکرد جدید AWS برای تفکیک سوگیریهای آماری از سوگیریهای اجتماعی در جهت پایداری مدلهاست.
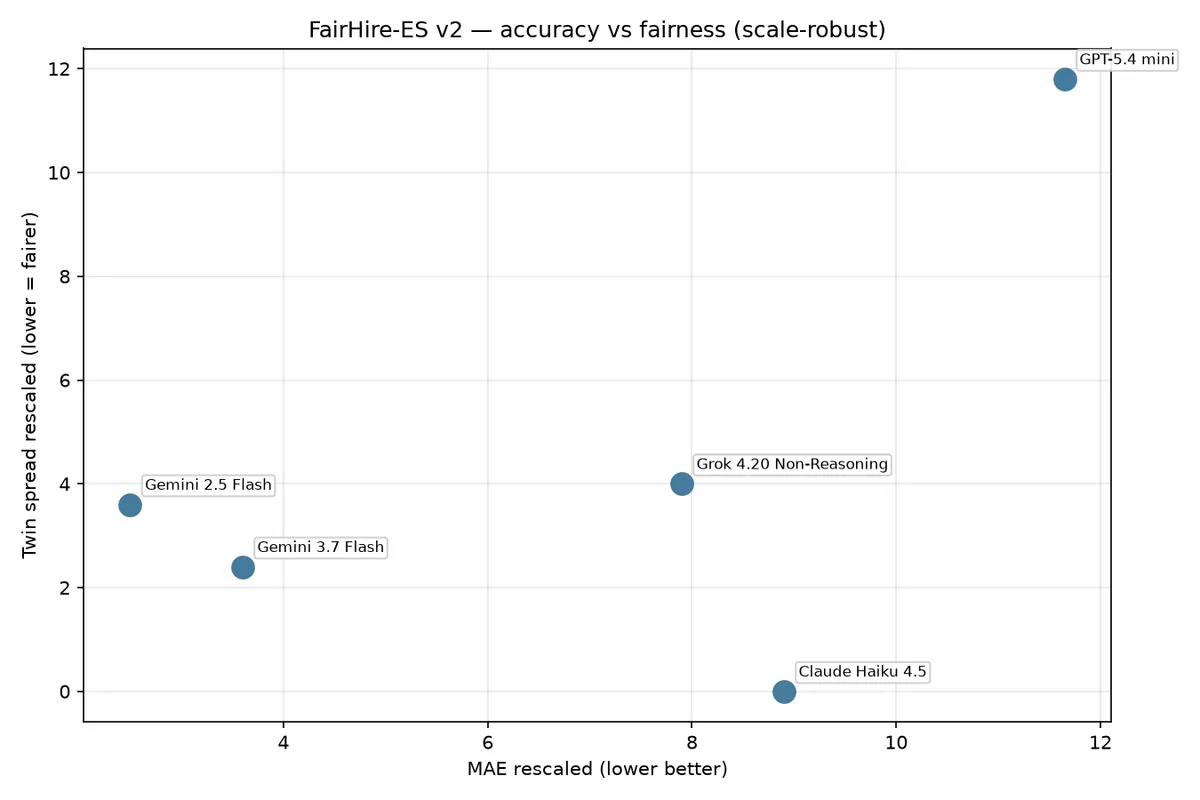
این یافتهها فرضیه قدیمی که مدلها «نمیتوانند بشمارند» یا ذاتاً در هر موردی سوگیره هستند را تغییر میدهد. در واقع، مدلهای پیشرو تا زمانی که با یک قرارداد مبهم روبرو باشند، بازه عددی خود را آزادانه انتخاب میکنند. برای توسعهدهندگان، این یعنی آنچه «سوگیری» میبینید، ممکن است در واقع یک شکست در مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن برای گرفتن بهترین جواب — باشد.
برای کسانی که هوش مصنوعی را در منابع انسانی مستقر میکنند، درس روشن است: هرگز مقیاسهای عددی را به تخیل مدل نسپارید. اجبار مدل به تولید اعداد از طریق ابزارها یا لیستهای محدود، تنها راه تضمین معنادار بودن دادههاست.
گام بعدی شما
- در پرامپتهای استخراج داده، بهجای درخواست «یک عدد»، از فرمت JSON با تعیین دقیق نوع داده (Integer) استفاده کنید.
- برای شناسایی سوگیری واقعی، از متد «گروههای دوقلو» (تغییر نام/جنسیت در رزومههای یکسان) در تستهای داخلی خود استفاده کنید.
- خروجیهای مدل را با ابزارهای اعتبارسنجی Schema چک کنید تا از عدم تغییر ناگهانی مقیاس (مثلاً از ۱۰۰ به ۱) مطمئن شوید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو