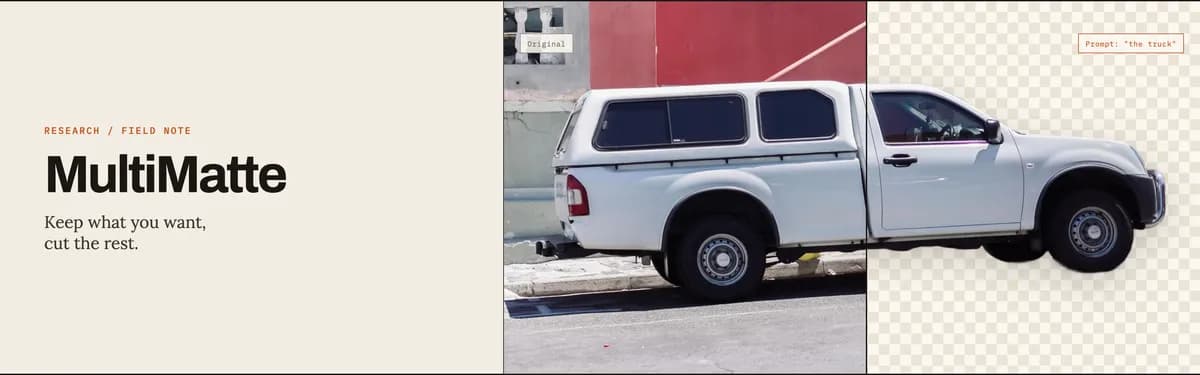
اگر طراح گرافیک هستید و ساعتها وقت خود را صرف پاک کردن لبههای دندانهدار عکسها میکنید، دوران دستاندازهای بصری به پایان رسیده است. عدد ۰.۹۰۱ در معیار S-measure اکنون به استاندارد جدید دقت در قطعهبندی تصویر تبدیل شده است. در ۱۰ سپتامبر ۲۰۲۶، شرکت Feyn مدل MultiMatte را منتشر کرد. این مدل با عبور از ماسکهای سادهی باینری، به ایجاد «آلفا متهای» با وفاداری بالا (High-fidelity alpha mattes) میپردازد تا جزئیاتی مثل تارهای مو یا لبههای محو را حفظ کند. این فناوری اجازه میدهد تنها با یک پرامپت متنی، سوژه با دقتی در سطح استودیوهای حرفهای از پسزمینه جدا شود.
بیشتر ابزارهای حذف پسزمینه با پیکسلها مثل یک کلید برق برخورد میکنند؛ یا روشن هستند (جزء شیء) یا خاموش (پسزمینه). این رویکرد باینری در مواجهه با المانهای نیمهشفاف یا مرزهای مبهم شکست میخورد و اغلب لبههای زبر و دندانهدار دور سوژه باقی میگذارد. MultiMatte این مشکل را با اختصاص یک مقدار شفافیت پیوسته (Continuous opacity value) به هر پیکسل حل میکند تا انتقال طبیعی و نرم بین سوژه و محیط ایجاد شود. این رویکرد در کنار بهبود معیارهای ارزیابی حذف اشیا در ویدیوها، استانداردهای جدیدی را برای سنجش کیفیت خروجیهای بصری تعریف میکند.
چرخش به سمت آلفا مت
مدل SAM 3 (Segment Anything Model 3) به عنوان یک تشخیصدهنده با پرامپت متنی عمل میکند. این مدل ماسکهای باینری برمیگرداند که پیکسلها را صرفاً به دو دسته «داخل شیء» یا «خارج از شیء» تقسیم میکند. این روش در مواجهه با المانهای ظریف، مانند یک صفحه نمایش محو یا تارهای مو، ناتوان است و نمیتواند پیچیدگی لبهها را بازنمایی کند.
MultiMatte این شکاف را با پیادهسازی آلفا مت پر میکند. در این حالت، مرزهای محو دقیقاً همانطور که در واقعیت ظاهر میشوند، توصیف میگردند. طبق گزارشهای منتشر شده، این بهبود در دادههای با رزولوشن بالای DIS کاملاً مشهود است؛ جایی که امتیاز SAM 3 بین ۰.۶۴۹ و ۰.۷۰۳ است، اما MultiMatte به بازه ۰.۸۹۳ تا ۰.۹۲۳ رسیده است.
تیم Feyn با تکیه بر مدل SAM 3 شرکت متا (Meta) که در سال ۲۰۲۵ عرضه شد، از روش لورا (LoRA) — شبیه به اضافه کردن یک لایه نازک اصلاحی روی یک نقاشی قدیمی برای تغییر جزئیات بدون تخریب اثر اصلی — استفاده کرد. آنها تنها ۱۹.۴۹ میلیون پارامتر از مجموع ۸۶۰ میلیون پارامتر مدل را تغییر دادند. این بدان معناست که تنها ۲.۲۷٪ از وزنهای مدل بهروزرسانی شدهاند، اما جهش عملکردی حاصله بسیار چشمگیر بود. به نقل از وبسایت usefeyn.com، مدل MultiMatte در محک DIS-VD به امتیاز S-measure معادل ۰.۹۰۱ دست یافت، در حالی که امتیاز SAM 3 در همین محک ۰.۶۶۷ بود.
همانطور که در تحلیلهای پیشین ما دربارهی مدلهای بینایی-زبانی اشاره کردیم، همراستاسازی متن و تصویر کلید دستیابی به کنترل دقیق در ویرایش است. در همین راستا، معماری Intermediate Fusion نیز با ایجاد استدلال بومی در مدلهای چندوجهی، گامی مهم در جهت درک عمیقتر ارتباط میان مفاهیم متنی و بصری برداشته است.
معماری فنی و استراتژی آموزش
ساختار SAM 3 شامل چندین بخش همراستا است: یک برج بینایی (Vision Tower)، یک برج متنی CLIP، یک رمزگذار هندسی، یک رمزگذار و رمزگشای تشخیص، و در نهایت یک رمزگشای ماسک. مدل MultiMatte توانایی همراستاسازی متنی این بخشها را به طور مستقیم به حوزه متینگ (Matting) منتقل کرده است.
به بر اساس مستندات فنی، کارایی این مدل حاصل استراتژیهای آموزشی زیر است:
- یکپارچهسازی PEFT: تیم از تنظیم کارآمد با پارامتر اندک (PEFT) از طریق لورا (Hu et al., 2021) استفاده کرد. در این روش، وزنهای پیشآموزشدیده منجمد (Frozen) ماندند و مدل تنها دو ماتریس کوچک را برای هر لایه خطی هدف یاد گرفت.
- پیکربندی آداپتور: با پیروی از تحلیلهای لورا در سال ۲۰۲۵ توسط Thinking Machines، یک آداپتور با رتبه ۱۶ (Rank-16) روی لایههای توجه (Attention) و تصویرسازیهای MLP در تمام برجها، از جمله برج متنی CLIP، قرار گرفت. این آداپتورها در نهایت با وزنهای اصلی ادغام شدند تا در زمان استنتاج (Inference) — یعنی لحظهای که مدل واقعاً جواب تولید میکند — نیازی به کتابخانههای مجزا نباشد.
- ترکیب دادهها: آموزش روی ۱۹,۹۵۳ تصویر شامل صحنههای استتار، محیطهای دریایی، تارهای مو و سوژههای با رزولوشن بالا انجام شد. این فرآیند آموزشی در ۱۴,۰۰۰ گام (Step) اجرا گردید.
- نظارت بر پرامپت: برای آموزش «سرِ متینگ» (Matte Head) جدید، از ۴,۹۴۹ تصویر (معادل ۲۴.۸٪ از کل مجموعه) با برچسبهای انسانی استخراج شده از FlowDIS (Sargsyan and Navasardyan, 2026) استفاده شد.
- توابع زیان: برای بهینهسازی قطعهبندی معنایی، ترکیبی از Focal Loss (Lin et al., 2017) و Dice Loss به کار گرفته شد.
عملکرد در محکهای جهانی
نتایج بر اساس S-measure (از ۰ تا ۱) که به شکلهای وفادار به واقعیت پاداش میدهد و میانگین خطای مطلق (MAE) برای مقادیر شفافیت اندازهگیری شدهاند. MultiMatte در تمام بخشهای آزمایشی از SAM 3 پیشی گرفت.
برخی از دستاوردهای کلیدی عبارتند از:
- DIS-VD: افزایش از ۰.۶۶۷ به ۰.۹۰۱ (بهبود ۰.۲۳۳+).
- DIS-TE4: افزایش از ۰.۶۴۹ به ۰.۸۹۳ (بهبود ۰.۲۴۴+).
- COD10K-TE: افزایش از ۰.۷۸۷ به ۰.۹۳۴ (بهبود ۰.۱۴۸+).
در مجموعه داده DAVIS-S — که یک بررسی حیاتی بود زیرا هیچ نمونه مشابهی در دادههای آموزش نداشت — MultiMatte به بالاترین امتیاز مطلق خود یعنی ۰.۹۷۹ رسید. همچنین امتیاز DUT-OMRON را از ۰.۷۹۲ به ۰.۹۰۱ ارتقا داد. نکته جالب این است که حتی بدون تنظیم دقیق (Fine-tuning)، استفاده از یک نام مفهوم واقعی، ۰.۱۵۰ امتیاز S-measure به SAM 3 در محک DIS-VD اضافه میکند که ثابت میکند مسیر پرامپت پس از بازآموزی همچنان فعال مانده است.
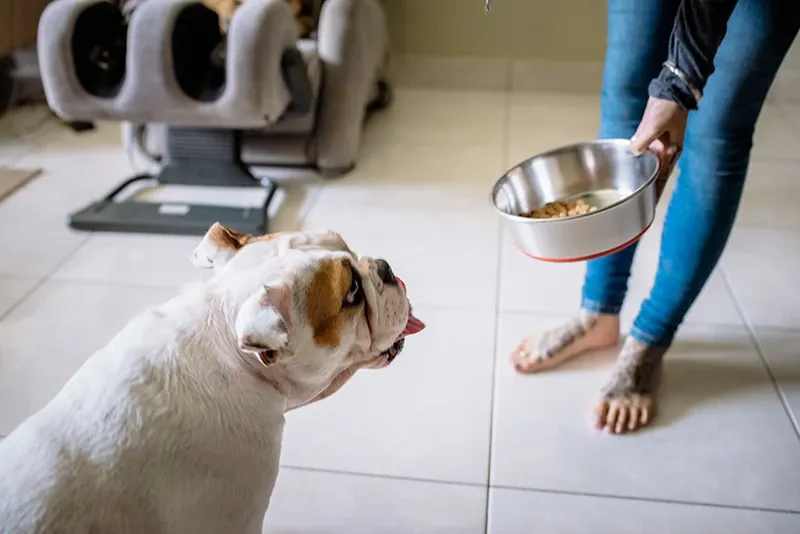
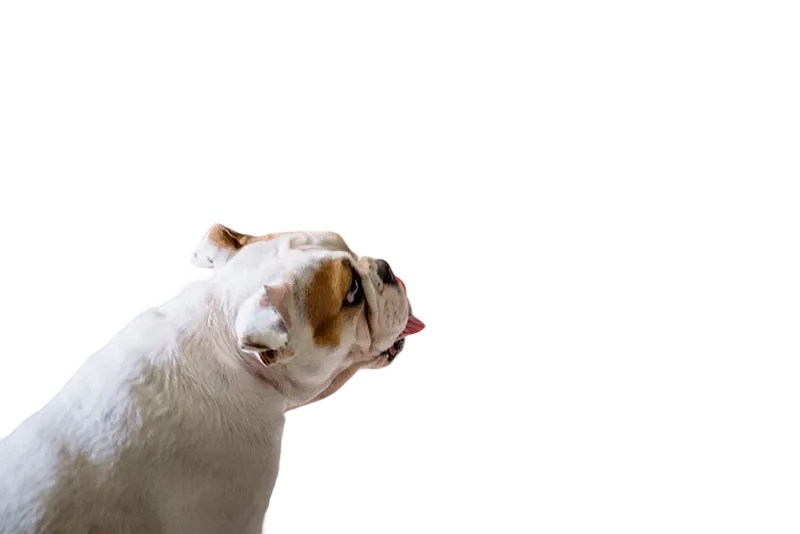
برای توسعهدهندگان، این مدل در کتابخانه NoBg ادغام شده است. کاربران میتوانند با دستور pip install nobg آن را نصب کرده و با فراخوانی تابع ساده predict و تعیین نام شیء مورد نظر (مثلاً "the dog")، مدل را پیادهسازی کنند.
این تغییر از «تشخیص» به «متینگ»، خط پایه ویرایش تصاویر مبتنی بر پرامپت را جابهجا میکند. Feyn ثابت کرد که مدلهای عظیم برای کسب قابلیتهای تخصصی و دقیق، نیازی به آموزش مجدد کامل ندارند و میتوان با لایههای کوچک به نتایج خیرهکننده رسید. در حالی که مدلهایی مانند NeoMME با بهینهسازی ذخیرهسازی بردارها بر کارایی زیرساختی تمرکز کردهاند، MultiMatte بر ارتقای کیفیت خروجی نهایی متمرکز است.
برای کاربر نهایی، این یعنی کیفیت «بریدن» (Cutout) در ابزارهای هوش مصنوعی از تخمینهای تقریبی به داراییهای آماده برای تولید صنعتی تبدیل میشود. توانایی هدایت مدل با کلمات برای مدیریت سختترین بخشهای تصویر — یعنی لبهها — گلوگاههای دستی در طراحی دیجیتال را از بین میبرد.
شما میتوانید دقت این مدل را روی تصاویر شخصی خود در وبسایت usefeyn.com/multimatte بررسی کنید یا پیادهسازی آن را در گیتهاب (GitHub) دنبال نمایید.
گام بعدی شما
- اگر توسعهدهنده هستید، کتابخانه NoBg را نصب کنید و تفاوت ماسکهای باینری و آلفا مت را روی تصاویر پیچیده تست کنید.
- برای طراحان، اکنون زمان جایگزینی ابزارهای سنتی حذف پسزمینه با مدلهای Promptable است تا سرعت گردش کار افزایش یابد.
- دقت مدل را روی تصاویر شخصی خود در وبسایت usefeyn.com/multimatte بررسی کنید.
اما این تنها بخشی از تحول در بینایی ماشین است؛ اثر مدلهای چندوجهی بر آینده عکاسی محاسباتی را در گزارش بعدی بررسی خواهیم کرد.



گفتگو