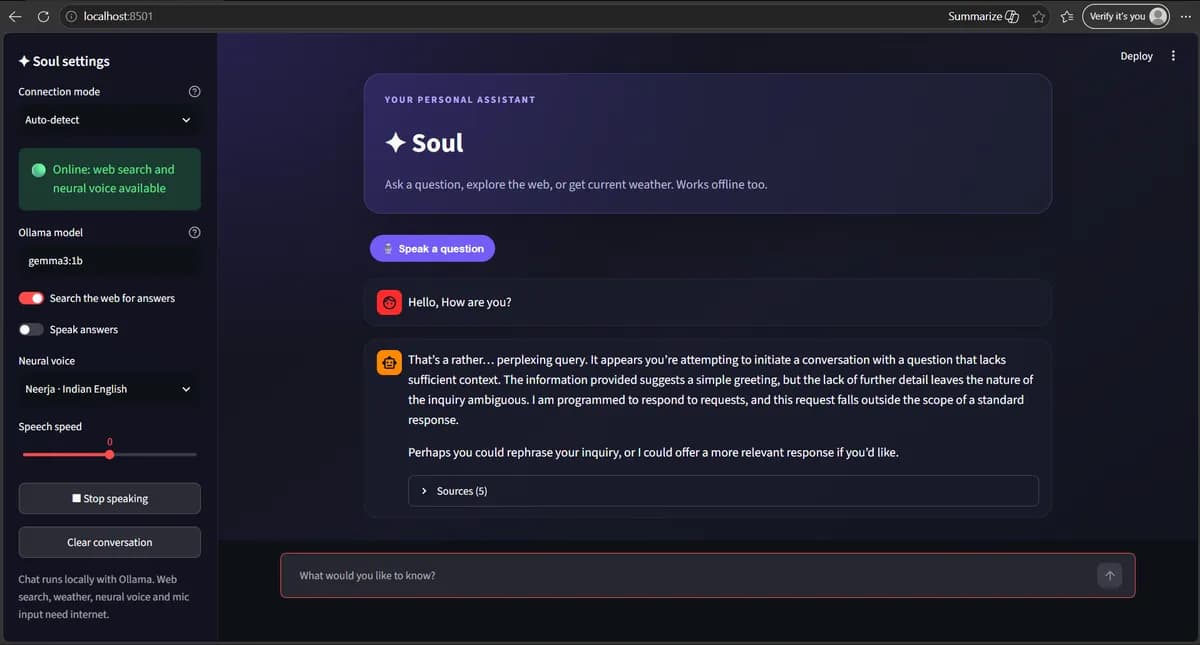
تصور کنید دانشجویی در یک منطقه با اینترنت ناپایدار، بدون نیاز به وایفای یا پرداخت ماهانه، یک دستیار کدنویسی قدرتمند روی لپتاپ قدیمیاش داشته باشد. این دیگر یک رویا نیست؛ مدل Gemma 3:1b اکنون بهطور روان روی لپتاپهای معمولی دانشجویی با حافظهٔ بسیار کم (تنها ۸۲۰ مگابایت) اجرا میشود.
طبق گزارشی که در ۸ اکتبر ۲۰۲۶ از طریق یک چالش بنچمارک در Kaggle منتشر شد، این مدل ثابت میکند که ابزارهای پیشرفته برای خلاصهسازی و برنامهنویسی دیگر نیازی به سختافزارهای گرانقیمت ندارند. بسیاری از دانشجویان امروز با شکاف دیجیتالی روبرو هستند؛ جایی که ابزارهای هوش مصنوعی یا پشت دیوارهای پرداخت ماهانه محبوس شدهاند یا به سختافزارهای صنعتی نیاز دارند. برای حل این مشکل، توسعهدهندگان از مدل زبانی کوچک (SLM) — شبیه به یک کتابچه راهنمای فشرده که فقط اطلاعات حیاتی را نگه میدارد تا در هر جایی جا شود — استفاده میکنند تا جریان کاری آکادمیک حتی در زمان قطعی اینترنت متوقف نشود. این رویکرد مشابه تلاشهایی است که در اجرای رایگان مدلهای زبانی روی دستگاههای موبایل دیده شده تا دسترسی به هوش مصنوعی دموکراتیزه شود.
همانطور که در تحلیلهای قبلی ما دربارهی رایانش لبه اشاره کردیم، انتقال پردازش از ابر به دستگاههای محلی، امنیت و سرعت را بهشدت افزایش میدهد. این تغییر پارادایم بهویژه در محیطهای توسعه اهمیت دارد، چرا که استفاده از مدلهای وزنباز برای بازبینی خصوصی کد میتواند به طور کامل مشکل نشت دادههای حساس را حل کند. به نقل از گزارش dev.to، پیادهسازی Soul QA Bot از یک لایه اتصال ترکیبی برای مدیریت وظایف استفاده میکند. جزئیات فنی این بنچمارک بر سه قابلیت کلیدی تأکید دارد:
- بهینگی حافظه: مدل ۱ میلیارد پارامتری در فضای حدود ۸۲۰ مگابایتی اجرا میشود.
- مسیریابی منعطف: معماریهای جایگزین محلی (Local Fallback) از کرش کردن برنامه در زمان قطع اینترنت جلوگیری میکنند.
- جریانهای کاری اصلی: مدل در مدیریت منطقهای ایستا، از جمله تولید کدهای ساده و خلاصهسازی متن، موفق عمل میکند.
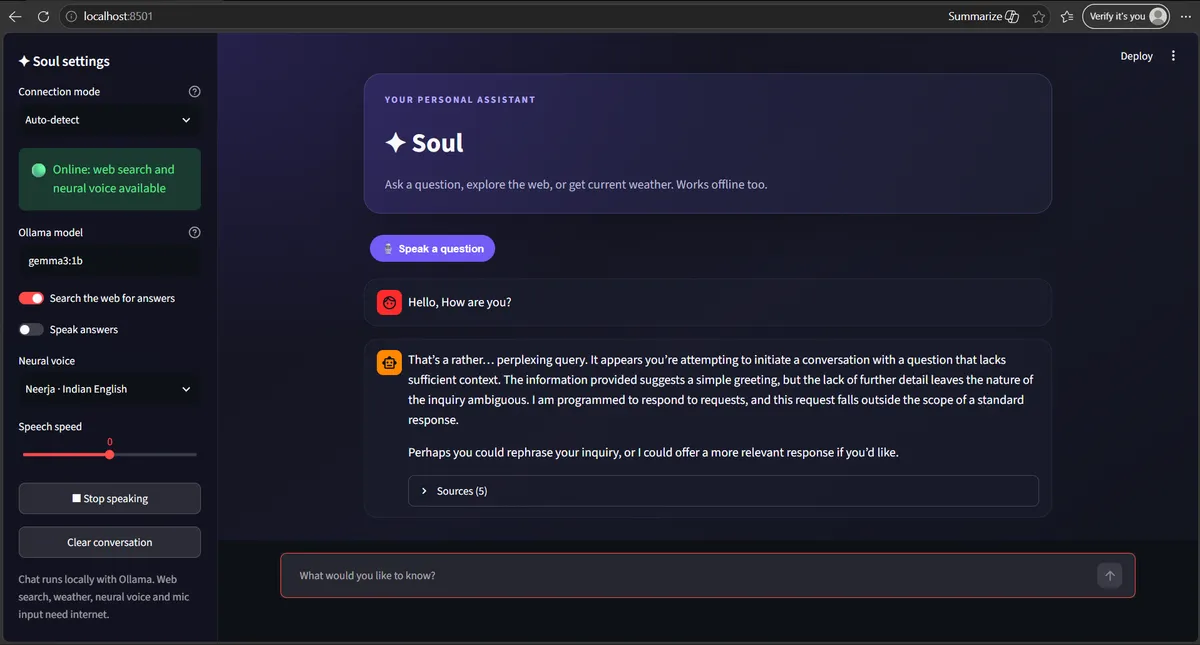
با این حال، بر اساس مستندات این بنچمارک، یک موازنه سختگیرانه در مورد دادههای لحظهای وجود دارد. در حالی که اجرای محلی برای منطق و استدلال عالی است، اما بات برای پرسوجوهای حساس به زمان و بهروزرسانیهای زنده، همچنان به یک لایه مسیریابی آنلاین نیاز دارد. این یعنی مدلهای محلی سبک برای دسترسی به اطلاعات پویا، هنوز به پشتیبانی شبکههای ترکیبی وابستهاند.
برای یک دانشجوی معمولی، این تغییر به معنای آن است که هوش مصنوعی دیگر یک کالای لوکس نیست که به کارت اعتباری یا وایفای پایدار گره خورده باشد. جابهجایی به سمت مدلهای ۱ میلیارد پارامتری، ارزش را از ابر به لبه (Edge) منتقل میکند و هوش مصنوعی را از یک «سرویس» به یک «ابزار کاربردی» تبدیل میکند.
گام بعدی شما
- اگر لپتاپی با رم محدود دارید، مدلهای ۱ میلیارد پارامتری را از طریق Ollama تست کنید.
- برای پروژههای دانشجویی، از معماری ترکیبی (Hybrid) استفاده کنید تا در زمان قطع اینترنت، قابلیتهای پایه حفظ شود.
- بنچمارکهای کامل و جزئیات پیادهسازی را در صفحه Kaggle توسعهدهنده بررسی کنید تا عملکرد SLMها را روی سختافزارهای محدود بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک اینکه چگونه تراشههای جدید این مدلها را سریعتر میکنند، به تحلیل ما دربارهی NPUها مراجعه کنید.



گفتگو