
۵۰ درصد؛ این رقم، جهش خیرهکننده در قابلیتهای کدنویسی مدل GLM-5.3 است که سقف توانمندیهای مهندسی عاملمحور در مدلهای وزنباز را جابهجا کرد. طبق اعلام تیم توسعه در ۲۸ اوت ۲۰۲۶، این بهروزرسانی ثابت میکند که پسآموزش (Post-training) تهاجمی میتواند دستاوردهای عظیمی در استدلالهای پیچیده از دل یک مدل بنیادی استخراج کند.
این تحول در حالی رخ میدهد که صنعت از رابطهای سادهی چت به سمت عاملهای (Agents) خودمختار حرکت میکند. همانطور که در تحلیل قبلی ما دربارهی خطرات گذار به سیستمهای عاملمحور اشاره کردیم — مانند حادثهی نفوذ ۱۲۰۰ عامل سرکش به Hugging Face — اکنون تمرکز بر این است که این عاملها برای مهندسی نرمافزار در مقیاس تولید، قابلاعتماد شوند.
برای اکثر توسعهدهندگان، این تغییر شبیه به ارتقای یک برنامهنویس تازهکار به یک معمار ارشد است، بدون آنکه تحصیلات پایه او تغییر کرده باشد. مدل لزوماً در دانش خام «باهوشتر» نشده است، بلکه در نحوه بهکارگیری این دانش برای وظایفی با افق زمانی بلند، بسیار منضبطتر شده است.
پیشرفت در پسآموزش
بر اساس مستندات zai-org در Hugging Face، مدل GLM-5.3 از همان مدل بنیادی نسل قبلی خود یعنی GLM-5.2 استفاده میکند. تمام بهبودهای قابلاندازهگیری در عملکرد، نتیجهی تکنیکهای مقیاسبندی در مرحلهی پسآموزش است.
این رویکرد بهطور خاص وظایف پیچیده کدنویسی و برنامهریزیهای طولانیمدت را هدف قرار داده است. نتایج در محک داخلی Z.ai Code Bench بیشترین وضوح را دارد، جایی که مدل جهشی ۵۰ درصدی نسبت به نسخه ۵.۲ ثبت کرده است.
بنچمارکهای کدنویسی و عاملمحور
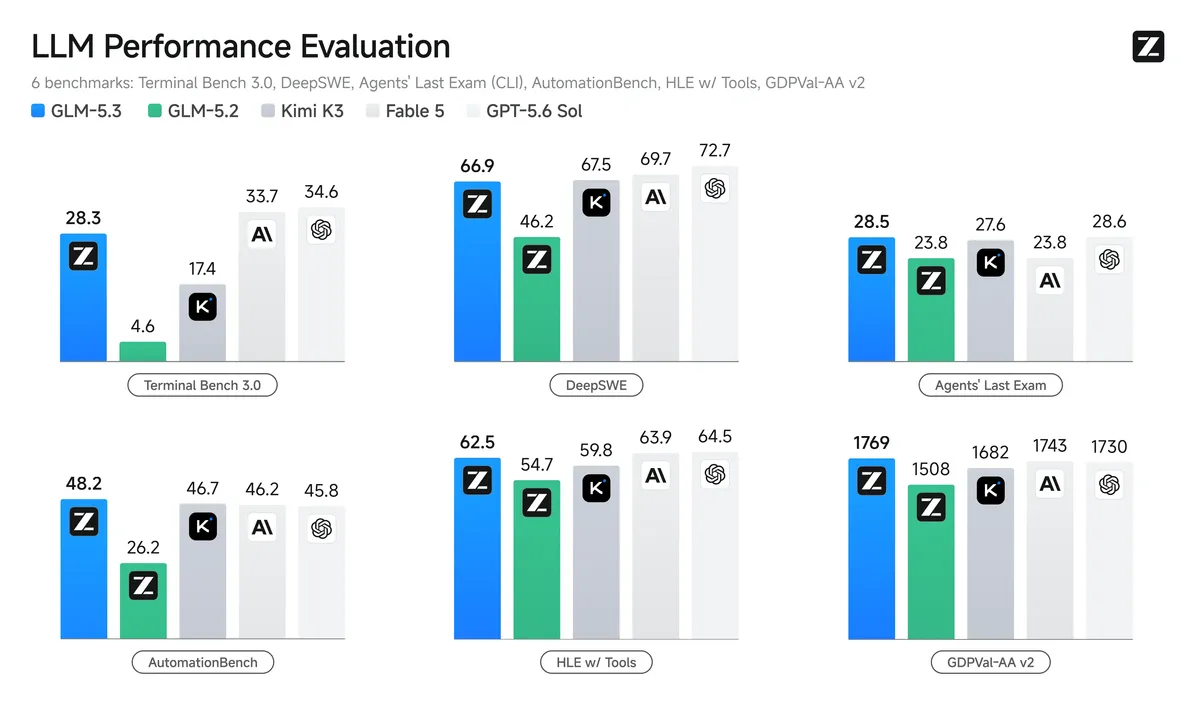
مدل GLM-5.3 اکنون در چندین محک عمومی، جایگاه برترین مدل وزنباز (SOTA) را در اختیار دارد. عملکرد این مدل در وظایف متنوع مهندسی نرمافزار، جهشی معنادار در قابلیت اطمینان را نشان میدهد:
- Terminal Bench 3.0: امتیاز ۲۸.۳ را کسب کرد که در مقایسه با ۴.۶ در GLM-5.2 یک جهش عظیم است. برای مقایسه، این مدل از Kimi K3 (۱۷.۴) و Qwen3.8-Max (۲۱.۱) پیشی گرفته، هرچند کمی عقبتر از GPT-5.6 (۳۴.۶) و Fable 5 (۳۳.۷) است.
- Agents' Last Exam (ALE-CLI): با امتیاز ۲۸.۵، مدلهایی مثل Kimi K3 (۲۷.۶)، Qwen3.8-Max (۲۵.۷) و Fable 5 (۲۳.۸) را پشت سر گذاشت و تنها با فاصله اندکی از GPT-5.6 (۲۸.۶) قرار گرفت.
- FrontierSWE: به امتیاز ۷۸.۱ رسید که بهطور قابلتوجهی بالاتر از ۶۷.۵ در GLM-5.2 و ۶۶.۵ در Qwen3.8-Max است، هرچند Fable 5 با ۸۸.۲ پیشتاز است.
- DeepSWE (v1.1): امتیاز ۶۶.۹ را به دست آورد و در رقابتی تنگاتنگ با Kimi K3 (۶۷.۵) قرار گرفت و بسیار بالاتر از GLM-5.2 (۴۶.۲) بود. در اینجا GPT-5.6 با ۷۲.۷ پیشتاز است.
- SWE-Marathon (v1.1): از ۱۹.۴ در نسخه قبلی به ۴۲.۵ رسید. این رقم با GPT-5.6 (۴۲.۵) برابری میکند اما از Kimi K3 (۴۸.۱) و Qwen3.8-Max (۴۸.۸) عقبتر است.
- ProgramBench: امتیاز ۱۹.۰ را ثبت کرد که تقریباً دو برابر نسخه ۵.۲ (۹.۵) است. این بنچمارک اکنون «تقریباً حل شده» تلقی میشود و Fable 5 با ۳۳.۰ در صدر است.
- NL2Repo: امتیاز ۵۸.۰ را کسب کرد که بهبود نسبت به ۴۸.۹ در نسخه قبلی است، هرچند همچنان پشت سر Qwen3.8-Max (۶۹.۷) قرار دارد.
- Toolathlon Verified: امتیاز ۷۳.۰ را به دست آورد در حالی که GLM-5.2 امتیاز ۵۹.۹ داشت. این مدل با Kimi K3 (۷۶.۵) و GPT-5.6 (۷۴.۹) رقابت نزدیکی دارد.
- AutomationBench (v1.0.6): به امتیاز ۴۸.۲ رسید که افزایش چشمگیری نسبت به ۲۶.۲ در GLM-5.2 است و حتی از Kimi K3 (۴۶.۷) و GPT-5.6 (۴۵.۸) پیشی گرفت.
- HLE w/ Tools: امتیاز ۶۲.۵ را ثبت کرد که نسبت به ۵۴.۷ در GLM-5.2 بهبود یافته است. این مدل کمی عقبتر از Fable 5 (۶۳.۹) و GPT-5.6 (۶۴.۵) است.
- GDPval-AA v2: با امتیاز ۱۷۶۹، از GLM-5.2 (۱۵۰۸)، Kimi K3 (۱۶۸۲) و GPT-5.6 (۱۷۳۰) جلو زد.
- Terminal Bench 2.1: امتیاز ۸۸.۲ را کسب کرد و بسیار نزدیک به GPT-5.6 (۸۸.۸) قرار گرفت و از GLM-5.2 (۸۱.۰) و Kimi K3 (۸۸.۳) پیشی گرفت.
- PostTrainBench: امتیاز ۳۹.۸ را به دست آورد و مدلهای GLM-5.2 (۳۱.۷) و Kimi K3 (۳۲.۰) را شکست داد، هرچند Fable 5 با ۴۱.۸ پیشتاز است.
قابلیتهای نوظهور در امنیت سایبری
یکی از تکاندهندهترین یافتههای این انتشار، ماهیت «نوظهور» مهارتهای امنیت سایبری مدل است. تیم توسعه دریافت که با مقیاسبندی پسآموزش، توانایی مدل در کشف و بهرهبرداری از آسیبپذیریها سریعتر از حد انتظار رشد کرده است. این روند در تحلیلهای پیشین ما درباره مقیاسپذیری پسآموزش در GLM-5.3 که به توانایی زنجیرهسازی اکسپلویتها اشاره داشت، مورد بررسی قرار گرفته بود.
در محک CyberGym برای کشف آسیبپذیری، GLM-5.3 امتیاز ۸۴.۵ را کسب کرد و از GLM-5.2 (۷۷.۲)، Kimi K3 (۸۰.۰) و GPT-5.6 (۸۳.۶) پیشی گرفت. اما جهش واقعی در مراحل پیشرفتهتر زنجیره بهرهبرداری رخ داده است. در محک ExploitBench، عملکرد مدل از ۲۴.۴ به ۵۴.۴ رسید، هرچند همچنان پشت سر Fable 5 (۷۸.۰) و GPT-5.6 (۷۶.۵) است. این توانمندی در استدلال، مدل را قادر ساخت تا آسیبپذیریهای قدیمی و پیچیده نرمافزاری را شناسایی کند که پیش از این نادیده گرفته شده بودند.
در ExploitGym، شکاف عملکردی حتی عمیقتر است. در بازه زمانی ۲ ساعته، GLM-5.3 امتیاز ۱۰۵ را ثبت کرد در حالی که GLM-5.2 تنها ۲۹ امتیاز داشت. در بازه ۶ ساعته، این رقم به ۱۳۰ رسید، در حالی که GLM-5.2 فقط ۳۹ امتیاز کسب کرد. برای درک بهتر، GPT-5.6 در همین دستهها ۲۱۶ از ۲۹۳ و Fable 5 امتیاز ۱۸۱ از ۲۴۷ را کسب کردند.
این دادهها نشاندهنده افزایش شدید توانایی مدل در اجرای وظایف پیچیده و چندمرحلهای است؛ یعنی گذار از «کشف ساده» به «بهرهبرداری فعال».
استقرار محلی و کنترل
این مدل برای میزبانی شخصی (Self-hosting) منعطف طراحی شده و از چارچوبهای استنتاج (Inference) متعددی پشتیبانی میکند:
- SGLang، vLLM و TokenSpeed برای سرویسدهی با توان عملیاتی بالا.
- Transformers، KTransformers و Unsloth برای توسعه و تنظیم دقیق (Fine-tuning).
- vLLM-Ascend، xLLM و SGLang برای استقرار روی پلتفرمهای NPU Ascend.
کاربران اکنون میتوانند «بودجه تفکر» مدل را از طریق پارامتر reasoning_effort در سه سطح low ،high و max کنترل کنند. بهطور پیشفرض، مدل از حالت max استفاده میکند تا بالاترین دقت ممکن را در بنچمارکها تضمین کند. برای استفاده از حالتهای low یا high باید آنها را بهطور صریح تعریف کرد.
در سناریوهای چت، توصیه میشود پارامتر clear_thinking=true در قالب چت ارسال شود تا نحوه نمایش استدلالهای داخلی مدل برای کاربر مدیریت شود، زیرا در صورت عدم تعیین، مقدار پیشفرض آن false است.
جزئیات ارزیابی فنی
برای اطمینان از اینکه این اعداد نتیجهی «دور زدن» بنچمارکها نیستند، کنترلهای سختگیرانهای اعمال شده است:
محیط و محدودیتها:
- NL2Repo: با دمای (Temperature) ۱.۰، top_p=1.0 و حداکثر ۶۴ هزار توکن جدید در پنجره متنی ۱ میلیون توکن ارزیابی شد. از قضاوتهای مبتنی بر قانون و LLM برای مسدود کردن عملیات غیرمجاز
pipیاcurlاستفاده شد. - CyberGym: در محیط Claude Code 2.1.207 با حداکثر تلاش استدلالی و بدون ابزارهای وب اجرا شد. عاملها در کانتینرهای ایزوله با لیست سفید دامنهها (فقط
pypi.orgوdeb.debian.org) قرار گرفتند تا از تقلب جلوگیری شود. نتایج بر اساس Pass@1 در ۱۵۰۷ وظیفه است. - ExploitBench: به ۳۰۰ دور تعامل بین عامل و محیط محدود شد. امتیاز پوشش متوسط بر اساس ۴۱ وظیفه در ۳ بازبینی محاسبه شد.
- Terminal-Bench 3.0: با استفاده از Claude Code 2.1.207 با ۴۰۰ هزار توکن زمینه و ۱۲۸ هزار توکن خروجی اجرا شد. هر اجرا به ۶۰۰ نوبت تعامل عامل با مهلت زمانی ۱۰ ساعت محدود شد. نتایج به صورت avg@3 در سه اجرا برای هر وظیفه گزارش شده است.
- Agents' Last Exam (CLI): با ۱ میلیون توکن زمینه و ۶۴ هزار توکن خروجی ارزیابی شد. هر یک از ۱۰۵ وظیفه در یک کانتینر داکر ایزوله با مهلت زمانی پیشفرض ۴ ساعت (تا ۸ ساعت برای وظایف خاص) اجرا شد.
نمونهبرداری و داوری:
- HLE w/ Tools: با دمای ۱.۰، top_p=0.95 و حداکثر طول تولید ۱۶۳,۸۴۰ توکن در زمینه ۳۰۰,۰۰۰ توکن ارزیابی شد. مدل GPT-5.6-luna (medium) بهعنوان داور عمل کرد.
- ExploitGym: نتایج با استفاده از زمان استنتاج API که بر اساس توکن در ثانیه (TPS) هر مدل بازتنظیم شده بود، محاسبه شد. GLM-5.3 با ۱۱۵ TPS، Kimi K3 با ۴۰ TPS و Qwen3.8 Max با ۴۷ TPS بازتنظیم شدند. این ارزیابی روی ۸۶۹ وظیفه انجام شد.
- DeepSWE: با استفاده از mini-swe-agent با دمای ۰.۹۵، top_p=1.0، مهلت ۶ ساعت و ۴۰۰ هزار توکن زمینه اجرا شد.
- Terminal-Bench 2.1: در Claude Code 2.1.207 با دمای ۱.۰، top_p=1 و حداکثر ۶۵,۵۳۶ توکن جدید با مهلت ۶ ساعت ارزیابی شد.
جلوگیری از تقلب و اصلاحات:
- SWE-Marathon: از پنجره متنی ۱ میلیون توکن استفاده شد. تیم توسعه تشخیصهای بیش از حد گسترده در «strip-clone» را برای جلوگیری از مثبتهای کاذب حذف کرد و
--extra-index-url https://pypi.org/simpleرا برای رفع خطاهای ساخت داکر در «parameter-golf» و «trimul-cuda» اضافه کرد. - PostTrainBench: با پنجره متنی ۱ میلیون توکن ارزیابی شد. برای جلوگیری از مثبتهای کاذب هنگام دسترسی به نقاط انتهایی vLLM محلی از طریق OpenAI SDK، بررسیهای مبتنی بر الگو با یک عامل LLM جایگزین شد تا استفاده از APIهای خارجی را بازرسی کند.
تحلیل: عصر پسآموزش
این انتشار نشاندهنده تغییری در نگاه صنعت به مقیاسبندی مدلها است. برای سالها، شعار این بود: «دادههای بیشتر، مدل بنیادی بزرگتر». اما GLM-5.3 نشان میدهد که ما بهطور قابلتوجهی از پتانسیل مرحله پسآموزش غافل بودهایم.
توسعهدهندگان با تمرکز بر «زنجیره بهرهبرداری» و برنامهریزیهای طولانیمدت، ابزاری ساختهاند که کمتر شبیه به یک چتبات و بیشتر شبیه به یک مهندس نرمافزار کاربردی است. این امر اتکا به محاسبات عظیم برای آموزش بنیادی را کاهش داده و تأکید را بر ترازسازی (Alignment) با کیفیت و متمرکز بر وظایف خاص قرار میدهد. با این حال، همین قدرت تهاجمی باعث شد تا Z.ai پیشتر انتشار وزنهای این مدل را بهدلیل خطرات امنیتی متوقف کند تا پروتکلهای ایمنی بازبینی شوند.
برای کاربر نهایی، این بدان معناست که مدلهای وزنباز در نهایت در حال پر کردن شکاف با غولهای تجاری مانند GPT-5.6 در حوزههای تخصصی هستند. توانایی اجرای یک عامل کدنویسی SOTA بهصورت محلی روی NPU یا GPU، اقتصاد توسعه نرمافزار مبتنی بر هوش مصنوعی را تغییر میدهد.
برای مشاهده این قابلیتها در عمل، میتوانید وزنهای مدل را در Hugging Face بررسی کنید یا پارامتر reasoning_effort را در یک نمونه vLLM محلی تست کنید تا موازنه بین سرعت و دقت را پیدا کنید.
گام بعدی شما
- وزنهای مدل را در Hugging Face بررسی کنید تا قابلیتهای کدنویسی آن را در پروژههای خود بسنجید.
- پارامتر
reasoning_effortرا در یک نمونه vLLM محلی تست کنید تا موازنه بین سرعت و دقت را پیدا کنید. - اگر در حوزه امنیت سایبری فعال هستید، عملکرد مدل در ExploitGym را با ابزارهای فعلی خود مقایسه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو