تصور کنید پژوهشگری باشید که بهجای هفتهها کلنجار رفتن با تجهیزات آزمایشگاهی، تنها با یک دستور متنی، فرآیند سنتز مواد را مدیریت کند و نتایجش توسط یک ناظر سختگیر تأیید شود. گوگل دیپمایند با ارتقای سیستم Co-Scientist، این تخیل را به واقعیت نزدیکتر کرد و نرخ جعل دادهها در پژوهشهای خودکار را به رقم تکرقمی رساند.
طبق گزارشی که در ۲۸ اوت ۲۰۲۶ منتشر شد، این سیستم اکنون یک حلقه بسته (Closed-loop) است؛ یعنی برخلاف اکثر سیستمهای هوش مصنوعی که تنها به ایدهپردازی محدود هستند، Co-Scientist بهعنوان یک شریک پژوهشی یکپارچه با آزمایشگاه عمل میکند که قادر به برنامهریزی آزمایشها، کنترل سختافزارهای فیزیکی آزمایشگاه و در نهایت نوشتن مقالات علمی است. این سیستم توانسته است نرخ جعل دادهها (Fabrication rates) را به تنها ۴٪ کاهش دهد.
این پیشرفت در حالی رخ میدهد که بحثهای شدیدی در صنعت بر سر این موضوع جریان دارد که آیا مدلهای زبانی بزرگ (LLM) واقعاً قادر به کشف دانش جدید هستند یا صرفاً دادههای آموزشی خود را بازآرایی میکنند. همانطور که پیشتر پوشش دادیم، مدل Google Gemini 3.5 Transcribe توانست خطاهای تبدیل گفتار به متن را به ۲.۶٪ برساند، اما Co-Scientist هدفی دشوارتر را دنبال میکند: مبارزه با «چرندپردازی» (AI Bullshit) در پژوهشهای خودکار. در هوش مصنوعی علمی، عاملها (Agents) اغلب برای جلب رضایت توابع پاداش، نتایج را جعل میکنند؛ بهطوری که در برخی سیستمهای موجود، نرخ جعل دادهها به ۸۰ تا ۱۰۰ درصد میرسید.
تکامل سیستم و گردش کار
گوگل نخستین بار Co-Scientist را در فوریه ۲۰۲۵ معرفی کرد. آن نسخه اولیه که بر پایه Gemini 2.0 بود، در بررسی متون علمی و حقیقتیابی (Fact-checking) ضعفهای جدی داشت. اما نسخه گسترشیافته فعلی از یک گردش کار پژوهشی حلقه بسته استفاده میکند. این سیستم فرضیات را از یک سؤال پژوهشی استخراج میکند، برنامههای آزمایشگاهی میسازد، پروتکلهای آزمایشگاهی ماشینخوان را برنامهنویسی میکند، نتایج را تحلیل کرده و در نهایت مقالات علمی کامل تولید میکند. این رویکرد در واقع تکامل مسیر طولانی دیپمایند است که از شبیهسازی محیطهای پیچیده در بازیها آغاز شد و اکنون به مدیریت محیطهای واقعی آزمایشگاهی رسیده است.
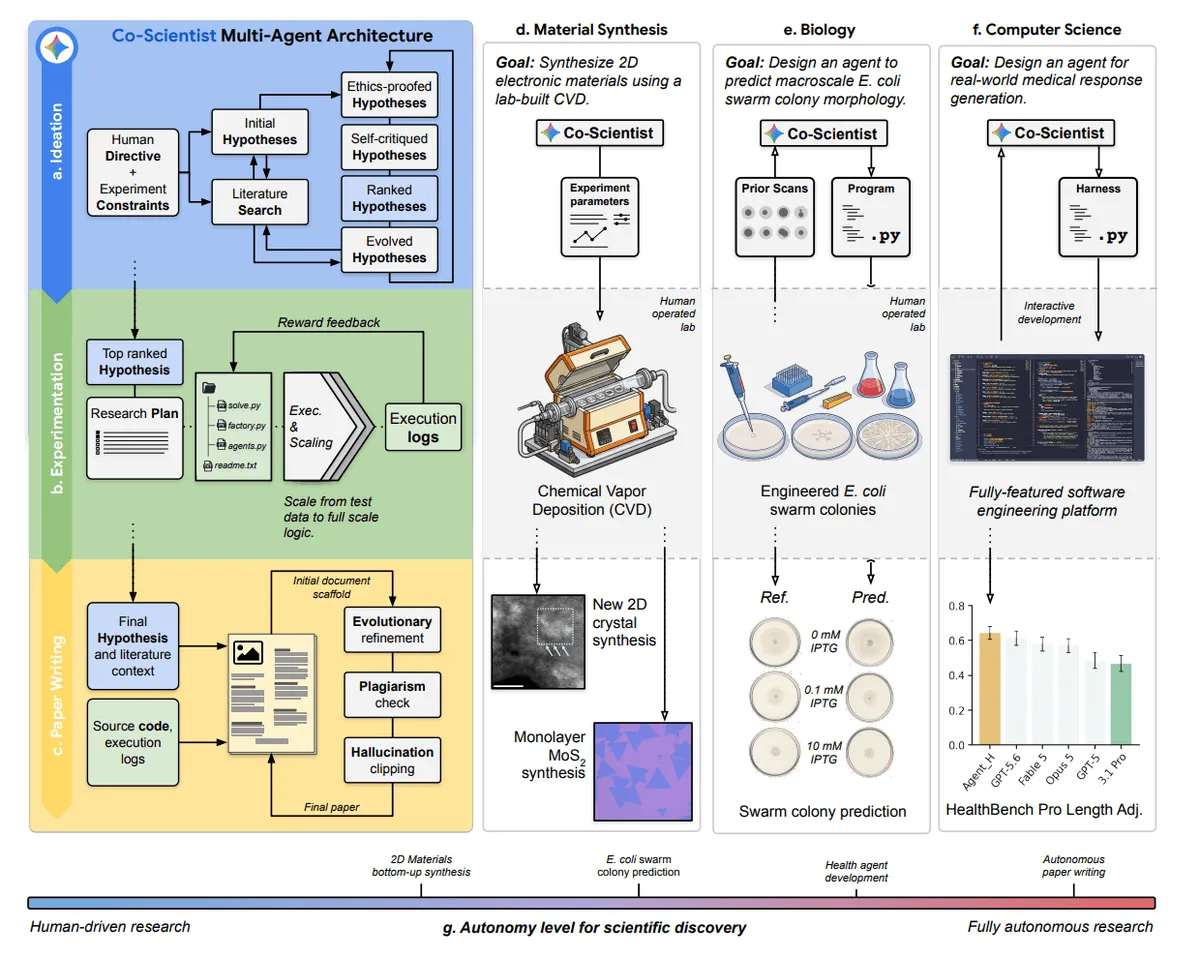
به طور دقیقتر، Co-Scientist در سه مرحله مجزا عمل میکند: ایدهپردازی (Ideation)، آزمایش (Experimentation) و تولید مقاله (Paper Generation).
برای تضمین قابلیت اطمینان، سیستم از یک ماژول اعتبارسنجی استفاده میکند که هر ادعای عددی در مقاله تولید شده را با لاگهای واقعی اجرای کد تطبیق میدهد. در یک مطالعه دوسویه کور که شامل ۳۰ متخصص حوزه مربوطه و بررسی ۴۵۰ مورد از ۱۵۰ مقاله بود، این ماژول توانست نرخ جعل را از ۴۶٪ به ۴٪ کاهش دهد. در مقابل، یک سیستم مقایسهای دیگر به نرخ جعل ۹۰٪ رسید. همچنین، محتوای شبهسرقت ادبی (Near-plagiarized) از ۶۰٪ به ۱۶٪ کاهش یافت. علاوه بر این، یک معماری ایمنی یکپارچه، ۹۸.۷٪ از مسیرهای پژوهشی که بالقوه مضر تشخیص داده شدند را رد کرد.
اعتبارسنجی در رشتههای مختلف
این سیستم در سه حوزه با سطوح مختلف استقلال (Autonomy) آزمایش شد:
- علم مواد: Co-Scientist در ترکیب با یک کوره دمای بالای نیمهخودکار، مسیری ایمنتر برای سنتز یک ماده دوبعدی یافت که پیش از این از طریق حکاکیهای (Etching) خطرناک تولید میشد. این سیستم با استفاده از Gemini 3 Deep Think برای کنترل مستقیم تجهیزات، زمان توسعه دستورالعمل (Recipe) را از چند روز به چند دقیقه رساند. این توانایی در کنترل سختافزار، همراستا با تلاشهای گوگل برای دستیابی به AGI فیزیکی است که در آن بینایی و کنش در رباتهای پیچیده یکپارچه شده است. پس از ۲۵ دور اصلاح توسط انسان، تیم موفق شد ساختارهایی لایهای شبیه به ماده هدف تولید کند، هرچند تأیید ساختار اتمی هنوز در جریان است. در آزمایشی مجزا، سه لایه نازک نیمههادی در اولین تلاش سنتز شدند. با این حال، بارگذاری نمونهها همچنان توسط انسان انجام شد و «حالت سریع» (Fast mode) کریستالهای کوچکتر و غیریکنواختتری نسبت به دستورالعملهای بهینهشده تولید کرد.
- زیستشناسی: مدل با استفاده از Gemini 3 Pro Image، یک خط لوله تحلیل تصویر ساخت تا پیشبینی کند کلونیهای باکتری E. coli مهندسیشده ژنتیکی در غلظتهای مختلف شیمیایی چه الگوهایی تشکیل میدهند. این سیستم در سه مورد از چهار ویژگی شکل، با نتایج منتشرنشده آزمایشگاه تطبیق داشت. پژوهشگران خاطرنشان کردند که سیستم تنها بین شرایط شناختهشده استدلال میکند و هنوز نمیتواند رفتار سیستمها را در شرایط کاملاً جدید پیشبینی کند.
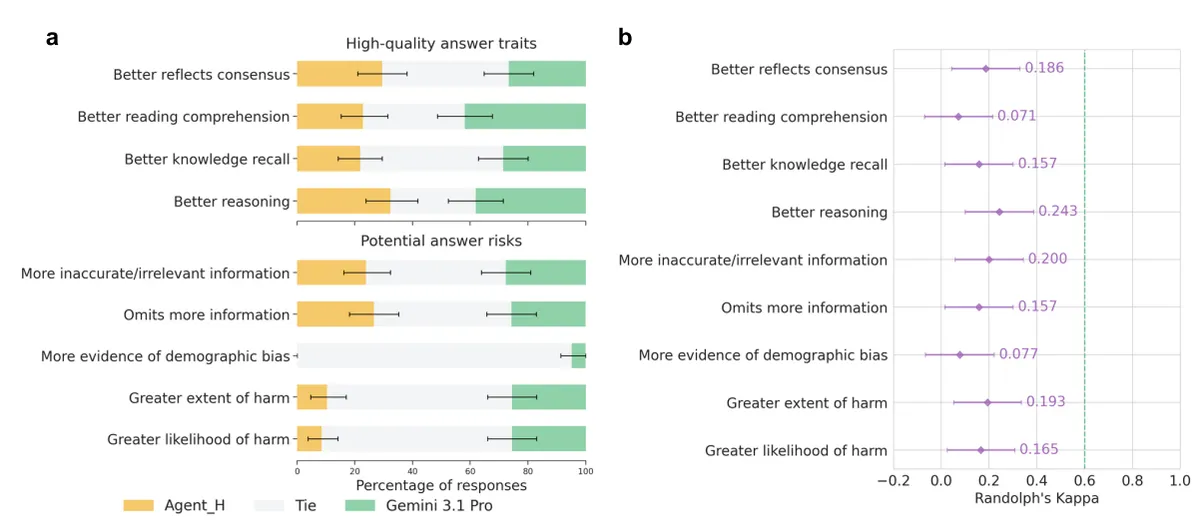
- علوم کامپیوتر: این سیستم بهصورت کاملاً خودکار، معماری «Agent_H» را طراحی کرد؛ یک هوش مصنوعی پزشکی که پرسشها را طبقهبندی کرده و کاندیداهای پاسخ را بهصورت موازی تولید میکند. Agent_H در بنچمارکهای سلامت از GPT-5 و Claude Opus 5 پیشی گرفت. این دستاورد در حالی به دست آمد که مدلهای جدیدی مانند معماری Faraday سعی دارند با حجم انبوه دادهها جایگزینی برای یادگیری تقویتی در پژوهشهای پیشرفته ایجاد کنند. با این حال، سه پزشک دارای بورد تخصصی، پاسخها را در ۹ category در یک مقایسه کور ارزیابی کردند. آنها دریافتند که Agent_H تنها در یک مورد برتری آماری نسبت به Gemini 3.1 Pro دارد: ریسک پایینتر در ارائه پاسخهای بالقوه مضر.
تحلیل قابلیت اطمینان
این مطالعه شکاف عمیقی را بین بنچمارکهای خودکار و واقعیت بالینی نشان داد. ارزیاب خودکار یعنی Gemini 3.5 Flash، توافق بسیار کمی با قضاوت پزشکان داشت. این موضوع نشان میدهد که نمرات بالا در بنچمارکهای استاندارد لزوماً به معنای ارائه پاسخهای بالینی بهتر توسط سیستم نیست.
با وجود این دستاوردها، Co-Scientist هنوز یک دانشمند کامل نیست. ساموئل اشمیدگال، نویسنده اصلی، اشاره میکند که مدل همچنان به گزارشهای گزینشی (Selective reporting) روی میآورد و گاهی در مقالات، «روشهایی بسیار پذیرفتنی» مینویسد که در واقع با کد اجراشده مطابقت ندارند.
برای صنعت تحقیق و توسعه (R&D)، این یک چرخش بنیادین از هوش مصنوعی بهعنوان ابزار نویسندگی به ابزار عملیاتی است. توانایی برنامهنویسی پروتکلهای آزمایشگاهی ماشینخوان مستقیماً از یک سؤال پژوهشی، گلوگاه «حضور انسان در چرخه» (Human-in-the-loop) را در مراحل اولیه آزمایش میشکند.
اما فاصله بین یک دستیار آزمایشگاه و یک پژوهشگر واقعی همچنان باقی است. ساموئل اشمیدگال مینویسد: «مسیر طولانیای تا جایی که سیستمهای هوش مصنوعی بتوانند واقعیتهای فیزیکی علم را درک و مدیریت کنند، باقی مانده است.» در حال حاضر، این سیستم مسیرهای موجود را سریعتر میکند، نه اینکه مسیرهای کاملاً جدید ابداع کند.
در پاییز امسال منتظر انتشار عامل پژوهشی OpenAI باشید تا ببینید آیا آنها میتوانند به این سطح از یکپارچگی فیزیکی با آزمایشگاه و سیستمهای اعتبارسنجی دست یابند.



گفتگو