تصور کنید مدلی با ۷۴۰ میلیون پارامتر که در بنچمارکهای چندوجهی، رقبایی با دو برابر این اندازه را پشت سر میگذارد. EmbeddingGemma 2 که در ۶ اکتبر ۲۰۲۶ منتشر شد، به توسعهدهندگان اجازه میدهد متن، تصویر، ویدیو، صوت و کد را بدون نیاز به APIهای ابری به بردار معنایی (Embedding) — شبیه کارت معرفی عددی برای هر واژه که میگوید این کلمه «همسایهی» چه کلمات دیگری است — تبدیل کنند.
این عرضه در حالی رخ میدهد که صنعت به سمت هوش مصنوعی حریمخصوصیمحور و اجرا روی دستگاه (On-device) حرکت میکند. همانطور که در تحلیل قبلی ما دربارهی ابزارهای کمکبینایی گوگل اشاره کردیم، این مدل لایهی هوشمند را به کاربر نزدیکتر میکند. در واقع، شما میتوانید موتور جستوجویی داشته باشید که فایلها و ویدیوهای محلی شما را فوراً بفهمد، بدون اینکه دادهای از لپتاپتان خارج شود. این قابلیت در واقع تکامل یافتهی همان رویکردی است که در مدل EmbeddingGemma برای پیادهسازی جستوجوی معنایی آفلاین در مخازن گیتهاب به کار گرفته شده بود.
به گزارش وبسایت the-decoder.com، این مدل بر پایهی Gemma 4 ساخته شده و در یک فضای ۷۶۸-بعدی عمل میکند. مشخصات فنی کلیدی این مدل عبارتند از:
- عملکرد: کسب امتیاز ۷۸.۶۸ در محک Massive Text Embedding (بخش کد)، که تقریباً ۱۰ امتیاز بیشتر از نسل قبلی است.
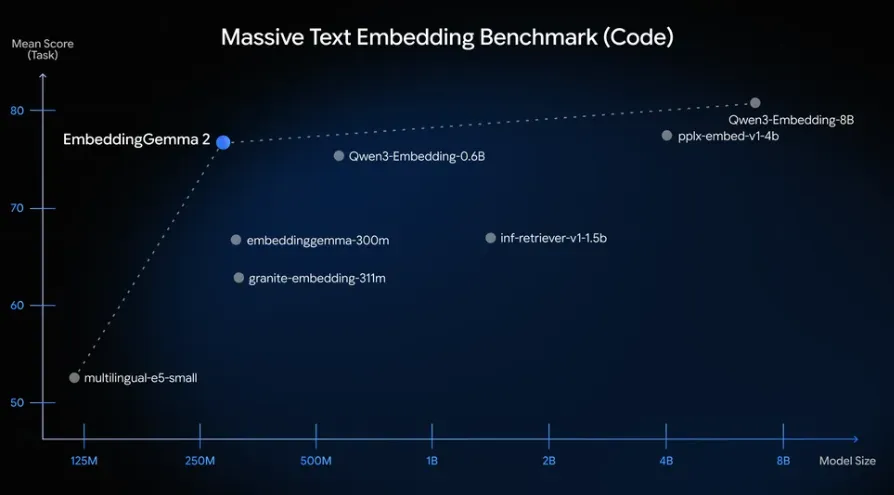
- بهینگی: نیاز به تنها ۱۹۱ مگابایت رم و کاهش فضای ذخیرهسازی پایگاهداده برداری محلی تا ۶ برابر. این بهینهسازی حافظه در راستای تلاشهای گستردهتر برای شکستن محدودیتهای رم در مدلهای زبانی از طریق استریم SSD صورت گرفته است.
- سرعت: تأخیر پرسوجو بین ۲۰ تا ۷۰ میلیثانیه از طریق WebGPU در مرورگر.
- دسترسی: توزیع تحت لایسنس Apache 2.0 با پنجره متنی (Context Window) — میزان متنی که مدل همزمان «در ذهن» نگه میدارد، شبیه میز کاری که جا برای چند ورق دارد — به اندازه ۸ هزار توکن.
برای صاحبان کسبوکار، این یعنی حذف «مالیات API» و تأخیرهای مربوط به بازیابی ابری. شرکتها میتوانند با ترکیب این مدل و مدلهای باز کوچک، اپلیکیشنهای تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — را بهصورت آفلاین، سریعتر و امنتر مستقر کنند. این اتفاق عملاً سد سختافزاری برای جستوجوی معنایی باکیفیت را میشکند.
در حال حاضر توسعهدهندگان میتوانند وزنهای این مدل را در Hugging Face و Kaggle دریافت کنند. این مدل از Ollama و llama.cpp GGUF نیز پشتیبانی میکند.
گام بعدی شما
- اگر از پایگاهدادههای برداری ابری استفاده میکنید، هزینه و تأخیر مدل محلی EmbeddingGemma 2 را با زیرساخت فعلی خود مقایسه کنید.
- برای پیادهسازی RAG آفلاین، ترکیب این مدل با مدلهای زبانی کوچک (SLM) را در محیطهای محدود تست کنید.
- بررسی کنید که آیا دقت این مدل در دستهبندی دادههای اختصاصی شما با مدلهای غولپیکر ابری تفاوت محسوسی دارد یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو