اگر امروز برای استقرار عاملهای کدنویسی بودجه محدودی دارید، گوگل بازی را تغییر داد. مدل جدید Gemini 3.8 Flash اکنون میتواند کارهای پیچیده مهندسی نرمافزار را با دقتی انجام دهد که پیش از این فقط در مدلهای بسیار گرانقیمت دیده میشد.
طبق اعلام گوگل در ۲ سپتامبر ۲۰۲۶، این مدل در محک DeepSWE v1.1 به امتیاز ۷۳.۷٪ رسید. این عدد یعنی یک مدل «بودجهای» حالا میتواند با مدلهای پیشرو جهان در مهندسی نرمافزار رقابت کند. این رویکرد یادآور رقابتهای اخیر در بازار مدلهای اقتصادی است، مشابه زمانی که مدل GLM-5.3-Flash توانست با هزینهای بسیار اندک با مدلهای پیشرو رقابت کند.
این عرضه در حالی رخ میدهد که گوگل در یک چرخه شتابزده از بهروزرسانی مدلهای اقتصادی قرار دارد. این سومین عرضه از خانواده Flash در عرض تنها شش هفته است که پس از Gemini 3.7 Flash صورت میگیرد. این ریتم سریع نشاندهنده یک چرخش استراتژیک به سمت بهینهسازی نسبت قیمت به عملکرد است؛ آن هم در حالی که مدلهای پیشرو و مورد انتظار شرکت، یعنی Gemini 3.5 Pro و Gemini 4، هنوز در دسترس نیستند.
همانطور که در تحلیل قبلی ما دربارهی گسترش تهاجمی اکوسیستم گوگل اشاره کردیم، این شرکت اکنون روی کیف پول توسعهدهندگان تمرکز کرده است. گوگل میخواهد پیش از آنکه OpenAI یا Anthropic استانداردهای سازمانی را تثبیت کنند، بازار گردشکارهای عاملمحور (Agentic) — شبیه به داشتن دستیاران دیجیتالی که میتوانند بهطور مستقل پروژه را پیش ببرند — را با مدلهای ارزان و توانمند تصاحب کند. این استراتژی در راستای تلاشهای گستردهتر گوگل برای کاهش هزینههای پردازشهای حجیم در مدلهای جدید خود و xAI قرار دارد.
کورای کاووکچیوglu، رئیس جدید دیپمایند، تأکید کرده است که هدف گوگل تنها بهینهسازی قیمت نیست. او تصریح کرد که این شرکت همچنان قصد دارد در زمینه توانمندیهای خام (Raw Capability) نیز پیشرو بماند و جایگاه خود را در صدر حفظ کند.
عملکرد و محکها
مدل Gemini 3.8 Flash بهعنوان یک اسب کاری برای استدلال و کدنویسی طراحی شده است. امتیاز ۷۳.۷٪ آن در DeepSWE، این مدل را در فاصله بسیار اندکی از Claude Opus 5 (۷۴٪) قرار میدهد و آن را بهطور واضح از GPT-5.6 Sol (۷۲.۷٪)، Claude Sonnet 5 (۵۳.۸٪) و نسخه قبلی یعنی ۳.۷ فلش (۶۵.۳٪) جلو میاندازد.
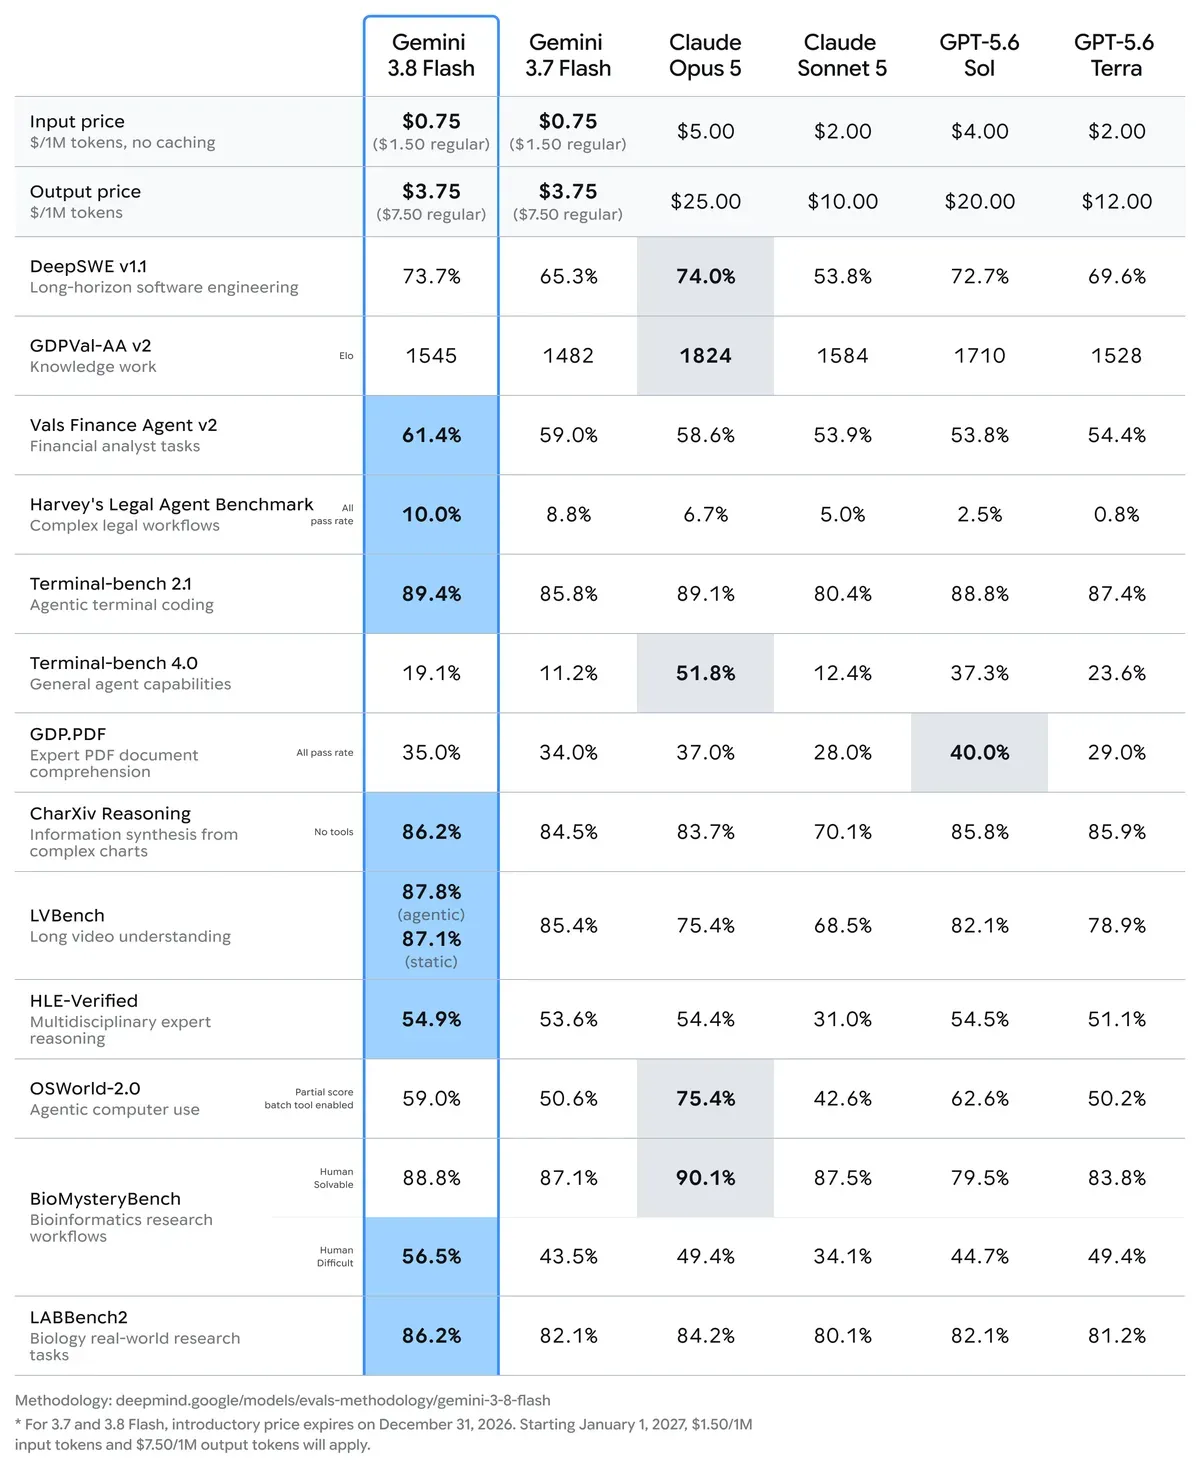
به نقل از مستندات گوگل، این مدل در بسیاری از محکها عملاً مدلهای Opus 5 و GPT-5.6 Sol را «میبلعد»، هرچند گوگل اعتراف میکند که عملکرد در دنیای واقعی ممکن است با این اعداد مصنوعی متفاوت باشد.
علاوه بر کدنویسی، این مدل در تولید سه-بعدی پیشرفت چشمگیری داشته است. گزارش شده که Gemini 3.8 Flash با استفاده از ابزار کدنویسی Antigravity و مدل تصویری Nano Banana، میتواند تنها با یک پرامپت، یک بازی سه-بعدی با بافتهای کامل بسازد.
موازنه هزینه و هوشمندی
گوگل از استراتژی قیمتگذاری تهاجمی برای جذب کاربر استفاده میکند. در حال حاضر، هزینه هر میلیون توکن (Token) — تکههای کوچکی از متن که مدل مثل برشهای کیک میخورد — برای ورودی ۰.۷۵ دلار و برای خروجی ۳.۷۵ دلار است. این مبلغ بهطور قابلتوجهی کمتر از Claude Opus 5 (۵/۲۵ دلار) و GPT-5.6 Sol (۴/۲۰ دلار) است.
البته این قیمتها از ژانویه ۲۰۲۷ افزایش مییابد و به ۱.۵۰ دلار برای ورودی و ۷.۵۰ دلار برای خروجی میرسد. حتی پس از این افزایش، این مدل همچنان ارزانترین گزینه در میان مدلهای سطح اول (Top-tier) خواهد بود.
اما یک نکته وجود دارد: مدل در کارهای پیچیده «سختتر تلاش میکند». گوگل توضیح میدهد که ۳.۸ فلش مراحل استدلال اضافی و فراخوانیهای ابزاری مکرر (Iterative tool calls) را اجرا میکند. این موضوع باعث افزایش مصرف توکن میشود و ممکن است هزینه نهایی هر تسک را بالا ببرد، حتی اگر قیمت هر توکن پایین باشد.
برای کاربردهایی که بهرهوری محاسباتی اولویت است، گوگل دو راه پیشنهاد میدهد:
- استفاده از سطوح استدلال پایینتر برای کاهش سربار توکنها.
- استفاده از مدل Gemini 3.7 Flash که همچنان پشتیبانی میشود.
اعتبارسنجی مستقل
مؤسسه Artificial Analysis این پیشرفتها را با امتیاز ۵۹ در شاخص هوشمندی تأیید کرده است. این عدد سه امتیاز بیشتر از نسخه ۳.۷ فلش (۵۶) است و Gemini 3.8 Flash را همتراز با GPT-5.6 Sol (در حالت استدلال بالا) و Grok 4.6 (در حالت استدلال متوسط) قرار میدهد که هر دو امتیاز ۵۹ را کسب کردهاند.
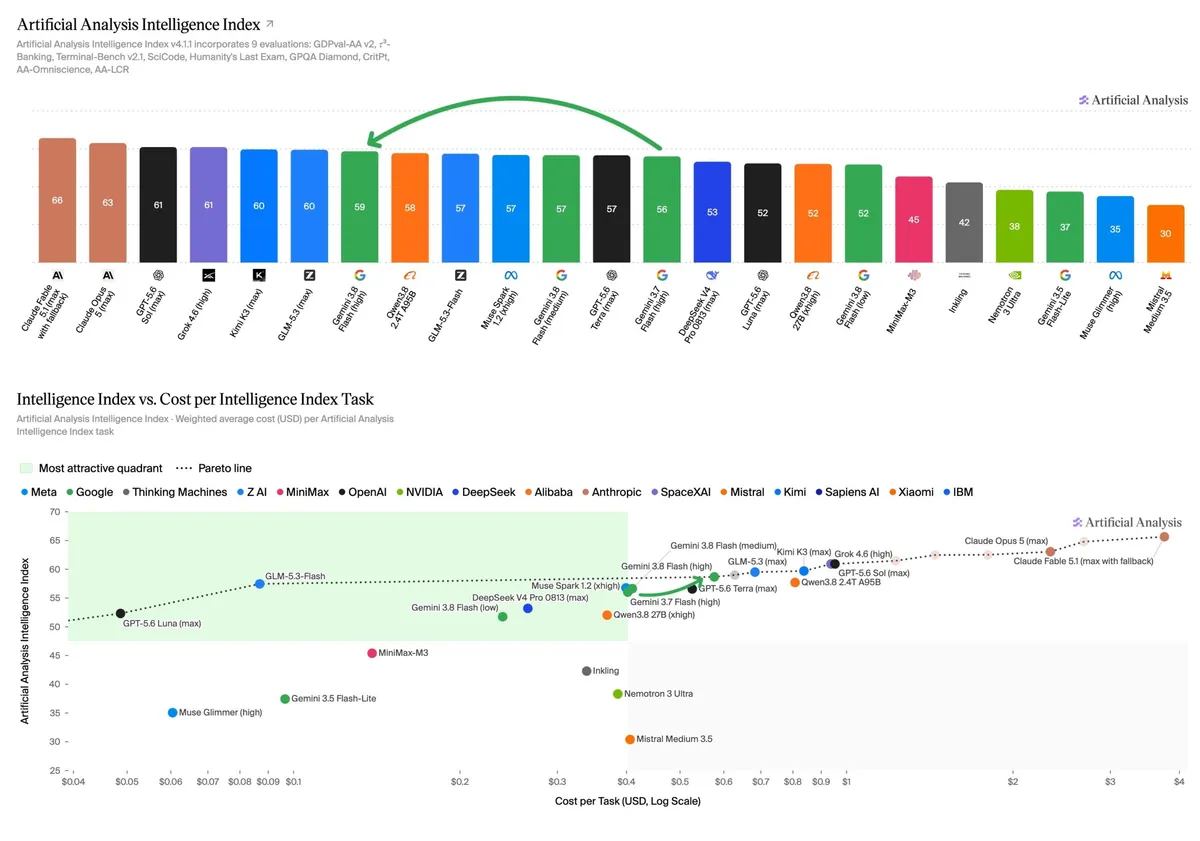
بر اساس بررسیهای این مؤسسه، این رشد عمدتاً ناشی از عملکرد بهتر در محکهای عاملمحور، بهویژه در استفاده از ابزار و تسکهای کدنویسی است.
در نمودار هزینه-عملکرد (Pareto frontier)، این مدل ارزانترین گزینه در سطح هوشمندی خود است و هر تسک را ۰.۵۸ دلار تمام میکند. با این حال، این رقم ۴۰٪ بیشتر از هزینه ۰.۴۰ دلاری در نسخه ۳.۷ فلش است؛ به همین دلیل گوگل برای کارهای حساس به هزینه، نسخه قدیمیتر را توصیه میکند.
سرعت مدل بسته به سطح استدلال متفاوت است:
- استدلال بالا: تولید حدود ۳۰۰ توکن در ثانیه با میانگین زمان ۲.۵ دقیقه برای هر تسک. این سرعت از GPT-5.6 Luna (۲.۶ دقیقه) و GPT-5.6 Terra (۳.۳ دقیقه) بیشتر، اما از Claude Fable 5.1 (۲.۱ دقیقه) و ۳.۷ فلش (۲.۲ دقیقه) کمتر است.
- استدلال پایین: میانگین زمان هر تسک به حدود ۴۸ ثانیه کاهش مییابد.
دفاع تخصصی در امنیت سایبری
گوگل همزمان مدل Gemini 3.8 Flash Cyber را نیز عرضه کرد. این نسخه عمومی نیست و از طریق برنامه Fairwind در اختیار آژانسهای دولتی، توسعهدهندگان نرمافزارهای متنباز و اپراتورهای زیرساختهای حیاتی قرار میگیرد.
این مدل تخصصی برای تسهیل کارهای دفاعی، محدودیتهای ایمنی کمتری نسبت به نسخه استاندارد دارد. معیارهای عملکرد آن عبارتند از:
- CyberGym (تشخیص آسیبپذیری C/C++): امتیاز ۸۶.۲٪ که از GPT-5.6 Sol (۸۳.۶٪)، GPT-5.5-Cyber (۸۵.۶٪) و نسخه قبلی ۳.۵ فلش سایبر (۷۷.۵٪) بالاتر است.
- CWE-Bench (وصله خودکار): نرخ Pass@1 معادل ۴۷.۲٪ که تقریباً با مدل پیشرو در این زمینه (۴۷.۸٪) برابری میکند.
ایمنی اولویت اصلی است. در محک Gray Swan IPI برای تزریق پرامپت (Prompt Injection) — تلاشی برای فریب دادن مدل جهت دور زدن حفاظها — نرخ موفقیت حمله به این مدل تنها ۵.۵٪ است. این نتیجه بهطور چشمگیری بهتر از DeepSeek V4 Pro (۶۰.۱٪)، Kimi K3 (۵۲.۷٪) و Grok 4.6 (۵۱.۸٪) است و تنها از Claude Opus 5 (۴.۸٪) عقبتر است.
پیامدهای بازار
گوگل در حال تبدیل استدلالهای سطح بالا به یک کالای ارزان و در دسترس است. با ارائه قابلیتهای «پیشرو-لایت» با قیمتی بسیار پایین، گوگل رقبایش را مجبور میکند یا قیمتها را کاهش دهند یا ثابت کنند مدلهای عظیمشان جهشی کیفی دارند که قیمت ۵ تا ۱۰ برابر بیشتر را توجیه کند.
برای یک کسبوکار معمولی، این یعنی سد ورود برای استقرار عاملهای خودمختار در حال فروپاشی است. دیگر برای اجرای مدلهایی که کارهای پیچیده مهندسی نرمافزار را انجام میدهند به بودجههای کلان نیاز ندارید، به شرطی که بتوانید مصرف توکنهای بیشتر در استدلالهای «سخت» را مدیریت کنید.
دسترسی به این مدل از طریق اکوسیستم گوگل فراهم است:
- توسعهدهندگان: Google AI Studio، Android Studio و Antigravity.
- کسبوکارها: Gemini Enterprise.
- کاربران: اپلیکیشن Gemini، حالت AI در جستوجوی گوگل و Google Sheets (برای مشترکین پرداختکننده).
گام بعدی شما
- اگر از مدلهای گرانقیمت برای کدنویسی استفاده میکنید، Gemini 3.8 Flash را در Google AI Studio تست کنید تا ببینید آیا کاهش هزینه بدون افت کیفیت ممکن است.
- برای تسکهای تکراری و ساده، از سطح استدلال پایین (Low Reasoning) استفاده کنید تا هزینه توکنها به حداقل برساند.
- توسعهدهندگان امنیت را میتوانند برای دسترسی به نسخه Cyber، شرایط برنامه Fairwind را بررسی کنند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو