صورتحساب استنتاج شما برای هر میلیون توکن ورودی تنها ۰.۱۵ دلار خواهد بود؛ عددی که نسبت هزینه به هوشمندی را در تولیدات هوش مصنوعی بازتعریف میکند. GLM-5.3-Flash که در ۲۶ اوت ۲۰۲۶ توسط شرکت Z.ai منتشر شد، تواناییهای استدلالی مدلهای غولپیکر را با کسری از هزینههای معمول فراهم میکند.
این عرضه در حالی رخ میدهد که آزمایشگاههای چینی فشار قیمتی را بر ارائهدهندگان غربی افزایش دادهاند. این روند را پیشتر در عرضه مدل DeepSeek V4 Flash مشاهده کردیم که توانست با هزینهای بسیار کمتر، با مدلهای پیشرو برابری کند. برای مدیران کسبوکار، این یعنی قابلیتهای استدلالی پیشرفته از لایههای گرانقیمت و تخصصی به ابزارهای ارزان و مقیاسپذیر تبدیل میشوند. تصور کنید گردشهای کاری عاملمحور (Agentic) — شبیه به داشتن دستیاران دیجیتالی که میتوانند بهتنهایی برنامهریزی و اجرا کنند — را بهجای دلار، با چند سنت اجرا کنید.
همانطور که در تحلیلهای قبلی ما دربارهی رقابت سختافزاری مدلهای بازمتن اشاره کردیم، شکستن انحصار سختافزاری کلید کاهش هزینههاست. طبق دادههای Artificial Analysis، مشخصات فنی این مدل عبارت است از:
- معماری: ۳۲۰ میلیارد پارامتر کل، که تنها ۱۸ میلیارد از آنها فعال هستند.
- شاخص هوشمندی: ۵۷ امتیاز، همسطح با GPT-5.6 Terra و Muse Spark 1.2.
- پنجره متنی (Context Window) — مثل میز کاری که تعیین میکند مدل همزمان چه مقدار اطلاعات را در ذهن نگه دارد — یک میلیون توکن است.
- مجوز: تحت لایسنس MIT و با وزنهای باز (Open Weights) — یعنی دستور پخت مدل علناً منتشر شده — در Hugging Face در دسترس است.
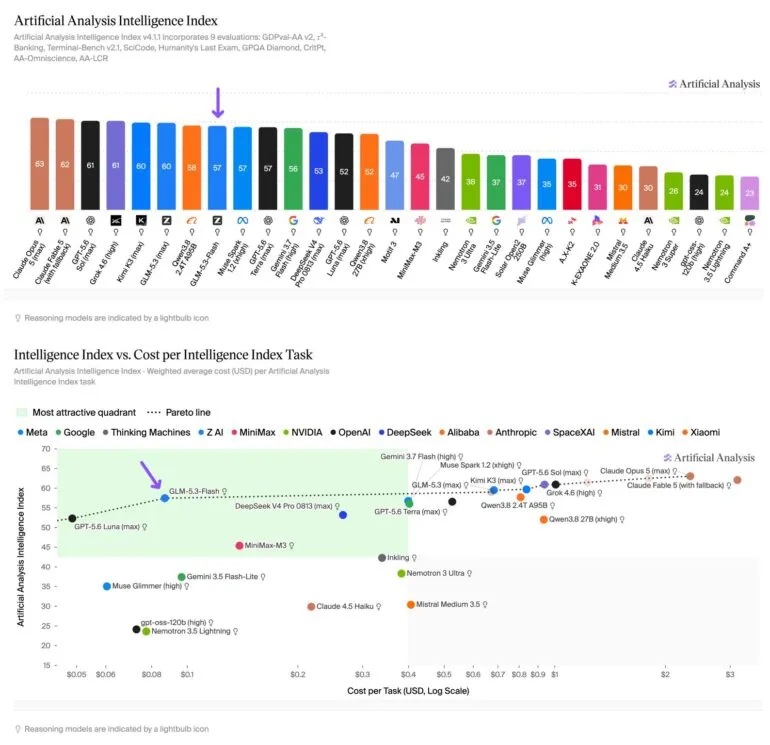
به گزارش منابع فنی، این مدل در وظایف عاملمحور بسیار رقابتی است و در محک GDPval-AA v2 به امتیاز ۱۷۷۰ رسید که آن را همتراز با Grok 4.6 قرار میدهد. در این زمینه، مدل Qwen3.8 Max نیز با استدلالهای قدرتمند در بازار حضور دارد، هرچند هزینههای عملیاتی آن به مراتب بالاتر است. با این حال، بازدهی توکنهای آن پایین است؛ چراکه طبق بررسی Artificial Analysis، حدود ۹۰٪ توکنهای خروجی صرف زنجیره تفکر (Chain-of-Thought) — شبیه به وقتی شاگرد ریاضی پای تخته بلند بلند فکر میکند تا به جواب برسد — میشود.
اما داستان اصلی در زیرساخت است. Z.ai این مدل را با نام مستعار ox-alpha در OpenRouter آزمایش کرد و روزانه ۱۰۰ تریلیون توکن را کاملاً روی تراشههای چینی سرو کرد. پیش از این تصور میشد چنین حجمی تنها برای آزمایشگاههای بزرگی که از سختافزار انویدیا استفاده میکنند ممکن است. در حالی که انویدیا با مدلهایی نظیر Nemotron 3.5 Lightning بر روی سرعت استنتاج متمرکز شده است، Z.ai مسیر متفاوتی را برای بهینهسازی هزینه برگزیده است.
برای عبور از سد نرمافزاری CUDA، شرکت Z.ai نرمافزار سرویسدهی اختصاصی خود را بر پایه SGLang ساخت. آنها با تقسیم پردازش به مراحل مستقل، توان عملیاتی (Throughput) را سه برابر کردند. جالب اینجاست که یک عامل مبتنی بر خودِ GLM-5.3 در بهینهسازی این سیستم کمک کرده است.
این پیشرفت ثابت میکند وابستگی به اکوسیستم انویدیا مانع مطلق برای رسیدن به عملکرد مدلهای پیشرو نیست. برای صنعت، این سیگنالی است از آیندهای که تنوع سختافزاری میتواند هزینه هوشمندی را باز هم پایینتر بکشد.
گام بعدی شما
- اگر از مدلهای گرانقیمت برای استخراج داده یا استدلال استفاده میکنید، مدل GLM-5.3-Flash را در Hugging Face تست کنید.
- بررسی کنید که آیا گردشهای کاری شما با پذیرش نرخ توکنهای داخلیِ بیشتر (برای استدلال)، کاهش هزینه را میپذیرند یا خیر.
- تحولات قیمتگذاری APIهای غربی را زیر نظر بگیرید تا ببینید آیا برای رقابت با کف قیمتی جدید چینیها، قیمتها را کاهش میدهند یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو