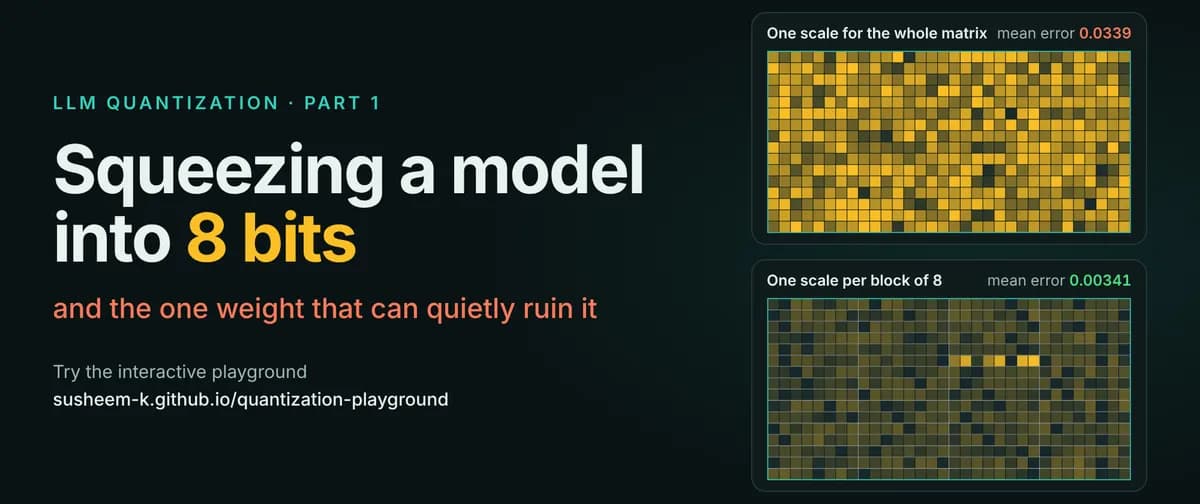
تصور کنید یک خطای کوچک در تنظیمات یک خطکش، تمام اندازهگیریهای یک پروژه عظیم مهندسی را خراب کند. در مدلهای زبانی بزرگ، وجود تنها یک «وزن پرت» (Outlier Weight) میتواند بهطور نامحسوس دقت میلیاردها پارامتر دیگر را هنگام فشردهسازی از بین ببرد. این شکست پنهان زمانی رخ میدهد که بزرگترین مقدار در یک ماتریس وزنی، مقیاس (Scale) را برای تمام اعداد دیگر تعیین کند؛ اتفاقی که باعث میشود وزنهای دقیق به تخمینهایی زمخت و بیدقت تبدیل شوند.
همانطور که در تحلیل قبلی ما دربارهی MLX و بهرهوری تنظیم دقیق مدلهای کوچک روی سختافزارهای محلی اشاره کردیم، صنعت اکنون روی این موضوع متمرکز است که چگونه مدلهای تریلیون-پارامتری را در حافظه محدود GPU جای دهیم. گلوگاه اصلی معمولاً خودِ محاسبات ریاضی نیست، بلکه زمانی است که صرف خواندن وزنها از حافظه و انتقال آنها به هستههای GPU میشود. این چالشهای انتقال داده، محوریت راهکارهای جدید برای شتاببخشی به تولید توکنها را تشکیل میدهند تا سرعت استنتاج بدون افت کیفیت افزایش یابد.
طبق یک راهنمای فنی که در ۱۱ اکتبر ۲۰۲۶ توسط وبسایت dev.to منتشر شد، هدف از کوانتش (Quantization) کاهش تعداد بایتهای هر وزن است. برای یک مدل ۸ میلیارد پارامتری، انتقال از Float16 (۲ بایت برای هر وزن) به INT8 (۱ بایت برای هر وزن)، نیاز حافظه را از ۱۶ گیگابایت به ۸ گیگابایت کاهش میدهد.
چرا کوانتش میکنیم؟
مدلهای زبانی همچنان در حال رشد هستند و برخی اکنون به مرز تریلیون پارامتر رسیدهاند. از آنجا که یک مدل در واقع میلیاردها یا تریلیونها عدد یادگرفتهشده (وزنها) است، اندازه کل مدل حاصل یک محاسبه ساده است: تعداد وزنها ضربدر بایتهای هر وزن.
اکثر وزنها بهصورت اعداد ممیز شناور ذخیره میشوند. فرمت Float32 از ۴ بایت برای هر وزن استفاده میکند، در حالی که Float16 و BFloat16 از ۲ بایت استفاده میکنند. این فرمتها اجازه میدهند تا مدل دارای محدوده وسیع و دقت بسیار بالایی باشد. در مقابل، INT8 یک عدد صحیح ۸ بیتی ساده است که تنها ۱ بایت اشغال میکند و فقط ۲۵۶ مقدار ممکن (از ۱۲۸- تا ۱۲۷) را ارائه میدهد.
محاسبه حافظه برای یک مدل ۸ میلیارد پارامتری به این شکل است:
- Float32: ۴ بایت برای هر وزن = ۳۲ گیگابایت
- Float16 / BFloat16: ۲ بایت برای هر وزن = ۱۶ گیگابایت
- INT8: ۱ بایت برای هر وزن = ۸ گیگابایت
باید توجه داشت که جای دادن وزنها در حافظه با اجرای مدل متفاوت است. اگرچه ۸ گیگابایت وزن INT8 ممکن است در یک GPU ۸ گیگابایتی جا شود، اما مدل برای اجرا به حافظه اضافی نیاز دارد.
مزیت سرعت
مدلهای کوچکتر به دو دلیل اصلی استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند — را سریعتر میکنند. اول، اگر مدل کوچکتر بهطور کامل در GPU جا شود در حالی که نسخه بزرگتر جا نمیشود، سیستم از «بازی بازیابی» (Playing Fetch) یا همان بیرون کشیدن وزنها از حافظه بسیار کندتر CPU اجتناب میکند.
دوم، حتی وقتی هر دو نسخه در GPU جا شوند، مدل کوچکتر سریعتر است. برای تولید هر توکن، GPU باید وزنها را از حافظه داخلی خود به هستههای محاسباتی منتقل کند. این فرآیند خواندن معمولاً گلوگاه است، نه خودِ ریاضیات. بایتهای کمتر برای هر وزن به معنای زمان کمتر برای خواندن است.
مکانیسم «خطکش»
کوانتش مانند خطکشی با ۲۵۶ علامت مساوی عمل میکند (برای INT8). تصور کنید خطکشی از ۰ تا ۲۵۵ دارید. اگر ۱۰۰۰ عدد بین ۰ و ۲۵۵۰ داشته باشید، میتوانید با تقسیم هر عدد بر ۱۰، آنها را به علامتها اختصاص دهید. عدد ۵۱۰ روی علامت ۵۱ قرار میگیرد و مقدار حداکثری ۲۵۵۰ روی علامت ۲۵۵ میافتد.
- کوانتش: تقسیم یک وزن بر مقیاس و گرد کردن آن به نزدیکترین علامت عدد صحیح.
- دکوانتش: ضرب مجدد آن عدد صحیح در مقیاس برای بازیابی عدد قابل استفاده.
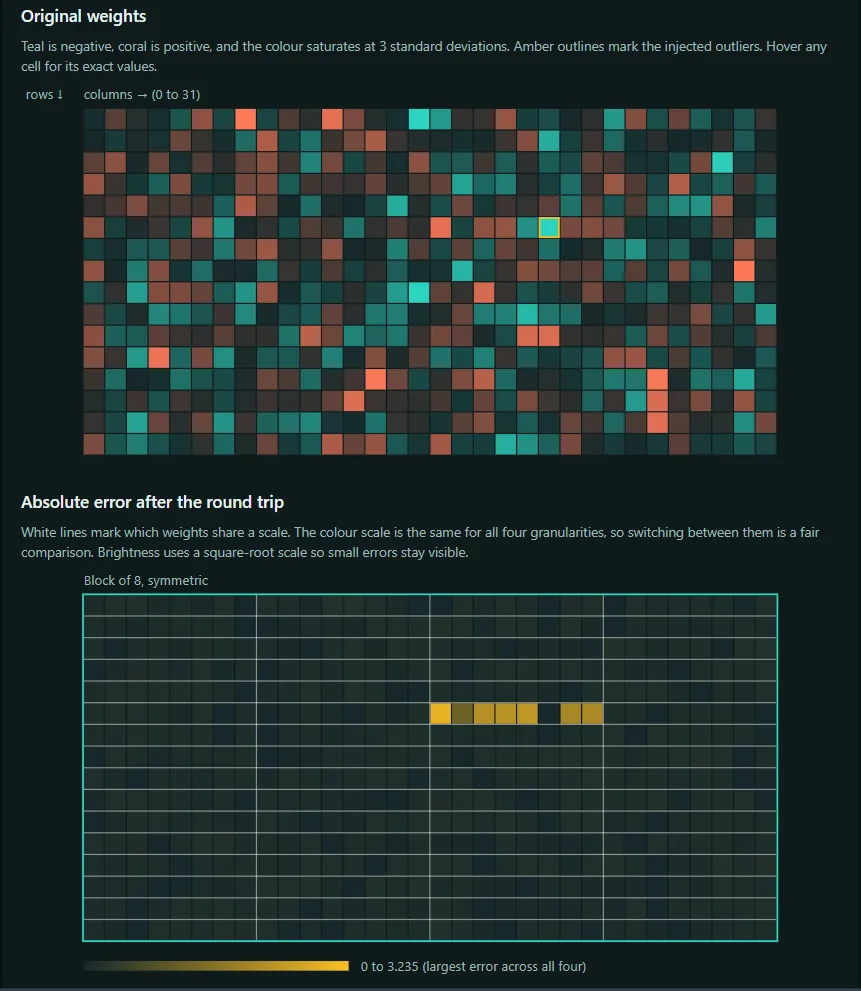
از آنجا که مقادیر ممیز شناور بسیار بیشتر از علامتهای عدد صحیح هستند، چندین وزن مختلف اغلب روی یک علامت میافتند. برای مثال، هر دو عدد ۵۱۰ و ۵۱۱ تقسیم بر ۱۰ به علامت ۵۱ گرد میشوند. هنگام تبدیل بازگشتی، هر دو تبدیل به ۵۱۰ میشوند. این تفاوت همان «خطای کوانتش» است که کیفیت خروجی مدل را کاهش میدهد.
عددی که برای تقسیم استفاده میشود (در این مثال ۱۰)، مقیاس (Scale) یا اندازه گام نامیده میشود. این مقدار از تقسیم بزرگترین عدد بر آخرین علامت (۲۵۵۰ تقسیم بر ۲۵۵ = ۱۰) به دست میآید. برای وزنهای واقعی INT8، خطکش جابهجا میشود تا بازه ۱۲۸- تا ۱۲۷ را پوشش دهد تا صفر در وسط قرار گیرد و وزنهای منفی را نیز بپذیرد.
مقیاسبندی متقارن در برابر نامتقارن
دو روش اصلی برای تراز کردن این خطکش وجود دارد.
کوانتش متقارن خطکش را روی صفر متمرکز میکند و بزرگترین وزن را دقیقاً روی آخرین علامت (۱۲۷) قرار میدهد. برای مثال، اگر بزرگترین وزن ۲.۵۴ باشد، مقیاس برابر با ۲.۵۴ تقسیم بر ۱۲۷ است که میشود ۰.۰۲. این روش از نظر محاسباتی ارزانتر است چون ریاضیات اعداد صحیح بدون نیاز به اصلاح نقطه صفر، سادهتر است.
کوانتش نامتقارن زمانی استفاده میشود که وزنها بهطور مساوی حول صفر پخش نشده باشند. اگر مقادیر بین ۰ تا ۱۰۰۰ باشند، کوانتش متقارن نیمی از خطکش (بخش منفی) را هدر میدهد. کوانتش نامتقارن خطکش را جابهجا میکند تا اولین علامت روی کوچکترین مقدار و آخرین علامت روی بزرگترین مقدار قرار گیرد.
- دقت (Granularity): در بازه ۰ تا ۱۰۰۰، مقیاس نامتقارن گامی حدود ۳.۹ (۱۰۰۰ تقسیم بر ۲۵۵) دارد، در حالی که گام متقارن حدود ۷.۹ (۱۰۰۰ تقسیم بر ۱۲۷) است. این یعنی دقت دو برابر بیشتر.
- هزینه (Trade-off): چون ۰.۰ دیگر روی مقدار ۰ در INT8 قرار نمیگیرد، باید یک مقدار اضافی به نام «نقطه صفر» (Zero-point) ذخیره کنید تا مشخص شود کدام علامت نماینده ۰.۰ است. در مثال ۰ تا ۱۰۰۰، مقدار ۰.۰ روی علامت ۱۲۸- قرار میگیرد.
مشکل مقادیر پرت (Outliers)
سیستم زمانی میشکند که یک «مقدار پرت» — وزنی که بهطور قابلتوجهی بزرگتر از بقیه است — وارد ماتریس شود. چون مقیاس توسط حداکثر مقدار تعیین میشود، یک وزن عظیم، خطکش را برای همه کش میآورد.
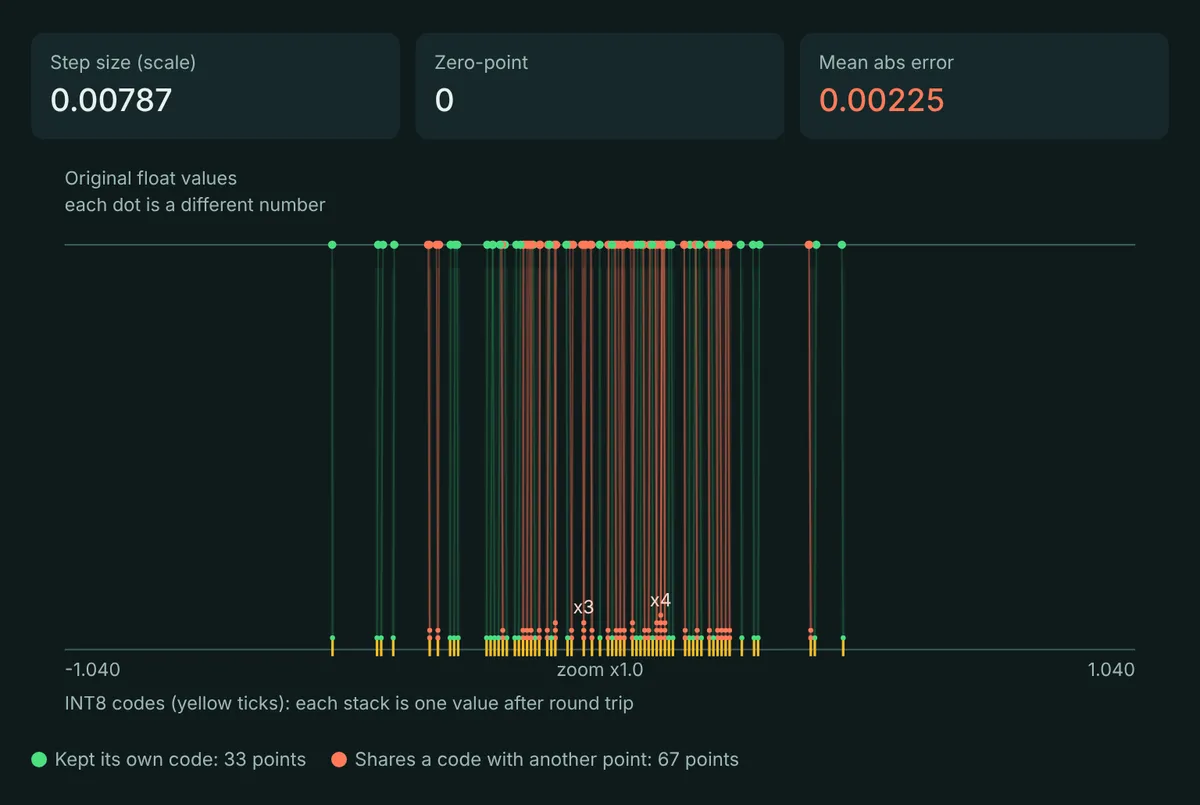
پنج وزن را در نظر بگیرید: [-۱.۲۱۳, ۰.۳۰۱, ۰.۳۰۹, ۰.۹۰۷, ۲.۵۴]. با مقیاس ۰.۰۲، خطاها بسیار ناچیز هستند (مثلاً ۰.۳۰۱ تبدیل به ۰.۳۰ میشود). اما اگر یک مقدار پرت مثل ۲۵.۴ اضافه کنیم، مقیاس به ۲۵.۴ تقسیم بر ۱۲۷ میپرد که میشود ۰.۲. حالا وزن ۰.۳۰۱ به ۰.۴۰ گرد میشود؛ خطایی معادل یکسوم مقدار واقعی آن.
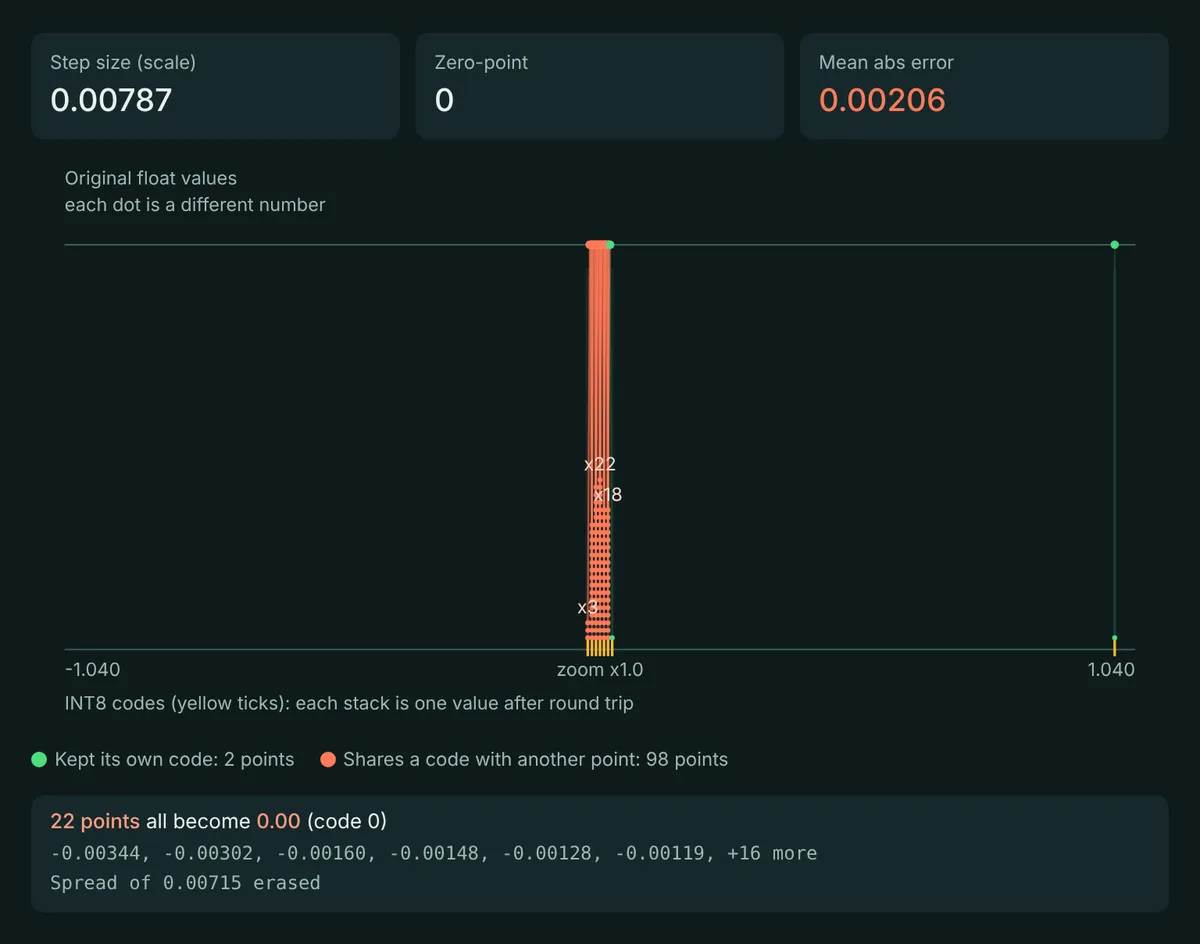
اگر ۹۹ وزن نزدیک صفر باشند و یک وزن ۱.۰ باشد، مقیاس برای جای دادن آن ۱.۰ گسترش مییابد. این باعث میشود ۹۹ وزن دیگر روی تنها چند علامت سقوط کنند؛ در برخی موارد، ۲۲ وزن مختلف همگی تبدیل به ۰.۰۰ میشوند. در یک تست روی ۴۰۹۶ وزن تصادفی، تغییر تنها یک مقدار به یک مقدار پرت بزرگ، خطای ۴۰۹۵ وزن باقیمانده را تقریباً ۱۲.۸ برابر افزایش داد.
مهار شعاع تخریب
مهندسان از دو روش اصلی برای جلوگیری از تخریب مدل توسط مقادیر پرت استفاده میکنند:
۱. برش (Clipping): خطکش کوچک نگه داشته میشود و هر وزنی که از حد مجاز فراتر رود، به آخرین علامت چسبانده میشود. اگرچه این کار به مقدار پرت آسیب میزند (مثلاً ۲۵.۴ تبدیل به ۲.۵۴ میشود)، اما دقت اکثریت وزنها را حفظ میکند.
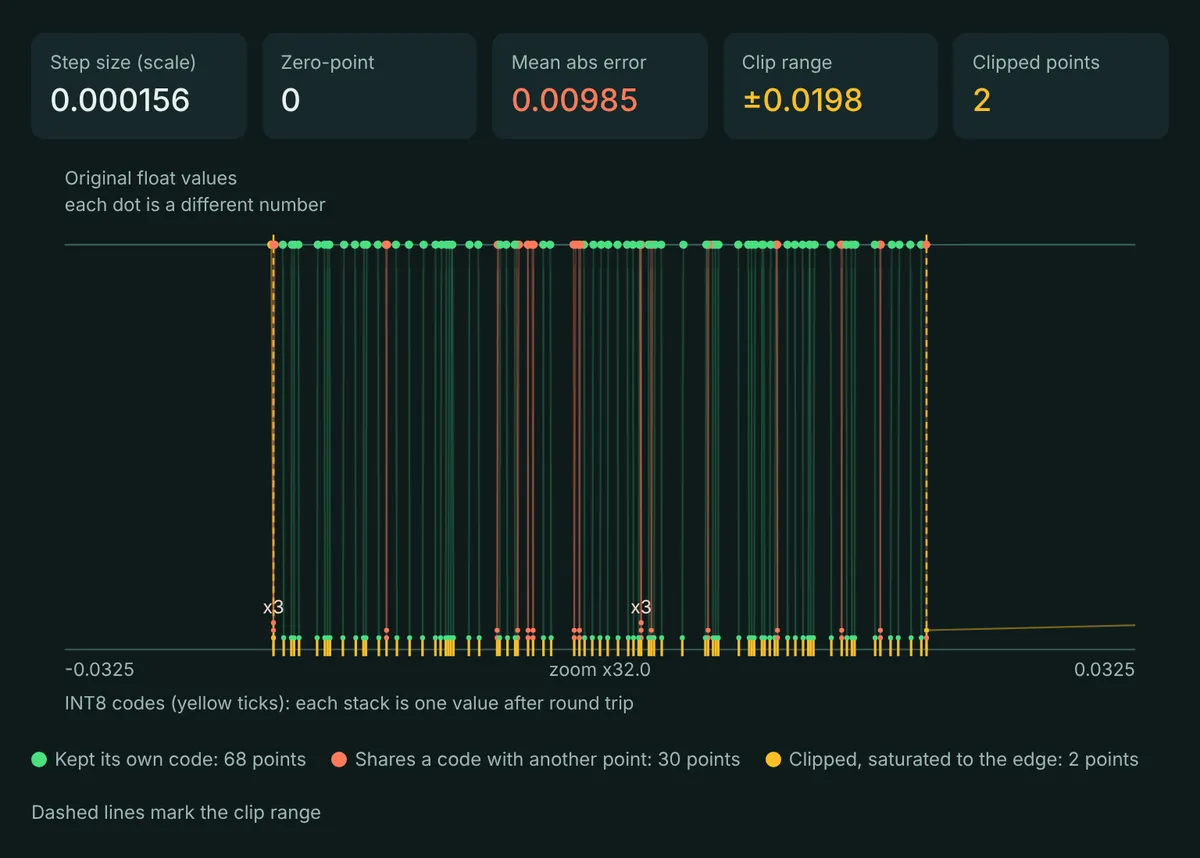
برای تعیین میزان برش، توسعهدهندگان از کالیبراسیون (Calibration) استفاده میکنند که شامل اجرای دادههای نمونه در مدل برای اندازهگیری محدودههایی است که کمترین خطا را ایجاد میکنند. در یک سناریوی برشخورده، اندازه گام ممکن است از ۰.۰۰۷۸۷ به ۰.۰۰۰۱۵۶ کاهش یابد و به اکثر وزنها اجازه دهد دوباره علامت مخصوص خود را داشته باشند، هرچند ممکن است میانگین خطا بالا برود چون خطای مقدار پرت (مثلاً ۱.۰ به ۰.۰۲) بر دستاوردهای دیگر غلبه کند.
۲. مقیاسبندی بلوکی (Block-wise Scaling): بهجای استفاده از یک خطکش برای کل تنسور، وزنها به گروههای کوچکتر (بلوکها) تقسیم میشوند. حالا یک مقدار پرت فقط خطکش گروه کوچک خودش را میکشد و «شعاع تخریب» را محدود میکند.
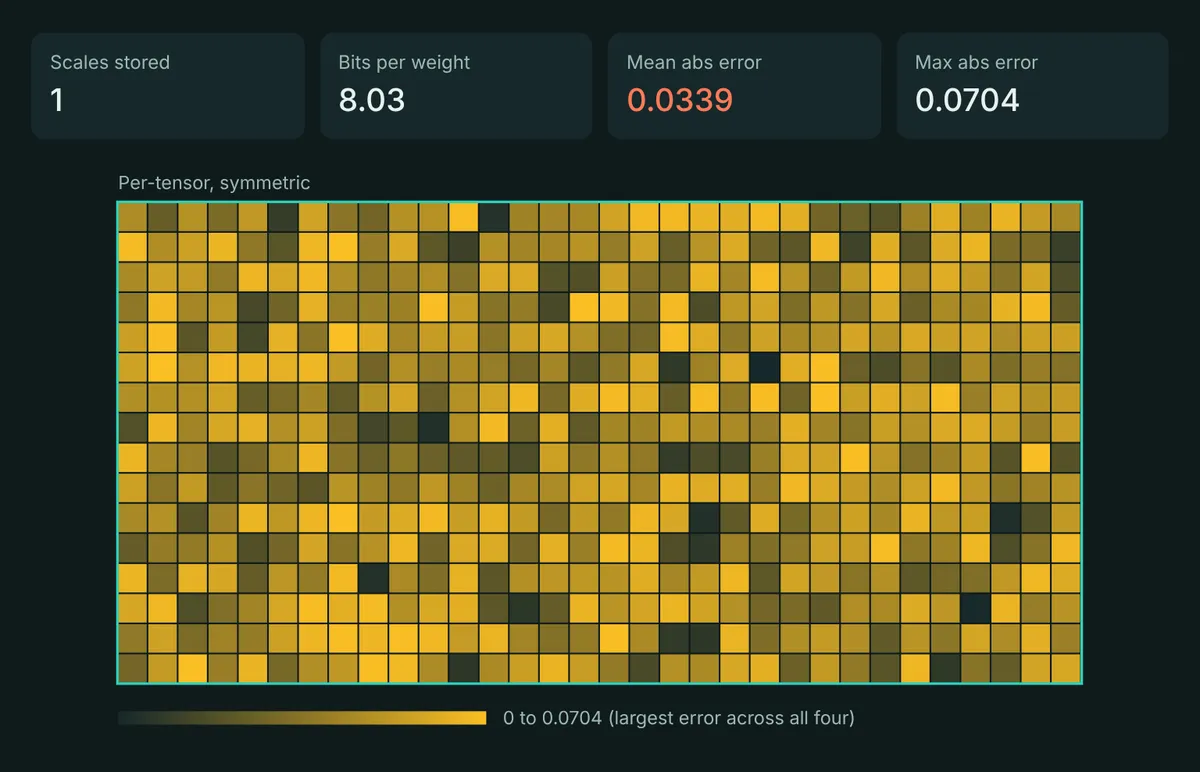
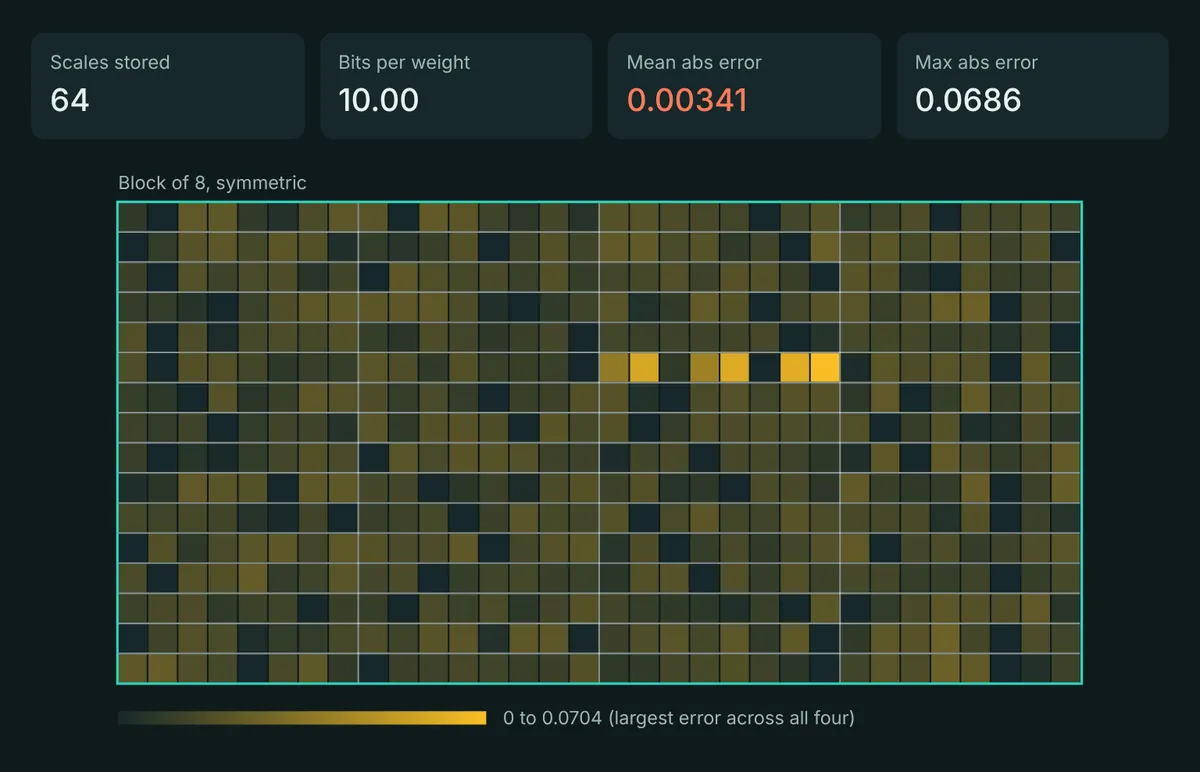
گروهبندی میتواند بهصورت سطری، ستونی یا بلوکی (وزنهای متوالی) باشد. استفاده از یک مقیاس واحد برای کل ماتریس (per-tensor) میتواند کل ماتریس را با خطا پر کند. اما تغییر به بلوکهای ۸ تایی میتواند میانگین خطا را از ۰.۰۳۳۹ به ۰.۰۰۳۴۱ کاهش دهد — یک بهبود ۱۰ برابری.
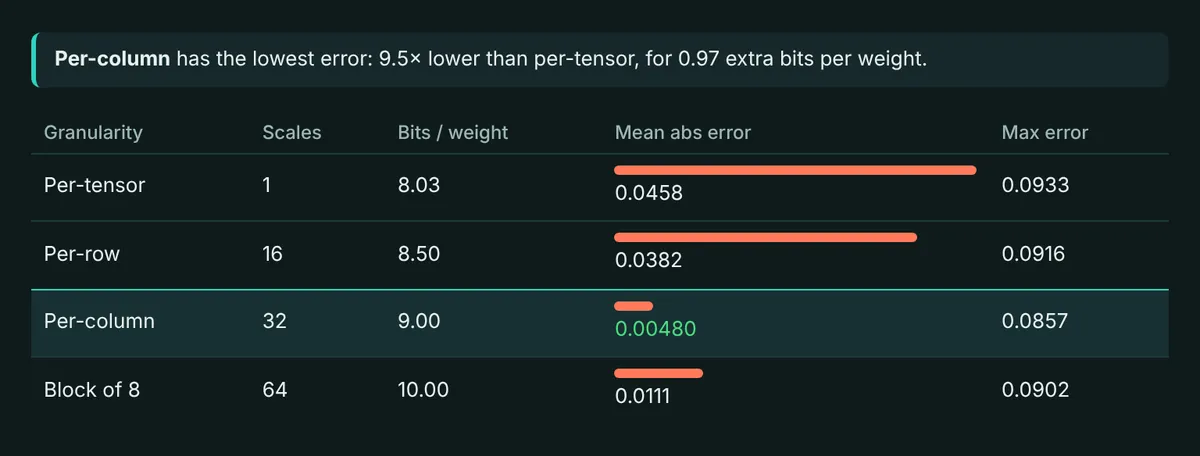
البته این روش هزینه ذخیرهسازی دارد. هر گروه به مقیاس مخصوص خود نیاز دارد. در بلوکهای ۶۴ تایی با مقیاس ۱۶ بیتی، تقریباً یکچهارم بیت به هر وزن اضافه میشود. انتخاب نوع گروهبندی به محل قرارگیری مقادیر پرت بستگی دارد: اگر مقادیر پرت در ستونها متمرکز باشند، مقیاسهای ستونی برنده هستند و اگر در سطرها باشند، مقیاسهای سطری. اگر یک ستون کامل از مقادیر پرت وجود داشته باشد، گروهبندی سطری بهسختی کمک میکند چون هر سطر حاوی یک مقدار پرت است.
جزئیات پیادهسازی
در عمل، پیادهسازی این مفاهیم در NumPy تنها به چند خط کد نیاز دارد. یک تابع کوانتش متقارن ساده، مقیاس را از تقسیم حداکثر مقدار مطلق وزنها بر ۱۲۷ محاسبه میکند. سپس وزنها بر این مقیاس تقسیم، گرد و بین ۱۲۷- و ۱۲۷ برش داده شده و به int8 تبدیل میشوند.
برای بازیابی مقادیر، تابع دکوانتش مقادیر int8 را به float32 تبدیل کرده و در مقیاس ذخیرهشده ضرب میکند. این فرآیند تایید میکند که اگرچه ۴ بایت به ۱ بایت کاهش یافته، اما سیستم همچنان باید مقیاس را ذخیره کند تا کار کند.
برای پیادهسازی بلوکی، وزنها به بلوکهایی (مثلاً ۶۴ تایی) تغییر شکل مییابند. مقیاس برای هر بلوک با استفاده از np.abs(w).max(axis=1) / 127 محاسبه میشود. برای جلوگیری از تقسیم بر صفر، مقیاسهایی که برابر صفر هستند به ۱.۰ تغییر مییابند.
کوانتش فقط-وزن در برابر W8A8
اکثر پیادهسازیهای فعلی از کوانتش فقط-وزن (Weight-only) استفاده میکنند. وزنها بهصورت INT8 ذخیره میشوند اما درست قبل از ضرب ماتریسی، به ممیز شناور ۱۶ بیتی باز میگردند. این کار حافظه و پهنای باند را بدون تغییر در ریاضیات پایه ذخیره میکند.
کوانتش تهاجمیتر یعنی W8A8، هم وزنها و هم فعالسازها (Activations - اعداد میانی که بین لایهها جریان دارند) را به INT8 تبدیل میکند. این به GPU اجازه میدهد از سختافزار سریع اعداد صحیح برای ضرب واقعی استفاده کند.
کوانتش فعالسازها به دو دلیل سختتر است:
- نیازمندیهای سختافزاری: سختافزار ریاضیات صحیح نیاز دارد هر دو ورودی عدد صحیح باشند.
- KV Cache: برخی فعالسازها برای گفتگوهای طولانی در KV Cache ذخیره میشوند و حافظه زیادی میگیرند. در این زمینه، مدیریت بهینه حافظه در KV-Cache برای جلوگیری از گلوگاههای حافظه در مدلهای بزرگ حیاتی است.
برخلاف وزنها که پس از آموزش ثابت هستند، فعالسازها با هر ورودی تغییر میکنند. پژوهشهای مقاله LLM.int8() نشان میدهد در مدلهای با بیش از ۶.۷ میلیارد پارامتر، چند بُعد از فعالسازها بهطور مداوم مقادیر عظیمی دارند که کوانتش ساده ۸ بیتی را میشکند.
مسیرهای آینده در فشردهسازی
چرخش به سمت کوانتش دانهریز و بلوکی، فرضیات حوزه فشردهسازی مدل را تغییر میدهد. این ثابت میکند که چالش اصلی، خودِ فرآیند گرد کردن نیست، بلکه مدیریت ناهنجاریهای آماری در توزیع وزنها است.
با حرکت به سمت دقتهای پایینتر از ۸ بیت، پیچیدگی افزایش مییابد:
- کوانتش ۴ بیتی: با تنها ۱۶ علامت روی خطکش، گرد کردن ساده دیگر کافی نیست و روشهای پیشرفتهای مثل GPTQ ضروری میشوند.
- BitNet: نقطه انتهایی این طیف، جایی که وزنها به تنها سه مقدار -۱، ۰ و ۱ محدود میشوند.
برای توسعهدهندگان، این بدان معناست که انتخاب روش کوانتش (مثل GPTQ یا GGUF) در واقع انتخاب راهی برای مدیریت این مقادیر پرت است.
برای مشاهده این مفاهیم در عمل، میتوانید از «زمین بازی کوانتش INT8» (INT8 Quantization Playground) استفاده کنید تا بصری کنید چگونه اندازه بلوکهای مختلف بر نرخ خطا در توزیعهای مختلف وزنی اثر میگذارد.



گفتگو