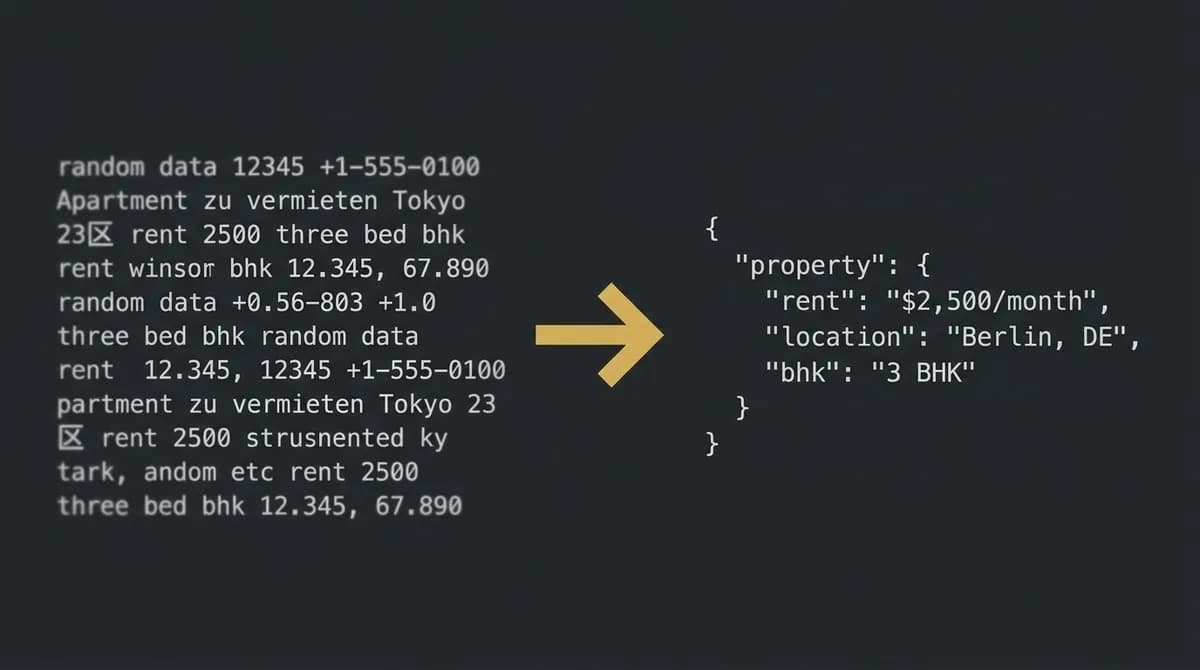
تصور کنید میخواهید در میان صدها پست نامنظم و پراکنده در گروههای فیسبوک، خانهای با بودجه و شرایط خاص پیدا کنید؛ کاری که معمولاً ساعتها اسکرول کردن و پیام دادن به ناشناسها میطلبد. یک توسعهدهنده با طراحی خط لولهای (Pipeline) هوشمند، این آشوب متنی را به یک پایگاهداده مرتب و فیلترشده تبدیل کرد تا جستوجوی مسکن در شهرهایی مثل حیدرآباد را متحول کند.
در بسیاری از شهرهای هند، گروههای «اجاره بدون دلال» مرکز اصلی دادهها هستند، اما اطلاعات قیمت و متراژ در قالبهای کاملاً متناقض نوشته میشوند. این پروژه پاسخی عملی به فرهنگ «برای جزئیات پیام دهید» است که باعث اتلاف وقت کاربران میشود. همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، مدیریت جریان دادههای نامنظم نیازمند یک استراتژی لایهبندی شده است تا از توهمات مدل جلوگیری شود.
طبق اعلام این توسعهدهنده در پست ۱۵ جولای ۲۰۲۶ در وبسایت dev.to، این سامانه برای احراز هویت و استخراج دادهها از ۱۶ گروه فیسبوکی به ابزار Playwright تکیه دارد. هسته اصلی این پروژه «پارسر آبشاری» نام دارد که دادهها را در سه لایهی مجزا پردازش میکند تا سرعت بالا و هزینه صفر تضمین شود:
- لایه اول (Regex): با استفاده از عبارات منظم (Regex)، ۸۵٪ از فیلدها مثل قیمت (مثلاً 15k) و شماره تلفنهای هندی را بهصورت آنی استخراج میکند.
- لایه دوم (مدل بهینهشده): یک مدل زبانی کوچک (SLM) — شبیه به دستیاری که تخصصش فقط خواندن فرمهای اداری است — از نوع Gemma 3 1B به کار رفته است. این مدل با استفاده از روش لورا (LoRA) روی ۲۰۰ مورد برچسبگذاری شده، تنظیم دقیق (Fine-tuning) — مثل وقتی که به یک پزشک عمومی تخصص پوست میدهیم تا روی یک حوزه خاص دقیق شود — شده تا موارد مبهم مثل وضعیت مبله بودن خانه را تشخیص دهد.
- لایه سوم (غنیسازی کلیدواژه): منطق پسپردازش، امکاناتی مثل ژیم یا برق اضطراری را شناسایی میکند.


این مدل روی یک مکبوک سری M با استفاده از کتابخانههای HuggingFace و PEFT در حدود ۲۰ دقیقه آموزش دیده است. به دلیل استفاده از MLX برای استنتاج (Inference) — یعنی همان لحظهای که مدل واقعاً جواب تولید میکند و شبیه به خودِ آشپزی است نه آموزش آن — هزینهی API کاملاً حذف شده است. دادههای نهایی در یک پایگاهداده Supabase ذخیره میشوند تا از تکرار پستها در رابط کاربری جلوگیری شود.


بر اساس گزارش سازنده، اپلیکیشن نهایی که روی Render مستقر شده، اجازه میدهد کاربران بر اساس بودجه و مکان فیلتر کنند. این سامانه ۵۵۷ مورد را از ۱۶ گروه پردازش کرده و میانگین زمان تحلیل هر پست را به کمتر از ۲۰۰ میلیثانیه رسانده است.
این پیادهسازی ثابت میکند که سپردن تمام دادهها به یک مدل زبانی غولپیکر، الگویی ناکارآمد برای استخراج دادههای ساختاریافته است. با استفاده از مدل زبانی فقط به عنوان «پشتیبان» برای موارد مبهم، سیستمی بهدست آمده که هم دقیق است و هم روی یک لپتاپ معمولی اجرا میشود. این رویکرد، پارادایم را از «اتکای کامل به هوش مصنوعی» به «دقت به کمک هوش مصنوعی» تغییر میدهد.
گام بعدی شما
- بررسی مخزن
fb-flat-finderدر گیتهاب برای مطالعه کد منبع. - تست مدل Gemma 3 1B روی دادههای مشابه با استفاده از MLX برای کاهش هزینهها.
- پیادهسازی لایهی Regex برای فیلتر کردن دادههای بدیهی پیش از ارسال به مدل.
اما چالش واقعی، مدیریت توکنها در حجمهای بسیار زیاد است — در تحلیل ما دربارهی تکنیکهای کوانتش وزنها، راهکارهای بهینهسازی حافظه را بررسی کردهایم.



گفتگو