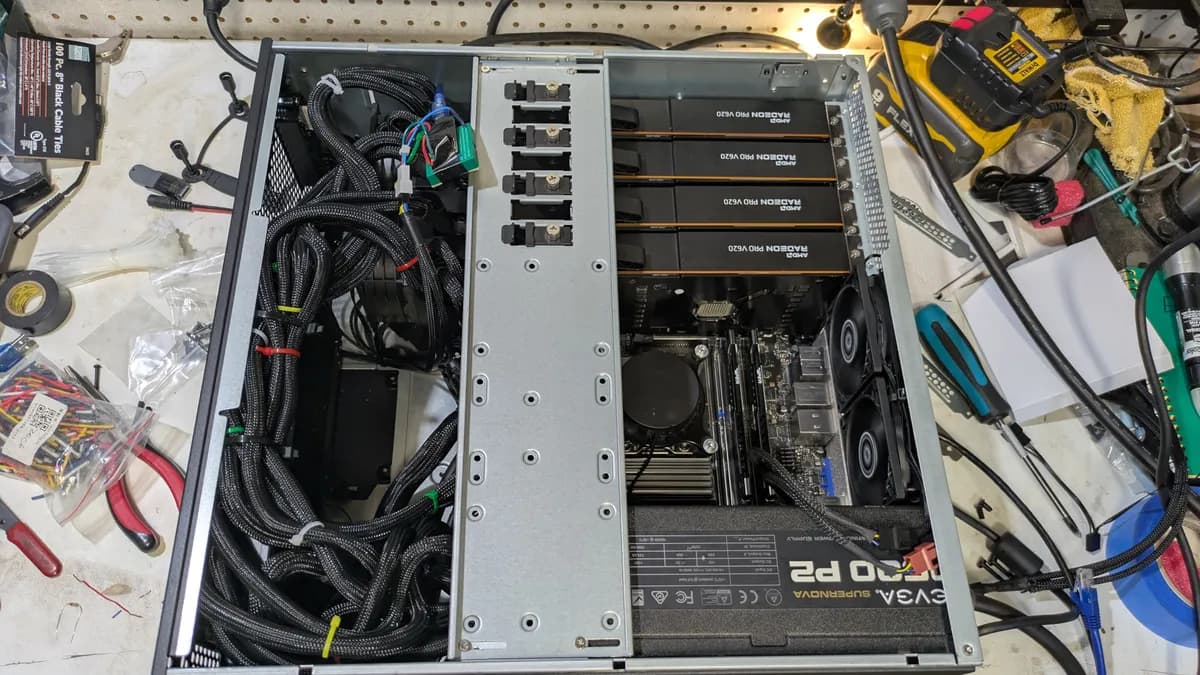
تصور کنید به جای پرداخت هزینههای ماهانه به شرکتهای ابری، یک مرکز دادهٔ کوچک و قدرتمند در گاراژ خانهتان داشته باشید که کاملاً تحت کنترل شماست. این رویایی است که یک توسعهدهنده نرمافزار در ۱۳ اوت ۲۰۲۶ با تبدیل ضایعات الکترونیک به یک ماشین استنتاج محلی به واقعیت تبدیل کرد. او با جزئیات شرح داد که چگونه با ساخت یک ماشین فیزیکی که کنترل کامل آن در دست خودش باشد، وابستگی به عوامل کدنویسی مبتنی بر ابر را دور زد.
برای بسیاری از برنامهنویسان، گذار به مدلهای زبانی بزرگ مبتنی بر ترنسفورمر (Transformer-based LLMs) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — شبیه جابهجایی از ابزارهای دستی به ابزارهای برقی است. اما تکیه بر APIهای شخص ثالث، وابستگی خطرناکی ایجاد میکند؛ چرا که یک سرویس میتواند در هر لحظه تغییر کند یا دسترسی شما به آن لغو شود. این رویکرد در واقع بخشی از یک تغییر گستردهتر در نقش توسعهدهندگان است که مسیر تبدیل برنامهنویسان نرمافزار به مهندسان هوش مصنوعی را هموار میکند. نویسنده اشاره میکند که او تنها میتواند به فناوریهایی اعتماد کند که قادر است آنها را در گاراژ خود باز کرده و دوباره سرهم کند. این پروژه پاسخی است به میل برای دستیابی به «حاکمیت محاسباتی» (Compute Sovereignty) از طریق بازیافت سختافزارهای دورریختهشده برای میزبانی محلی مدلها، تا دیگر نیازی به اتصال به مراکز داده عظیم هوش مصنوعی نباشد.
بازیافت سختافزار
به نقل از مستندات این پروژه، هسته اصلی این سیستم خوشهای از پردازندههای گرافیکی AMD V620 است. این کارتها در اصل کارتهای ورکاستیشن بودند که برای موج شکستخوردهی «گیمینگ ابری» در سال ۲۰۲۲ ساخته شده بودند؛ جایی که شرکتها تلاش میکردند بازیها را در مراکز داده اجرا کنند تا نیاز به کنسولهای خانگی گرانقیمت از بین برود. AMD برای ساخت V620، یک GPU ورکاستیشن را برداشته، مقدار رم آن را افزایش داد و تمام خروجیهای تصویر را حذف کرد.
از آنجایی که AMD این کارتها را بیش از حد تولید کرده بود و صنعت گیمینگ ابری به دلیل مشکلات تأخیر (Lag) فروپاشید، این قطعات اکنون از طریق فروشندگان ضایعات الکترونیک در eBay به قیمت ارزان یافت میشوند. اگرچه پشتیبانی نرمافزاری AMD به شدت بدنام است و این کارتها به طور خاص برای هوش مصنوعی طراحی نشدهاند، اما هر یک از آنها ۳۲ گیگابایت VRAM سریع ارائه میدهند که آنها را برای محاسبات ماتریسی موازی با بودجهای کم، ایدهآل میکند. نویسنده خاطرنشان کرد که کارتهایی که او تهیه کرده، علیرغم اینکه از فروشندگان ضایعات خریداری شده بودند، اساساً نو به نظر میرسیدند.

برای اتصال این GPUها به یکدیگر، سازنده از یک مادربرد پلتفرم X299 متعلق به سال ۲۰۱۷ استفاده کرد. این برد خاص به این دلیل انتخاب شد که چهار اسلات PCIe x16 را با فاصله لازم برای قرارگیری چهار GPU در کنار یکدیگر فراهم میکند. سیستم توسط پردازنده Intel Core i9 10900X تغذیه میشود، پردازندهای که در سال ۲۰۱۹ عرضه شد. نویسنده آن را بدترین CPU تولید شده توسط اینتل در ۲۰ سال اخیر توصیف میکند؛ نسخهای بازسازیشده از تراشههای Skylake که گرانقیمت و پرمصرف بود، زیرا اینتل در آن زمان برای رقابت با تراشههای Ryzen شرکت AMD از نظر اندازه گره لیتوگرافی و طراحی دچار مشکل بود. با این حال، همین ناکارآمدی باعث شد که قیمت آن در بازار دستدوم بسیار ارزان شود.
سایر قطعات نیز از اطراف خانه بازیافت شدند:
- رم و SSD: از کامپیوترهای قدیمی استخراج شدهاند. نویسنده این کار را «تقلب» مینامد، اما چون مدل ابتدا از دیسک بارگذاری شده و سپس در VRAM گرافیکی مستقر میشود، این قطعات بیشتر زمانها بیکار میمانند. او اشاره میکند که حتی اگر قطعات بازیافتی در دسترس نبود، باز هم میتوان در این بخش «بسیار ارزان» عمل کرد زیرا الزامات سختافزاری کمتر از حد انتظار است.
- منبع تغذیه: یک واحد ۱۶۰۰ وات استفاده شد. جالب اینجاست که این مدل در eBay ارزانتر از مدل ۱۲۰۰ وات بود. ظرفیت بالا برای مدیریت جهش شدید برق در لحظه استارتآپ، زمانی که چهار GPU و یک CPU ناکارآمد اینتل همزمان روشن میشوند، ضروری است.
حل بحران خنککنندگی
به دلیل اینکه کارتهای AMD V620 در سطح سرور هستند، فاقد فنهای داخلی بوده و به جریان هوای فشار بالا از دیوارهای از فنهای سرور تکیه میکنند. برای جلوگیری از گرم شدن بیش از حد، سازنده از نرمافزار OnShape برای مدلسازی و چاپ سهبعدی پوششهای فن (Fan Shrouds) سفارشی استفاده کرد.

سازنده مدلهای سهبعدی موجود را رد کرد زیرا یا از فنهای ۴۰ میلیمتری کوچک و پرصدا استفاده میکردند یا بیش از حد بیرون زده بودند و اجازه قرارگیری کارتها در کنار هم را نمیدادند. از آنجایی که چهار کارت دو-اسلاتی عرضی حدود ۱۶۰ میلیمتر را اشغال میکنند، نویسنده پوششی طراحی کرد تا دو فن ۸۰ میلیمتری سرور را مستقیماً به هیتسینکهای کارتها متصل کند.
- متریال: پوششها از جنس ASA فیبر کربن چاپ شدند، هرچند نویسنده اعتراف میکند که PLA معمولی هم کفایت میکرد.
- اتصال: این پوششها از سوراخهای پیچ موجود در بالههای راهنمای کابل فلزی در پشت کارتها استفاده میکنند. طراحی شامل یک برش برای کانکتورهای الکتریکی و چهار سوراخ برای نصب فنها در پشت است.
- مشخصات: فنها با سرعت ۱۰,۰۰۰ دور در دقیقه میچرخند تا جریان هوای کافی تضمین شود. این فنها انتخاب شدند چون قیمتی برابر با فنهای کندتر داشتند.
اگرچه این روش مؤثر است، اما صدای فنها چنان بلند است که از پشت دیوارهای خانه شنیده میشود و استفاده از محافظ گوش در طول مراحل اولیه راهاندازی ضروری بود.

موانع نرمافزاری و BIOS
برای اینکه سختافزار بوت شود، نیاز به بررسیهای عمیق در BIOS بود. سازنده یک ساعت کامل را در گاراژ در حالی که محافظ گوش به گوش داشت سپری کرد تا تنظیمات را برای شناسایی آرایه توسط مادربرد تغییر دهد. به طور خاص، او مجبور شد Resizable BAR و MMIO High Size را در منوهای مجزایی در اعماق گزینههای پیشرفته فعال کند. این تنظیمات ضروری هستند زیرا بردهای سال ۲۰۱۷ برای مدیریت این حجم از VRAM طراحی نشده بودند.
در این مرحله، سازنده متوجه شد که در گاراژ دسترسی به اترنت ندارد، که منجر به یک جلسه دیرهنگام در ساعت ۱۱ شب شد تا با بریدن سوراخهایی در دیوار گچی، اتصال شبکه را برقرار کند.

پس از بوت شدن سیستم در Ubuntu 24.04، سازنده ابزار llama.cpp را برای تست دو مدل خاص کامپایل کرد:
- Gemma 4: این مدل به راحتی روی یک کارت جا شد. عملکرد خوبی داشت، هرچند سرعتش به اندازه RTX 3090 که نویسنده قبلاً داشت نبود.
- DeepSeek V4 Flash: هدف اصلی این ساخت بود. در حالی که مدل در VRAM جای گرفت، سرعت استنتاج اولیه کند بود که زمینه را برای بهینهسازیهای آینده فراهم کرد.
کنترلکننده فن طراحی شده توسط هوش مصنوعی
از آنجایی که مادربرد Supermicro اجازه نمیداد فنهای مختلف با سرعتهای متفاوت کنترل شوند، سازنده یک کنترلکننده PWM سفارشی ساخت. این دستگاه با استفاده از کلونهای Arduino Nano که در «روزهای پیش از تعرفهها» از Aliexpress خریداری شده بود، ساخته شد. نویسنده از کدهای موتور PWM که بیش از یک دهه پیش برای کلاس میکروکنترلرهای کالج نوشته بود، استفاده کرد.
در یک چرخش بازگشتی جالب، سازنده از DeepSeek V4 Flash خواست تا اسکریپت پایتونی را بنویسد که دمای GPU را بخواند و سرعت فن را تنظیم کند. این کار نیاز به مقدار متوسطی راهنمایی انسانی داشت تا بتوان از این مدل سبک، نرمافزاری قابل قبول استخراج کرد. این تجربه نشان میدهد که در لایههای عملیاتی هوش مصنوعی، اولویت منطق بر کدنویسی است و مدلهای زبانی بیشتر به عنوان دستیاران منطقی عمل میکنند تا کدنویسان مستقل.

در طول این فرآیند، هوش مصنوعی دچار یک «بحران وجودی» کوتاه شد. وقتی از او خواسته شد راهی برای گرم کردن GPUها پیدا کند تا اسکریپت تست شود، AI شروع به نوشتن یک اسکریپت PyTorch برای ضرب ماتریسی کرد. نویسنده مجبور شد به او یادآوری کند: «نه، تو همین حالا روی این کارتها اجرا میشوی، تو در یک نمونه llama.cpp روی این کامپیوتر وجود داری، فقط با گفتن هر چیزی، کارتها درگیر میشوند».
کنترلکننده نهایی روی یک برد بورد (Breadboard) قرار گرفته که داخل کیس سرور چپانده شده و با چسب برق محکم شده تا از اتصال کوتاه با شاسی جلوگیری شود. نویسنده اشاره میکند که «احتمالاً مشکلی پیش نخواهد آمد».
این ساخت ثابت میکند که مانع ورود به دنیای هوش مصنوعی محلی، لزوماً قیمت H100های جدید نیست، بلکه تمایل به مهندسی پیرامون محدودیتهای سختافزارهای دورریختهشده است. با ترکیب چاپ سهبعدی، قطعات قدیمی سرور و مدلهای وزن-باز، ایجاد یک مرکز داده خصوصی کاربردی در یک گاراژ مسکونی ممکن است.
برای کسانی که به دنبال تکرار این تجربه هستند، چالش بعدی بهینهسازی سرعت استنتاج کند در خوشه V620 است که نیازمند تنظیمات نرمافزاری عمیقتری خواهد بود.



گفتگو