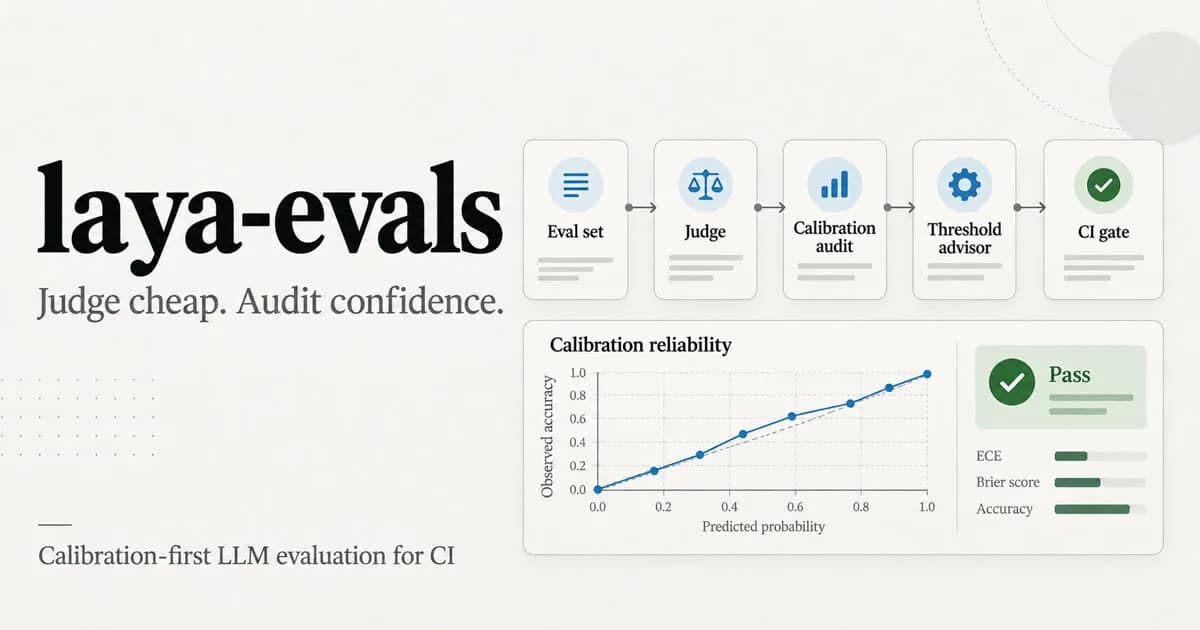
اگر برای هر ۱۰۰۰ مورد داوری در ارزیابی مدلهای خود هزینه پرداخت میکنید، باید بدانید که این هزینه اکنون میتواند به صفر برسد. ابزار متنباز laya-evals که در ۱ اکتبر ۲۰۲۶ منتشر شد، داوران گرانقیمت مبتنی بر API مثل GPT-4 را با یک مدل تصمیمگیر محلی جایگزین میکند که روی یک CPU معمولی اجرا میشود.
بسیاری از توسعهدهندگان با این شکاف مواجهاند که مدل در محیط دمو موفق است اما در تولید شکست میخورد؛ دلیلش این است که صحت مدل را بدون بررسی سطح اعتماد آن اندازهگیری کردهاند. همانطور که در تحلیل قبلی ما دربارهی تمایل مدلهای پیشرو به رها کردن پاسخهای درست تحت فشار اشاره کردیم، laya-evals با اندازهگیری قابلاعتماد بودن اعتماد مدل، این مشکل را حل میکند. این رویکرد در حالی اهمیت مییابد که حتی مدلهای بهینهشده نیز در برابر دادههای گمراهکننده آسیبپذیرند، مشابه آنچه در افت دقت مدل Claude Haiku 4.5 در مواجهه با ابزارهای مسموم مشاهده شد. مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در این ابزار دیگر نیازی به اتصال به ابر ندارد.
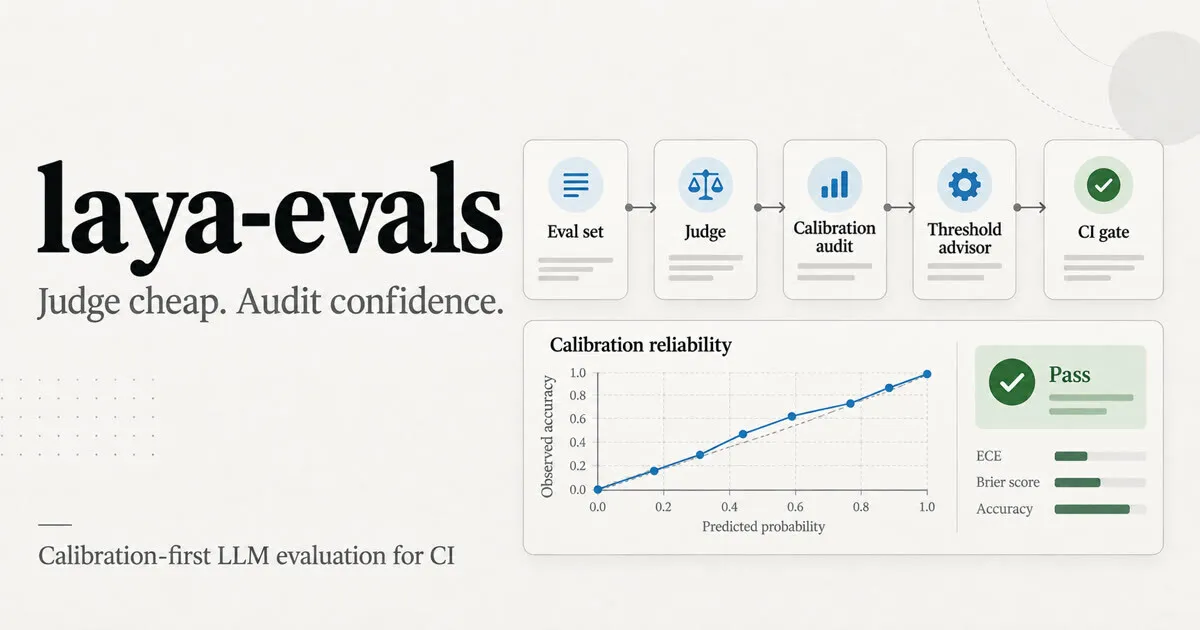
طبق مستندات این پروژه، این ابزار یک خط لوله سهمرحلهای برای ایمنسازی درگاه تولید پیاده میکند:
- داوری مبتنی بر دستورالعمل (Rubric-based Judging): استفاده از مدل تصمیمگیر محلی laya برای امتیازدهی به مجموعههای ارزیابی با سرعت ۶.۴ تصمیم در ثانیه روی CPU. این اتوماسیون در کنار ارزیابیهای انسانی که همچنان معیار طلایی همراستاسازی محسوب میشوند، دقت فرآیند توسعه را دوچندان میکند.
- ممیزی کالیبراسیون (Calibration Audits): محاسبه خطای کالیبراسیون مورد انتظار (ECE) و امتیاز Brier برای تعیین آستانههای اعتماد دقیق برای انواع مختلف پرسشها.
- درگاه رگرسیون CI: یکپارچگی با GitHub Actions برای متوقف کردن خودکار بیلدها در صورت افت صحت یا کالیبراسیون.
به نقل از گزارش dev.to، در بنچمارکی با ۸۷۲ جمله SST-2، داور محلی به صحت ۰.۸۹۶۸ و ضریب کاپای کوهن ۰.۷۹۳۸ دست یافت. در مقایسه با مدل GLM-5.3-flash شرکت Z.ai، این داور محلی ۹۰.۷٪ توافق نشان داد؛ این یعنی مدلهای محلی میتوانند با کسری از هزینه، تقریباً به اندازه مراجع ابری قابلاعتماد باشند. در این راستا، مدلهای اقتصادی دیگر نیز در حال بهینهسازی هستند، همانطور که Gemini 3.7 Flash به عنوان برترین مدل اقتصادی برای تحلیل داده معرفی شد.
این تغییر، رویه ارزیابی را دگرگون میکند و «داور» را از یک API خارجی گرانقیمت به یک پیشنیاز محلی در فرآیند بیلد تبدیل میکند. با تبدیل کالیبراسیون به یک گیت سختگیرانه در CI، توسعهدهندگان دیگر مدلهایی را که «با اعتماد کامل اشتباه میکنند» مستقر نخواهند کرد.
این ابزار، آخرین محصول از سری پنجگانه ابزارهای موتور تصمیم laya است که معماری آن با Decisions API شرکت OpenAI در Luna مشترک است. اکنون میتوانید این بسته را از طریق pip نصب کنید تا ممیزی آستانههای مدل خود را آغاز کنید.
گام بعدی شما
- نصب بسته laya-evals از طریق pip برای جایگزینی داوران ابری با مدل محلی.
- اجرای ممیزی ECE روی دادههای تست برای شناسایی نقاط ضعف در اعتماد مدل.
- تعریف یک گیت در GitHub Actions برای جلوگیری از استقرار مدلهای دارای رگرسیون در کالیبراسیون.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو