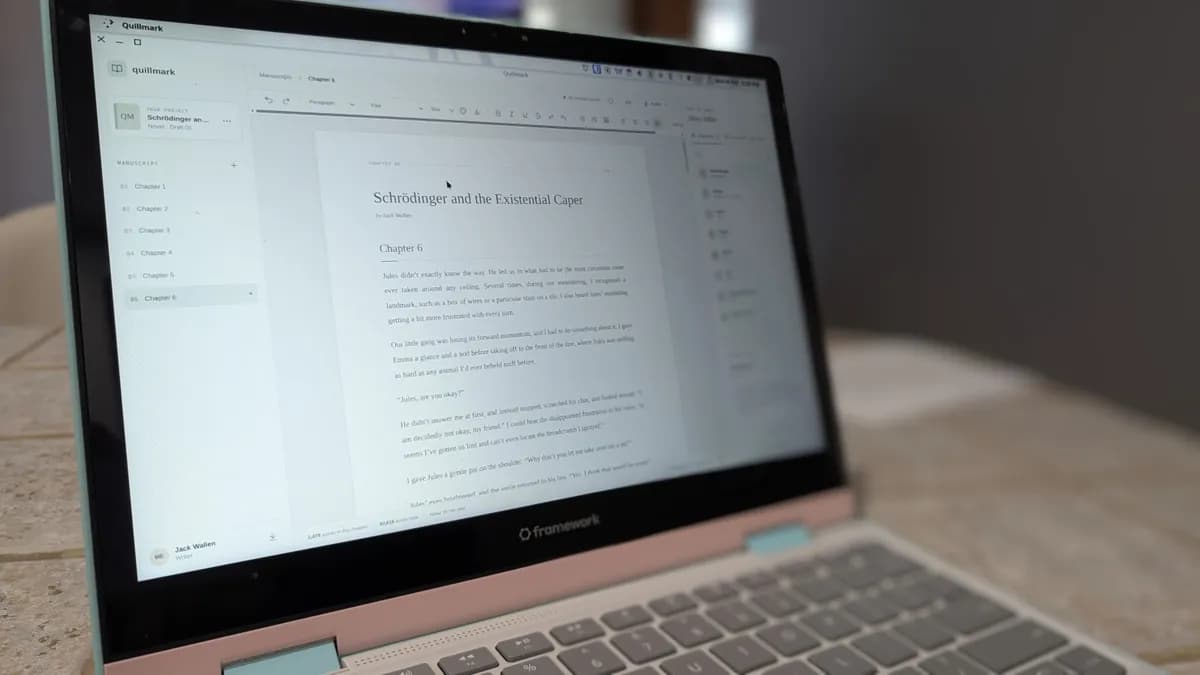
تصور کنید نویسندهای باشید که هیچ تسلط عمیقی به کدنویسی ندارد، اما در عرض دو ساعت ابزاری میسازد که دقیقاً مطابق میل اوست. این اتفاق برای خالق اپلیکیشن Quillmarker رخ داد؛ او بدون نوشتن بخش اعظم کدها و تنها با تکیه بر یک استک هوش مصنوعی محلی، نرمافزاری برای پیشنویس رمانهایش طراحی کرد. او با بهرهگیری از این فناوری، اشتراکهای گرانقیمت و واژهپردازندگان حجیم و پیچیده را دور زد تا ابزاری بسازد که دقیقاً با نیازهای او در مرحله پیشنویس مطابقت داشته باشد.
بسیاری از نویسندگان امروز میان نرمافزارهای بیش از حد پیچیدهای مثل Scrivener یا واژهپردازندگان سنتی که بر پایه اشتراکهای ماهانه هستند، گیر کردهاند. این پروژه در زمانی رخ میدهد که مفهوم Vibe Coding (وایب کدینگ) — یعنی استفاده از هوش مصنوعی برای توصیف و تولید نرمافزار — از دستان مهندسان حرفهای به کاربرانی میرسد که «مجاور توسعهدهنده» (developer-adjacent) هستند؛ یعنی کسانی که شاید کمی HTML یا پایتون بدانند اما توانایی ساخت یک اپلیکیشن کامل را از صفر ندارند.
به گزارش ZDNET در تاریخ ۶ اکتبر ۲۰۲۶، این نویسنده با نصب Ollama روی یک سرور محلی، هزینههای اشتراک و نگرانیهای حریم خصوصی را به کلی حذف کرد. او بهجای استفاده از چتباتهای ابری، تمام فرآیند را روی سختافزار شخصی خود اجرا کرد تا اطمینان حاصل کند که هیچ دادهای از محیط محلی او خارج نمیشود. این رویکرد در تضاد با استراتژیهای جدید شرکتهای بزرگ است؛ برای مثال، OpenAI اخیراً قابلیتهایی را معرفی کرده که نیاز به زیرساختهای خارجی برای میزبانی اپلیکیشنهای AI را حذف میکند تا کاربران را بیشتر در اکوسیستم ابری خود نگه دارد.
همانطور که در تحلیلهای قبلی ما دربارهی میزبانی شخصی (Self-hosting) مدلهای بازمتن اشاره کردیم، حذف واسطههای ابری نه تنها امنیت دادهها را بالا میبرد، بلکه هزینههای استنتاج را به صفر میرساند.
زمینه: نیاز به یک ابزار سفارشی
این نویسنده متوجه شد ابزارهای موجود یا بیش از حد سنگین هستند یا بیش از حد گراناند و یا ویژگیهای خاص مورد نیاز او را ندارند. او اشاره کرد که برای نوشتن پیشنویس اول یک رمان، نویسنده تنها به چند قابلیت کلیدی و هستهای نیاز دارد: بررسی املایی و دستوری، یک داشبورد مدیریتی، ابزارهای قالببندی، توابع خروجی و ورودی (Export/Import) و در نهایت حالتهای روشن و تاریک (Light/Dark modes).
او از مدل Hugh Howey الگو گرفت؛ نویسندهای که حدود ده سال پیش شروع به توسعه اپلیکیشن نویسندگی خود به نام NEO کرد. هاوی که پیش از این توسعهدهنده نرمافزار بود، احساس میکرد اکثر واژهپردازندهها برای نیازهای واقعی یک نویسنده بیش از حد شلوغ و حجیم (Bloated) هستند. نویسنده ما با اینکه NEO را میپسندید، اما میخواست چیزی بسازد که حتی بیشتر از آن با جریان کاری (Workflow) شخصیاش سازگار باشد.
او با وجود اینکه «مجاور توسعهدهنده» بود و دانش محدودی از پایتون، CSS، HTML و مقدار کمی جاوااسکریپت داشت، میدانست که این مهارتها به تنهایی برای ساخت یک اپلیکیشن کامل کافی نیستند. این شکاف مهارتی بود که او را سوق داد تا به هوش مصنوعی نصبشده بهصورت محلی روی آورد تا فاصله بین چشمانداز ذهنیاش و توانایی فنیاش را پر کند.
انگیزه برای استفاده از هوش مصنوعی محلی
تصمیم برای محلیسازی (Local AI) هم از انگیزههای مالی و هم از نگرانیهای حریم خصوصی نشأت میگرفت. او به عنوان یک نویسنده اشاره کرد که نویسندگان «دقیقاً به این معروف نیستند که در پول غوطهور باشند»، به همین دلیل ماهیت رایگان ابزارهای متنباز برای او بسیار جذاب بود. با استفاده از Ollama، او توانست از هزینههای تکرارشوندهای که با خدمات هوش مصنوعی تجاری و انحصاری همراه است، اجتناب کند.
علاوه بر این، نویسنده پیش از این ChatGPT را به نفع یک هوش مصنوعی رایگان، خصوصی و محلی رها کرده بود. این تغییر رویکرد تضمین میکرد که فرآیند نویسندگی او و کدهای مربوط به اپلیکیشنش کاملاً تحت کنترل خودش باقی بماند و از دسترسی ابری به دادهها و جمعآوری اطلاعات توسط شرکتهای بزرگ در امان باشد.
زیرساخت سختافزاری
ساخت یک اپلیکیشن مبتنی بر هوش مصنوعی محلی نیازمند قدرت پردازشی قابل توجهی است. نویسنده خاطرنشان میکند که یک لپتاپ استاندارد ممکن است برای این کار کافی نباشد و حداقل مشخصات زیر را توصیه میکند:
- رم (RAM): ۳۲ گیگابایت (او شخصاً از ۶۴ گیگابایت روی دستگاه خود استفاده کرد)
- واحد پردازش گرافیکی (GPU): ترجیحاً انویدیا (Nvidia) برای شتابدهی به پردازشها
- پردازنده (CPU): حداقل یک پردازنده ۶۴ بیتی با پشتیبانی از مجموعه دستورات AVX2
استک مدلهای هوش مصنوعی
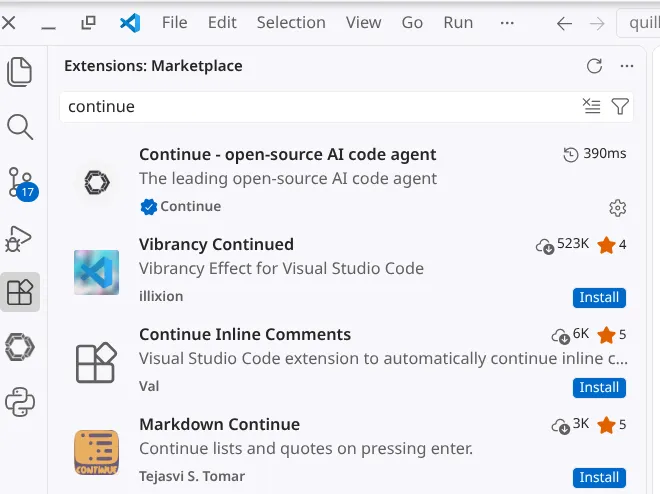
او برای مدیریت بخشهای مختلف فرآیند توسعه، مدلهای تخصصی متنوعی را از طریق Ollama مستقر کرد. این مدلها با دستورات خاصی مانند ollama pull llama3.1:8B ، ollama pull qwen2.5-coder:1.5b و ollama pull gemma4 فراخوانی شدند:
- چت، ویرایش و اعمال (Chat, Edit, Apply): مدل Llama 3.1 8B
- تکمیل خودکار (Autocomplete): مدل Qwen2.5-Coder (بهطور خاص مدل پایه 1.5B)
- بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه همسایهی چه کلمات دیگری است — مدل Transformer.js (با استفاده از مدل nomic-embed-text:latest)
- عامل (Agent): مدل gemma4:latest
نصب و پیکربندی شبکه
نصب Ollama بسته به سیستمعامل متفاوت است. برای لینوکس یا مک، این کار با یک دستور ساده انجام میشود: curl -fsSL https://ollama.com/install.sh | sh. کاربران ویندوز از دستور irm https://ollama.com/install.ps1 | iex استفاده میکنند.
از آنجا که نویسنده Ollama را روی یک سرور در شبکه داخلی (LAN) نصب کرده بود و نه روی همان ماشینی که IDE (محیط توسعه) روی آن اجرا میشد، مجبور شد آن را برای پذیرش اتصالات خارجی پیکربندی کند. بهطور پیشفرض، Ollama فقط درخواستهای ماشین محلی را میپذیرد. برای رفع این مشکل در لینوکس، او مراحل زیر را طی کرد:
۱. باز کردن فایل پیکربندی: sudo nano /etc/systemd/system/ollama.service
۲. اضافه کردن عبارت Environment="OLLAMA_HOST=0.0.0.0" در بخش [service].
۳. بارگذاری مجدد دیمون: sudo systemctl daemon-reload
۴. راهاندازی مجدد سرویس: sudo systemctl restart ollama
تنظیمات IDE: VS Code
برای محیط توسعه، او از VS Code استفاده کرد. در لینوکس، این نرمافزار از طریق خط فرمان و با دانلود فایل .deb برای توزیعهای مبتنی بر اوبونتو یا فایل .rpm برای توزیعهای مبتنی بر فدورا نصب میشود. نصب نهایی با دستورات sudo dpkg -i code*.deb یا sudo rpm -i code*.rpm انجام میگیرد. کاربران مک و ویندوز میتوانند از جادوگر نصب استاندارد استفاده کنند.
یکپارچهسازی و پیکربندی
هسته اصلی توسعه در VS Code و با استفاده از افزونه Continue اتفاق افتاد تا پل ارتباطی بین IDE و سرور محلی Ollama برقرار شود. پس از نصب افزونه از طریق آیکون Extensions در VS Code، نویسنده باید فایل config.yaml را پیکربندی میکرد.
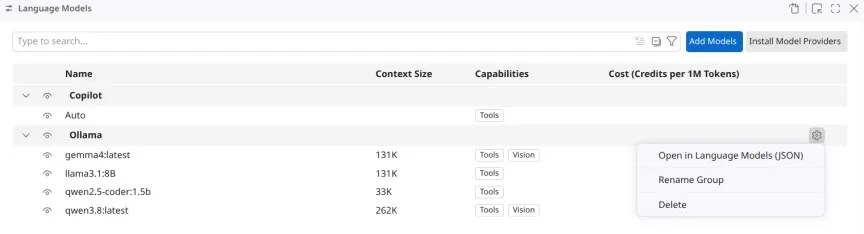
این کار مستلزم تغییر apiBase از مقدار پیشفرض http://127.0.0.1:11434 به آیپی واقعی سرور Ollama (مثلاً http://192.168.1.186:11434) بود. این تغییر باید در سه بلوک مختلف از فایل پیکربندی اعمال میشد:
- مدل اصلی: Llama 3.1 8B (که نقشهای چت، ویرایش و اعمال به آن واگذار شد)
- مدل تکمیل خودکار: Qwen2.5-Coder 1.5B
- مدل بردار (Embed): Nomic Embed (مدل nomic-embed-text:latest)
برای نهایی کردن تنظیمات، نویسنده «عامل» (Agent) را سفارشی کرد. او از طریق منوی کشویی Agent و آیکون چرخدنده به فایل chat.languageModels.json دسترسی پیدا کرد و مطمئن شد که خط URL با آیپی سرور Ollama مطابقت دارد. پس از انتخاب gemma4 از منوی کشویی، محیط برای ساخت اپلیکیشن آماده بود.
فرآیند ساخت تکرارشونده (Iterative Build)
پس از پیکربندی عامل با gemma4، نویسنده از یک روش پرامپتنویسی توصیفی در پنجره «توصیف آنچه باید ساخته شود» (Describe what to build) استفاده کرد. او تأکید کرد که تا حد امکان دقیق باشد تا از تکرارهای غیرضروری جلوگیری کند. برای مثال، هنگام درخواست قابلیتهای قالببندی، او بهطور مشخص خواست که «گزینههای قالببندی مشابه LibreOffice باشد».
ساخت نسخه اولیه حدود ۲ ساعت زمان برد. در این مدت، نویسنده مجبور بود به VS Code اجازه اجرای برخی دستورات خاص را بدهد. اگرچه فرآیند تا حد زیادی خودکار است، اما کاربر باید گهگاه این مجوزها را تأیید کند تا ساخت ادامه یابد. VS Code پیش از ادامه کار، منتظر تأیید کاربر برای این درخواستها میماند.
با این حال، نسخه اول، نسخه نهایی نبود. نویسنده حدود ۷ بار فرآیند را تکرار کرد تا ابزار را صیقل دهد، ویژگیهای فراموششده را اضافه کند و تجربه کاربری (UX) را بهبود ببخشد. او خاطرنشان کرد که اگر در توصیفات اولیه دقیق نباشید، ناگزیر خواهید بود برای افزودن ویژگیهای جا مانده، مراحل تکرار را طی کنید. در این مسیر، توجه به پایداری کد حیاتی است، چرا که برخی خطاهای فنی رایج میتوانند اپلیکیشنهای ساختهشده با هوش مصنوعی را در محیط عملیاتی با شکست مواجه کنند.
تحویل نهایی و نتایج
نتیجه نهایی یک فایل AppImage برای لینوکس بود؛ فرمتی که بهطور خاص درخواست شده بود تا اپلیکیشن بتواند روی هر توزیع لینوکسی اجرا شود. فایل اجرایی نهایی در پوشه ~/quillmarker/releases ذخیره شد.
نویسنده اکنون از Quillmarker برای رمان بعدیاش استفاده میکند و این تجربه را «لذتبخش» مینامد. این پروژه ثابت میکند که سد ایجاد «میکرو-اپها» (Micro-apps) — ابزارهایی که برای جریان کاری خاص یک فرد طراحی شدهاند — عملاً از بین رفته است.
ما از دنیای نرمافزارهای «آماده» (Off-the-shelf) به دنیای نرمافزارهای «بهموقع» (Just-in-time) میرویم؛ جایی که توانایی کاربر در توصیف یک مسئله، بسیار مهمتر از توانایی او در نوشتن سینتکس کد است. برای یک کاربر معمولی، این یعنی دیگر مجبور نیستید به ابزاری رضایت دهید که «تقریباً» همان چیزی است که نیاز دارید. اگر سختافزار لازم را داشته باشید، اکنون میتوانید در یک بعدازظهر، جایگزینی خصوصی و رایگان برای محصولات گرانقیمت SaaS تولید کنید.
اگر میخواهید این مسیر را امتحان کنید، ابتدا سختافزار خود را بررسی کنید تا ببینید آیا آستانه رم ۳۲ گیگابایتی را دارید یا خیر، یا به دنبال مدلهای زبانی کوچک (SLM) بگردید که روی ماشینهای ضعیفتر اجرا میشوند.
گام بعدی شما
- سختافزار خود را بررسی کنید تا ببینید آیا رم ۳۲ گیگابایتی را برای اجرای مدلهای محلی دارید یا خیر.
- اگر سختافزار ضعیفتری دارید، به سراغ مدلهای زبانی کوچک (SLM) بروید که منابع کمتری مصرف میکنند.
- افزونه Continue را در VS Code نصب کنید و سعی کنید یک ابزار بسیار ساده (مثل یک ماشینحساب شخصی) را با Ollama بسازید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو