تصور کنید یک کیس گیمینگ قدیمی که سالها در گوشه اتاق خاک میخورده، حالا به دستیاری تبدیل شود که تمام کدهای تکراری شما را بدون نیاز به اینترنت و پرداخت هزینه ماهانه مینویسد. با داشتن یک کارت گرافیک میانرده AMD Radeon RX 6750 XT با ۱۲ گیگابایت حافظه ویدیویی (VRAM)، میتوانید یک سرور اختصاصی برای هوش مصنوعی زاینده (Generative AI) راه بیندازید و نیاز به خرید سختافزار جدید و گرانقیمت در بحران کمبود رم سال ۲۰۲۶ را کنار بگذارید.
به نقل از مستندات این پروژه، استفاده از بکاند Vulkan بهجای پشته محدود ROCm، به توسعهدهندگان اجازه میدهد مدلهای کدنویسی سطح بالایی مثل Qwen2.5-Coder 14B را کاملاً آفلاین و بهصورت رایگان اجرا کنند. این رویکرد در زمانی عرضه میشود که قیمت حافظههای سیستمی بهشدت جهش کرده است؛ بهطوری که کیتهای ۳۲ گیگابایتی DDR4 که زمانی ۵۰ تا ۷۰ دلار قیمت داشتند، اکنون در سال ۲۰۲۶ حدود ۲۰۰ دلار به فروش میرسند. برای توسعهدهندگان، این وضعیت، باززندهسازی سختافزارهای موجود را به یک ضرورت تبدیل کرده است.
همانطور که در تحلیلهای قبلی ما درباره امنیت مدلهای بازمتن اشاره کردیم، در حالی که سطح رایگان مدلهایی مثل Gemini 3.1 Flash-Lite برای کاربران ابری RPMهای بالایی فراهم میکند، اما انتقال به میزبانی محلی مشکلات متفاوتی را حل میکند: حریم خصوصی دادهها — یعنی دور نگه داشتن اطلاعات از سرورهای شرکتهای بزرگ هوش مصنوعی — و حذف کامل محدودیتهای تعداد درخواست (Rate Limit) برای کارهای تکراری مانند نوشتن کدهای boilerplate یا تغییر نام متغیرها. این تمایل به استفاده از مدلهای بهینه با هزینه کمتر، تداوم رویکردی است که در مدلهایی نظیر DeepSeek V4 Flash نیز دیده میشود و ارزش بسیار بیشتری نسبت به مدلهای پریمیوم ارائه میدهد.
زیرساخت سختافزاری
این سیستم روی یک PC گیمینگ مدل ۲۰۲۰ متکی است که در دوران محدودیتهای پاندمی ساخته شده و از سال ۲۰۲۲ در گوشهای خاک میخورده است. این دستگاه با Ubuntu 26.04 LTS مدیریت میشود؛ این توزیع به دلیل رایگان بودن، سبک بودن و مناسب بودن برای عملیات بدون نمایشگر (Headless) از طریق SSH انتخاب شده است. کاربر بهطور مقطعی یک مانیتور را برای کارهای IDE محلی به میز زیرزمین متصل میکند، اما در بیشتر مواقع از طریق یک MacBook Air به آن دسترسی دارد.
مشخصات فنی کامل این سرور به شرح زیر است:
- کیس: Cooler Master NR200 (SFF, 18L) که از پردازندههای گرافیکی سه اسلته تا عرض ۳۳۰ میلیمتر و ارتفاع ۱۵۶ میلیمتر پشتیبانی میکند؛ تنها با منبع تغذیه SFX.
- منبع تغذیه: Cooler Master V850 SFX Gold (۸۵۰ وات، تماممدولار)، که فضای لازم برای ارتقاهای آینده را فراهم میکند.
- مادربورد: ASUS ROG Strix B450-I (Mini-ITX, AM4, DDR4, PCIe 3.0). درگاه AM4 تا سری Ryzen 5000 پشتیبانی میکند که همچنان برای این مورد کاربردی بسیار مناسب است.
- کارت گرافیک: Radeon RX 6750 XT 12GB (RDNA2, gfx1031). نویسنده در حال رصد تخفیفهای RX 7900 XTX یا RTX 3090 به عنوان ارتقای احتمالی است.
- پردازنده: Ryzen 5 2600 (Zen+, ۶ هسته/۱۲ رشته، مدل ۲۰۱۸). این پردازنده کافی است زیرا استنتاج GPU بخش سنگین محاسبات را بر عهده میگیرد.
- رم: ۱۶ گیگابایت DDR4 (که پس از کاهش قیمتها ارتقا خواهد شد).
- ذخیرهساز: یک درایو ۵۰۰ گیگابایتی NVMe و یک درایو ۴ ترابایتی NVMe که هر دو پیش از افزایش قیمتهای سال ۲۰۲۶ خریداری شدهاند.
عبور از سد پشتیبانی ROCm
پشته محاسباتی رسمی AMD یعنی ROCm (معادل CUDA در انویدیا)، فهرستی سختگیرانه از کارتهای گرافیکی مورد حمایت دارد. طبق بررسیهای فنی، مدل RX 6750 XT (با هدف تراشه gfx1031) بهطور مشخص در این لیست غایب است، در حالی که سریهای مشابه ۶۸۰۰ و ۶۹۰۰ (gfx1030) پشتیبانی میشوند. این تفاوت تکرقمی در شناسهی هدف تراشه، عملاً دسترسی سری ۶۷۰۰ را به پشتیبانی رسمی میبندد، اگرچه این لیست متغیر است و در نسخههای مختلف تغییر میکند.
برای مدیریت این وضعیت دو راه اصلی وجود دارد:
۱. فریب ROCm (The ROCm Spoof): یک راهکار میانبر شامل استفاده از متغیر محیطی export HSA_OVERRIDE_GFX_VERSION=10.3.0. این دستور ROCm را فریب میدهد تا کارت را شناسایی کند. با این حال، این روش شکننده است، میتواند با خطاهای "Tensile host" در هنگام مقداردهی اولیه شکست بخورد و اغلب با بهروزرسانیهای کرنل یا خود ROCm از کار میافتد.
۲. رابط Vulkan: استفاده از API گرافیکی و محاسباتی Vulkan که این کارتها بهصورت بومی از آن پشتیبانی میکنند. از آنجایی که Ollama از بکاند Vulkan پشتیبانی میکند، تجربهای پایدار و «تنظیم کن و فراموش کن» فراهم میآورد. باید توجه داشت که اگرچه Vulkan ذاتاً ناتوان در آموزش مدل نیست، اما پشتههای رایج آموزش روی CUDA/ROCm هدفگذاری شدهاند، به این معنی که Vulkan در عمل فقط برای استنتاج (Inference) کاربرد دارد.
مقایسه ROCm و Vulkan
در انتخاب بین این دو مسیر برای مدل gfx1031، توازن زیر برقرار است:
- پایداری: ترفند ROCm یک هک «غیرمجاز» و شکننده است. در مقابل، Vulkan پایدار است، بخشی از Mesa است و پس از بهروزرسانیهای کرنل زنده میماند.
- عملکرد: بهطور تاریخی ROCm سریعتر بود. بنچمارکهای اخیر نشان میدهند ROCm در پردازش پرامپت ۱۰ تا ۲۰ درصد جلوتر است، اما برای کارتهای RDNA2 بهطور خاص، سرعت تولید توکن (Token Generation) اغلب برابر است. Vulkan ابتدا روی RDNA2 توسعه یافت و همین موضوع آن را بسیار رقابتی میکند.
- ابزارها: ROCm مسیر غنیتری برای ابزارهای بومی یادگیری ماشین (مانند PyTorch-ROCm و vLLM) و ابزارهایی مثل
rocm-smiارائه میدهد. Vulkan اثر (Footprint) سبکتری دارد و ازradeontopبرای نظارت استفاده میکند.
برای یک سرور بدون نمایشگر (Headless)، Vulkan پیروز است زیرا نیاز به عیبیابی هکهای عجیب پس از هر بهروزرسانی را از بین میبرد. هدف اینجا ساختن است، نه دیباگ کردن خطاهای درایور.
بودجه VRAM و انتخاب مدل
در مدلهای محلی، حافظه ویدیویی (VRAM) گلوگاه اصلی است زیرا اندازه مدل و ظرفیت پنجره زمینه (Context) را تعیین میکند. با محدودیت ۱۲ گیگابایت VRAM، مدلهای پرچمداری مثل qwen3-coder:30b (حدود ۱۹ گیگابایت) و Codestral 22B (حدود ۱۳ گیگابایت) بیش از حد بزرگ هستند و جای نمیگیرند.
مهندس مربوطه گزینههای ۷ تا ۱۶ میلیارد پارامتری زیر را ارزیابی کرد:
- qwen2.5-coder:14b (انتخابی): با حجم حدود ۹ گیگابایت (کوانتایز Q4_K_M). این مدل بهترین کیفیت کد متراکم در رده خود را ارائه میدهد، قابلیت بومی فراخوانی ابزار (Tool-calling) دارد و میتواند متون میانی را پر کند (Fill-in-the-middle). این مدل غیر-استدلالی است و برای کارهای عمومی سرعت بالایی دارد.
- deepseek-coder-v2:16b: حجم حدود ۸.۹ گیگابایت. یک مدل ترکیب خبرهها (Mixture of Experts) با تنها ۲.۴ میلیارد پارامتر فعال، که آن را به سریعترین گزینه با پنجره متنی عظیم ۱۶۰ هزار توکنی تبدیل میکند، هرچند در استفادههای چندمرحلهای از ابزارها ضعیفتر است.
- deepseek-r1-distill-qwen:14b: حجم حدود ۹ گیگابایت. یک مدل استدلالی (Reasoning Model) که گامبهگام فکر میکند؛ ایدهآل برای دیباگهای سخت اما کندتر برای استفاده روزمره.
- qwen3:14b: حجم حدود ۹ گیگابایت. یک مدل generalist قوی با توانایی کدنویسی بالا، اما بهطور خاص برای کد تخصصی نشده است.
- qwen2.5-coder:7b: حجم حدود ۴.۷ گیگابایت. فضای خالی و سرعت بیشتری فراهم میکند اما سقف عملکرد آن پایینتر است.

پیادهسازی و بهینهسازی
راهاندازی با بهروزرسانی سیستم و نصب mesa-vulkan-drivers ، vulkan-tools و radeontop روی Ubuntu 26.04 آغاز میشود. پس از اجرای دستور vulkaninfo | grep -i deviceName باید کارت گرافیک قابل مشاهده باشد (که در این سیستم خاص به صورت "RADV NAVI22" ظاهر میشود).
نصب Ollama از طریق یک اسکریپت تکخطی curl انجام میشود: curl -fsSL https://ollama.com/install.sh | sh. در این سختافزار، Ollama به عنوان یک سرویس systemd اجرا میشود. در اولین اجرا، یک هشدار مبنی بر حذف دستگاه ROCm ثبت میشود — این برای کارتهای gfx1031 کاملاً مورد انتظار است و تایید میکند که سیستم با موفقیت به Vulkan بازگشته است.
برای دریافت مدل انتخابی، از دستور ollama pull qwen2.5-coder:14b-instruct-q4_K_M استفاده میشود. یک تست سریع (Smoke Test) با درخواست نوشتن تابع معکوس کردن رشته در پایتون، عملیاتی بودن مدل را تایید میکند.
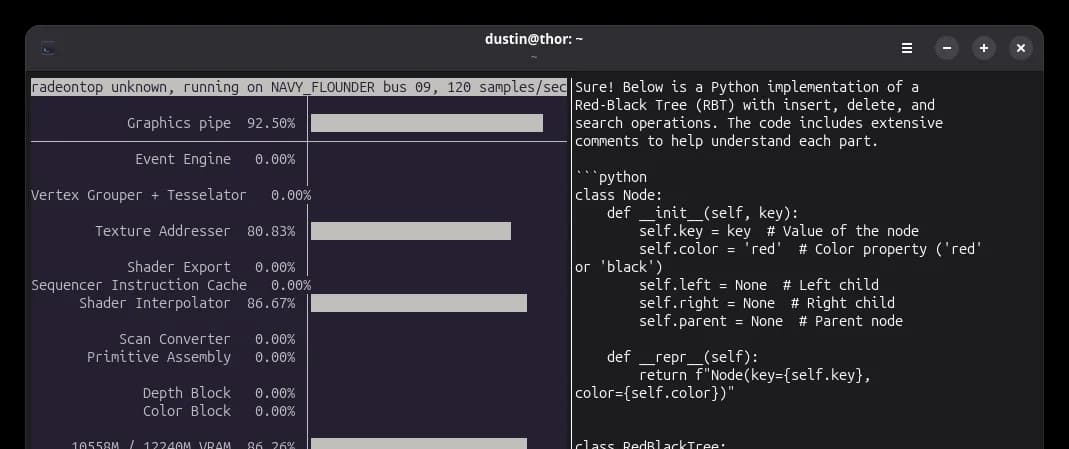
برای اطمینان از اینکه GPU محاسبات را انجام میدهد و سیستم بهطور مخفیانه به CPU بازنگشته است (که منجر به «سوزاندن» CPU و تولید بسیار کند توکنها میشود)، ابزار radeontop به کار میرود. با تقسیم ترمینال از طریق tmux و اجرای radeontop در کنار یک پرامپت پیچیده (مثلاً پیادهسازی درخت قرمز-سیاه)، کاربر میتواند فعالیت GPU را تایید کند.
معیارهای تایید GPU:
- لوله گرافیکی (Graphics pipe): از ۱-۲٪ حالت بیکار به حدود ۹۳٪ فعال میپرد.
- ساعت شیدر (Shader Clock): از ۰.۴٪ به نزدیکی ۹۰٪ میرسد.
- VRAM: در محدوده ۱۰.۳ از ۱۲.۲ گیگابایت ثابت میماند (مدل در حافظه مقیم است).
بسیار حیاتی است که در هنگام استریم توکنها، لوله گرافیکی و ساعت شیدر را زیر نظر بگیرید. اگر محاسبات تخت میماند در حالی که توکنها جاری هستند، یعنی بازگشت به CPU رخ داده است.
بهینهسازی محیط:
پنجرههای زمینه به دلیل حافظه KV cache باعث مصرف VRAM میشوند. اگرچه Qwen2.5-Coder بومی 32K کانتکست را پشتیبانی میکند، اما مهندس برای اطمینان از فضای کافی در کارت ۱۲ گیگابایتی، کانتکست پیشفرض را روی ۸ هزار توکن محدود کرد. این کار باعث شد حافظه مقیم حدود ۱۰.۳ گیگابایت شود.
این تنظیم از طریق یک فایل drop-in در مسیر /etc/systemd/system/ollama.service.d/override.conf و با استفاده از متغیر محیطی OLLAMA_CONTEXT_LENGTH=8192 پیاده شد.
برای کارهای نیازمند به کانتکست بیشتر، پارامتر num_ctx را میتوان بهصورت موردی در هر درخواست از طریق API تغییر داد (مثلاً روی ۱۶۳۸۴ تنظیم کرد) تا مالیات دائمی VRAM روی هر فراخوانی اعمال نشود. سایر تنظیمات مفید API عبارتند از:
- دما (Temperature): بین ۰.۱ تا ۰.۳ برای کدهای قطعی (Deterministic)؛ بالاتر برای ایدهپردازی.
- keep_alive: تنظیم روی
-1برای میخکوب کردن مدل در حافظه و دور زدن تایمر پیشفرض ۵ دقیقهای برای تخلیه مدل.
به دلیل اینکه ماشین تنها ۱۶ گیگابایت رم سیستمی دارد، zram با استفاده از systemd-zram-generator پیادهسازی شد. این کار یک دستگاه سواپ (Swap) فشرده در رم ایجاد میکند تا از کرشهای OOM (کمبود حافظه) در هنگام جهشهای ارکستراسیون جلوگیری کند.
جزئیات پیکربندی zram:
- اندازه: تنظیم شده روی
min(ram, 8192)که یک دستگاه فشرده ۸ گیگابایتی ایجاد میکند. - الگوریتم:
zstdبرای فشردهسازی بهینه. - Swappiness: تنظیم شده روی
180(از طریق/etc/sysctl.d/99-zram.conf). از آنجایی که کرنلهای ۵.۸ به بعد سقف ۲۰۰ دارند، این مقدار کرنل را به سمت تخلیه صفحات در رم فشرده برای آزاد کردن فضای page cache سوق میدهد. - اصلاح حیاتی: مهندس اشاره کرد که دستور
systemctl startکافی نیست زیرا تنظیمات پیشفرض سازنده (۴ گیگابایت/lzo-rle) هنگام نصب فعال هستند. برای اعمال پیکربندیهای سفارشی، اجرایsystemctl restart [email protected]ضروری است. این موضوع از طریقzramctlوswapon --showتایید میشود.
استراتژی «دو لایه»
این پیکربندی سختافزاری، یک گردشکار هوشمند AI ایجاد میکند. مدل محلی Qwen2.5-Coder به عنوان «لایه کارگری» (Worker Tier) عمل میکند و کارهای تکراری، تغییر نام متغیرها و توابع ساده را بر عهده میگیرد. تنها «مسائل سخت» — مانند معماریهای پیچیده یا دیباگهای عمیق — به مدلهای پیشرو (Frontier Models) گرانقیمت و ابری ارجاع داده میشوند.
این روش باعث صرفهجویی در اعتبارهای گرانبهای API و کاهش تأخیر (Latency) برای عملیاتهای ساده میشود. این سرور همچنین یک API سازگار با OpenAI در آدرس http://localhost:11434/v1 ارائه میدهد که اجازه میدهد مستقیماً به اکثر افزونههای IDE و ابزارهای کدنویسی AI با یک کلید جعلی (Dummy Key) متصل شود. از آنجایی که سرور بدون حالت (Stateless) است، تاریخچه گفتگوها در سمت کلاینت نگه داشته میشود.
این ساختار ثابت میکند که مانع ورود به دنیای AI محلی، داشتن آخرین سختافزارهای پرچمدار نیست، بلکه داشتن VRAM کافی و بکاند نرمافزاری درست است. این رویکرد یک PC گیمینگ بیکار را با هزینه برق، به یک دستیار سطح تولید (Production-grade) تبدیل میکند.
در گام بعدی، مهندس بررسی خواهد کرد که چگونه این سرور محلی را از طریق یک شبکه مش رمزنگاریشده (Encrypted Mesh Network) برای دستگاههای راه دور در دسترس قرار دهد تا دسترسی امن از هر مکان بدون قرار گرفتن در معرض اینترنت عمومی فراهم شود. پستهای بعدی همچنین به این موضوع میپردازند که آیا یک مدل 14B کوانتایز شده را میتوان واقعاً برای کارهای واقعی تولید (Production) اعتماد کرد و همچنین توسعه یک حلقه عامل (Agent Loop) خودکار برای جریانهای کاری بدون نظارت را بررسی خواهند کرد.
گام بعدی شما
- اگر کارت گرافیک AMD قدیمی دارید، بهجای تلاش برای نصب ROCm، مستقیماً از بکاند Vulkan در Ollama استفاده کنید.
- مدل Qwen2.5-Coder 14B را برای تسکهای تکراری کدنویسی امتحان کنید تا هزینه APIهای ابری را کاهش دهید.
- برای پایداری سیستم در رمهای پایین (زیر ۱۶ گیگابایت)، پیکربندی zram را در اوبونتو فعال کنید.
اما داستان دسترسی به این سرور از راه دور از طریق شبکههای مش رمزنگاریشده حتی جذابتر است — در گزارشهای آینده، امنیت دسترسی خارجی به مدلهای محلی را بررسی خواهیم کرد.



گفتگو