یک اشتباه کوچک در برچسب مواد غذایی میتواند منجر به بستری شدن مشتری در بیمارستان یا فراخوان هزینهبر محصولات شود. BoldPrint به عنوان یک توری ایمنی حیاتی، این ریسک را برای تولیدکنندگان خرد حذف میکند. این ابزار که برای چالش هوش مصنوعی متنباز DEV × Hacktoberfest ۲۰۲۶ ساخته شده، فرآیند تولید برچسبهای قانونی مواد حساس (Allergens) را برای فروشندگان بازارهای محلی و نانوایان خانگی خودکار میکند.
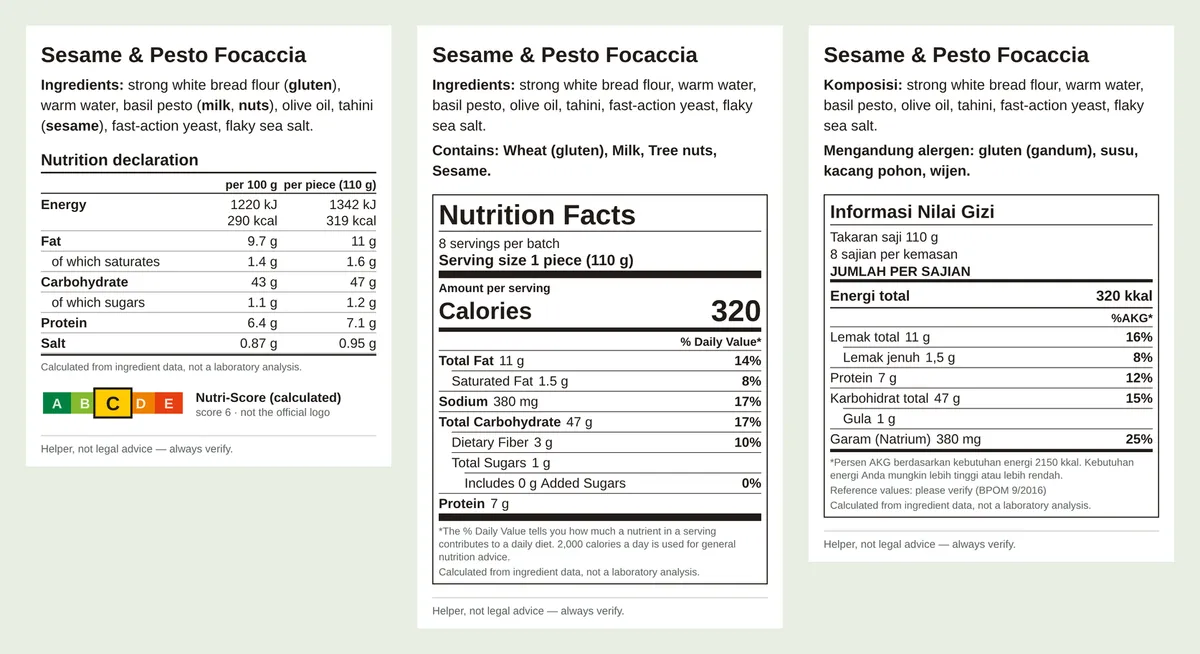
برای کسبوکارهای کوچک، برچسبگذاری یک میدان مین حقوقی است. در اتحادیه اروپا و بریتانیا، ۱۴ ماده حساس اصلی باید بهصورت برجسته (Bold) در لیست ترکیبات نوشته شوند، در حالی که قوانین ایالات متحده نیازمند یک خط مشخص با عبارت «Contains:» است. در اندونزی نیز عبارت «Mengandung alergen» الزامی است. بسیاری از فروشندگان خرد این کار را دستی انجام میدهند و همینجا خطر شروع میشود؛ چرا که موادی مثل ارده (کنجد) یا روغن گھی (شیر) ماهیت واقعی خود را پنهان میکنند و ریسک حذفهای خطرناک را افزایش میدهند.
زمینه و بستر تولیدات خانگی
برندهای بزرگ از متخصصان فناوری غذا برای مدیریت انطباق با قوانین استفاده میکنند. در مقابل، یک نانوای صبحهای شنبه معمولاً فقط به یک کارت دستورپخت و یک چاپگر برچسب تکیه میکند. خطر اصلی در «آلرژنهای پنهان» است؛ یعنی موادی که نامشان صراحتاً محتویات را لو نمیدهد. برای مثال، سس ورچستر حاوی ماهی آنچوی است، کلمه Pinoli در ایتالیایی به معنای دانه صنوبر است و بیسکوف شامل گندم و سویاست. حتی یک شکلات اسنیکرز ترکیبی پیچیده از بادامزمینی، شیر، سویا و تخممرغ است.
اشتباه در برچسبگذاری میتواند منجر به جریمههای مالی، فراخوان محصول یا اعزام مشتری به بیمارستان شود. برای نانوایان خانگی، آشپزهای غرفههای بازار و فروشندگان کوچک در Etsy، سرویسی که بتواند با هزینه چند دلار در ماه، «دستورپخت را بگیرد، استیکر را چاپ کند و اردههای پنهان را شناسایی کند»، یک پیشنهاد بسیار جذاب و کاربردی است.
به نقل از گزارش فنی منتشر شده در ۱۷ اکتبر ۲۰۲۶، توسعهدهنده BoldPrint دریافت که لغتنامههای ساده کافی نیستند. او با استفاده از تاکسونومی مواد غذایی Open Food Facts — لغتنامهای با ۳۲ هزار ورودی — متوجه شد که رویکرد لغتنامهمحور همچنان ۱۱٪ از مواد حساس را در ۳۲ دستورپخت واقعی نادیده میگیرد. این سیستم در برابر غلطهای املایی مثل «tahinni» و «worchestershire» شکست میخورد و نمیتوانست خمیر میگو (shrimp paste) پنهان شده در خمیر کاری سبز را تشخیص دهد. همچنین این سیستم قادر نبود تشخیص دهد که «دیژون» در واقع همان خردل است.
معماری فنی
برای رفع این شکافها، یک خط لوله هوش مصنوعی چندمرحلهای طراحی شد:
- تولید دادههای مصنوعی (Synthetic Data): ۳ هزار دستورپخت مصنوعی در ۱۰ زبان مختلف ساخته شد. این دادهها شامل مقادیر نامنظم، لیستهای گلولهای (bullets)، غلطهای املایی، عناوین و مراحل روش پخت بودند تا کارتهای دستورپخت دنیای واقعی شبیهسازی شوند. برای اطمینان از اینکه مدل به جای حفظ کردن، یاد بگیرد تعمیم دهد، ۲۰٪ از مواد غذایی «دمدراز» (long-tail) یا کمیاب کاملاً از دادههای آموزشی حذف شدند.
- تنظیم نظارتشده (SFT): توسعهدهنده مدل Qwen3-8B (تحت لایسنس Apache-2.0) را با استفاده از آداپتور لورا (LoRA) روی پلتفرم Tinker تنظیم کرد. هدف این بود که مدل را مجبور کند برای هر دستورپخت، دقیقاً یک شیء JSON سختگیرانه برگرداند که هر ماده و آلرژنهای مرتبط با آن را لیست کند. این فرآیند توسط یک لیست جایگزین (override list) دستی برای قوانین خاص پشتیبانی شد؛ مثلاً طبق قوانین اتحادیه اروپا، جو دوسر باید به عنوان گلوتن محسوب شود.
- یادگیری تقویتی نامتقارن (Asymmetric RL): چون نادیده گرفتن یک ماده حساس بسیار خطرناکتر از گزارش اشتباه (مثبت کاذب) است، تابع پاداش بهگونهای تنظیم شد که جریمههای سنگینی برای حذف مواد حساس در نظر بگیرد. مدل برای هر مورد حذف شده، ۱۰- امتیاز و برای هر گزارش اشتباه تنها ۱- امتیاز دریافت میکرد. جریمههای اضافی شامل ۱۰- برای هر آلرژن واقعی و ۵- در صورتی که خروجی JSON معتبر نبود، اعمال میشد. در صورتی که لیست «contains» دقیقاً درست بود، پاداش ۱+ داده میشد.
بنچمارکهای عملکرد
با استفاده از حلقه آموزشی Tinker (شامل نمونهبرداری، امتیازدهی، forward_backward و optim_step)، توسعهدهنده نرخ مواد حساس حذف شده در هر برچسب را طی ۲۰ گام RL از ۰.۰۵ به زیر ۰.۰۲ کاهش داد و میانگین پاداش را از ۰.۲۲ به ۰.۶۶ رساند (سه برابر شد).
نتایج این رویکرد جهشی قابل توجه در ایمنی نسبت به مدلهای پایه نشان میدهد. در یک مجموعه تست شامل ۳۲ دستورپخت واقعی که به صورت دستی برچسبگذاری شده بودند و برندها و زبانهای مختلفی داشتند، نرخ خطا به شرح زیر بود:
- مدل Qwen3-8B بدون آموزش: ۷۴٪ خطا (۲۵ مورد از ۳۲ برچسب).
- فقط لغتنامه (Open Food Facts): ۱۱٪ خطا (۹ مورد از ۳۲ برچسب).
- مدل تنظیمشده (SFT + RL): ۶٪ خطا (۵ مورد از ۳۲ برچسب).
- BoldPrint (ترکیب مدل و بازبینی لغتنامه): ۳٪ خطا (۲ مورد از ۳۲ برچسب).
در یک مجموعه بزرگتر از ۳۰۰ دستورپخت مصنوعی که از آموزش جدا شده بودند، نرخ خطای مدل تنظیمشده به ۱.۶٪ رسید، در حالی که برای نسخه بدون آموزش این رقم ۲۹.۸٪ بود. نسخه نهایی «ارسال شده» از لغتنامه به عنوان توری ایمنی استفاده میکند؛ اگر لغتنامه مادهای را پیدا کند که مدل نادیده گرفته، اپلیکیشن عبارت «⚠ Check» را اضافه میکند تا انسان آن را بررسی کند. اگر سرور Tinker در دسترس نباشد، برنامه به حالت «فقط لغتنامه» بازگشته و از طریق یک بنر به کاربر اطلاع میدهد.
فراتر از تشخیص آلرژنها
BoldPrint همچنین محاسبات خستهکننده جداول تغذیهای را که نانوایان بازار اغلب از انجام دستی آن میترسند، خودکار میکند. این سیستم اندازهگیریهای مبهم — مانند «پیمانه»، «۲ قاشق غذاخوری»، «1 c. à soupe»، «آب یک لیموی تازه» یا «یک قوطی» — را به گرم تبدیل میکند.
مکانیزمهای تغذیهای:
- تأمین دادهها: اپلیکیشن مواد را با استفاده از حدود ۱۳۰ ماده پایه که به صورت دستی نقشهبرداری شدهاند و لینکهای تاکسونومی Open Food Facts، با جدول CALNUT (جدول مواد مغذی باز آژانس غذایی فرانسه) تطبیق میدهد.
- محاسبات: سیستم مواد مغذی را جمع کرده و آنها را بر وزن نهایی محصول تقسیم میکند.
- انطباق: سیستم از جداول گرد کردن اتحادیه اروپا و آمریکا و الگوریتم Nutri-Score ۲۰۲۳ پیروی میکند. همچنین لیست مواد را بر اساس وزن (از سنگینترین به سبکترین) مرتب میکند، همانطور که قانون میطلبد.
- نظارت انسانی: هر مقدار حدسی (مثلاً «یک پیمانه پستو») در پنل «Check nutrition» ظاهر میشود تا کاربران بتوانند به صورت دستی گرمها را وارد کنند یا ماده دیگری را انتخاب کنند تا برچسب بدون نیاز به فراخوانی مجدد مدل، بازترسیم شود.
برای تضمین شفافیت، برچسبها صراحتاً ذکر میکنند که «بر اساس دادههای مواد تشکیلدهنده محاسبه شده است، نه تحلیل آزمایشگاهی».
اقتصاد مدلهای کوچک
BoldPrint به عنوان یک کسبوکار جانبی (side hustle) طراحی شده است، به این معنی که نمیتواند هزینههای بالای API برای هر برچسب را تحمل کند. با استفاده از یک مدل ۸ میلیارد پارامتری به جای APIهای بسته و عظیم، هزینه عملیاتی به شدت کاهش یافته است. توسعهدهنده گزارش میدهد که هزینه سیستم تقریباً ۰.۱۲ دلار به از احساس هر ۱۰۰۰ برچسب است. این امر اجازه میدهد سرویس با هزینه چند دلار در ماه ارائه شود و برای نانوایان خانگی مقرونبهصرفه باشد.
کل فرآیند آموزش به طرز شگفتآوری ارزان بود و حدود ۲.۳۰ دلار اعتبار Tinker هزینه داشت، که شامل اجراهای ارزیابی نیز میشد. این موضوع قدرت مدلهای با وزنهای باز (Open-weight) مانند Qwen را نشان میدهد که به توسعهدهندگان اجازه میدهد توابع پاداش خود را تعریف کنند، به جای اینکه به یک پرامپت کلی «مراقب باش» در یک سیستم بسته تکیه کنند.
استک فنی و تحویل
این برنامه بر روی استکی متشکل از Qwen3-8B، Tinker (برای LoRA SFT + RL)، Open Food Facts، CALNUT (ANSES)، FastAPI و canvas ساخته شده است. برچسب نهایی یک صفحه وب نیست، بلکه یک تصویر است؛ پیشنمایش، PNG و PDF توسط یک رندرکننده کوچک canvas رسم میشوند. فایل PDF در واقع یک پوشش جاوااسکریپتی سبک ۴۰ خطی دور یک JPEG است تا تضمین شود آنچه کاربر میبیند، دقیقاً همان چیزی است که روی کاغذ استیکر ۹۰ میلیمتری چاپ میشود.
کیفیت از طریق بیش از ۲۵۰ تست pytest و یک بررسی Playwright حفظ میشود. دموی زنده روی سرویس رایگان Render اجرا میشود که دارای استقرار خودکار (auto-deploy) از شاخه main و سقف هزینههای تعیین شده از طریق متغیرهای محیطی است.
این پروژه نشاندهنده تغییری به سمت «مدلهای کوچک تخصصی» است که در حوزههای محدود و حساس، از غولهای عمومی پیشی میگیرند. با ترکیب دادههای باز، RL هدفمند و بازبینی متقاطع ایمن، BoldPrint یک کار دستی خطرناک را به یک فرآیند خودکار و قابلاعتماد تبدیل کرده است.
شما میتوانید پیادهسازی فعلی را در دموی زنده روی Render تست کنید، هرچند سرور رایگان ممکن است تا یک دقیقه زمان ببرد تا از حالت خواب بیدار شود.
گام بعدی شما
- اگر تولیدکننده مواد غذایی هستید، از ابزارهای بازبینی متقاطع (Cross-check) برای تایید برچسبها استفاده کنید.
- توسعهدهندگان میتوانند برای کاهش هزینه استنتاج، به جای مدلهای بزرگ، روی تنظیم دقیق مدلهای ۸ میلیاردی برای کارهای تخصصی تمرکز کنند.
- بررسی کنید که آیا دادههای باز مانند Open Food Facts میتوانند جایگزین پایگاههای داده گرانقیمت در پروژه شما شوند یا خیر.
اما داستان کاهش هزینههای استنتاج در مدلهای کوچک حتی شگفتانگیزتر است — به تحلیل ما دربارهی بهینهسازی مدلهای SLM مراجعه کنید.



گفتگو