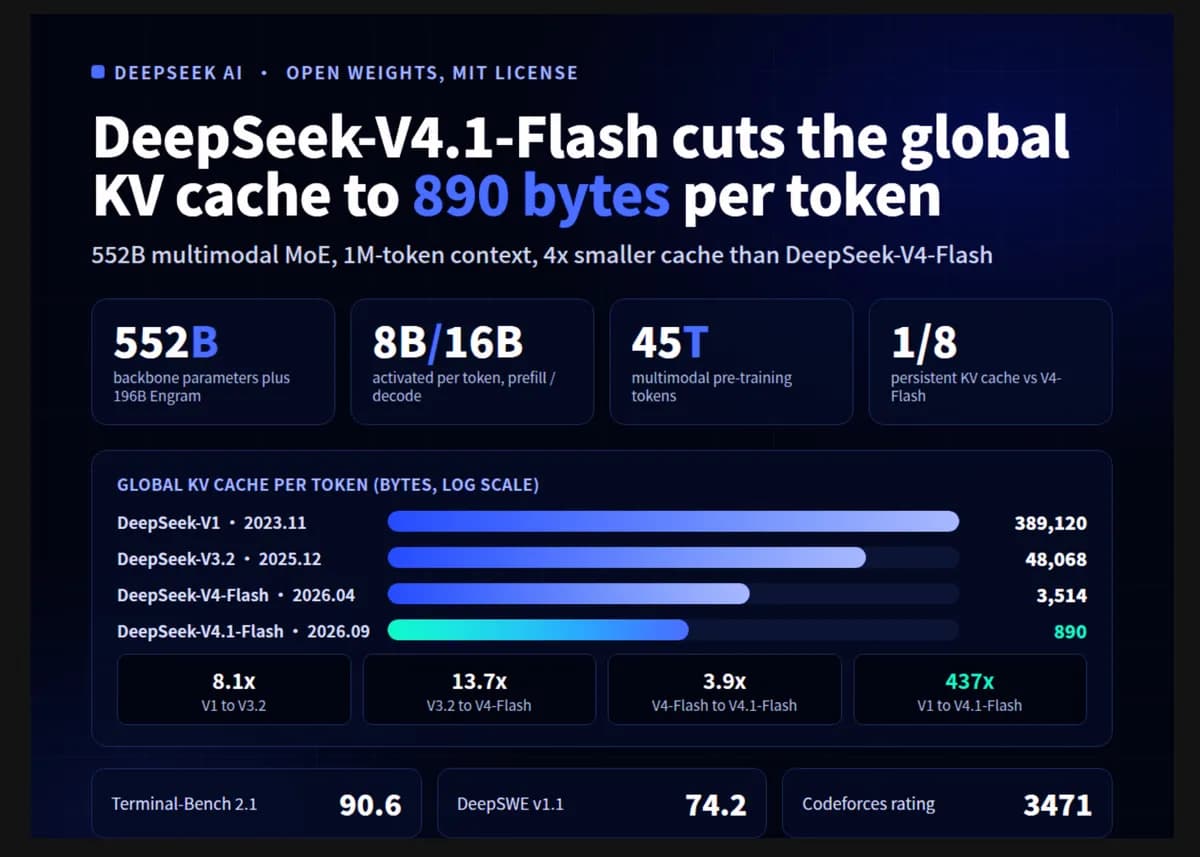
گلوگاههای حافظه در عاملهای هوش مصنوعی با افق زمانی بلند دیگر یک اجبار فنی نیستند. DeepSeek AI با معرفی مدل DeepSeek-V4.1-Flash، اثر حافظه KV Cache (حافظهٔ کلید-مقدار) را به تنها ۸۹۰ بایت بهازای هر توکن رساند؛ عددی که تقریباً ۴۳۷ برابر کوچکتر از نسخه V1 و حدود یکچهارم نسخه V4-Flash است.
سرویسدهی به پنجرههای متنی (Context Window) یک میلیون توکنی معمولاً بهدلیل پیشپُرکردنهای (Prefill) مکرر، فشار شدیدی به حافظه HBM (حافظه پهنایباند بالا)، ظرفیت SSD و پهنایباند وارد میکند. به گزارش Marktechpost، هدف این نسخه حذف دقیق همین گلوگاه برای تبدیل عاملهای با زمینه بلند به ابزارهایی قابلاستقرار در مقیاس واقعی است. این مدل دارای یک بدنه ۵۵۲ میلیارد پارامتری با ۱۹۶ میلیارد پارامتر اضافی Engram است، اما در مرحله پیشپُرکردن تنها ۸ میلیارد و در مرحله رمزگشایی (Decoding) ۱۶ میلیارد پارامتر را فعال میکند.
کارایی معماری
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی استنتاج در مدلهای MoE اشاره کردیم، کاهش پارامترهای فعال بدون افت کیفیت، کلید مقیاسپذیری است. در این مدل، یک ساختار رمزگذار-رمزگشای علی (Causal Encoder-Decoder) به کار رفته که بدنه ۴۰ لایهای آن بهطور مساوی بین ۲۰ لایه رمزگذار و ۲۰ لایه رمزگشا تقسیم شده است. با الهام از معماری YOCO، رمزگشا دیگر KV جهانی خود را محاسبه نمیکند، بلکه آن را از آخرین حالت پنهان رمزگذار از طریق وزنهای تصویر (Projection Weights) هر لایه استخراج میکند. این طراحی محاسبات پیشپُرکردن را تقریباً نصف میکند زیرا توکنهای پرامپت در رمزگذار متوقف میشوند و دیگر نیازی به پردازش مجدد در لایههای رمزگشا نیست.
برای حفظ زمینه محلی، مدل از توجه پنجره لغزان (Sliding-Window Attention یا SWA) با پنجره ۱۲۸ توکنی استفاده میکند. از طریق فرآیندی به نام Decoder SWA Bounded Replay، سیستم حالتهای رمزگشا را با بازپخش تنها ۱۲۸ توکن آخر پرامپت بازسازی میکند و نیازی به پردازش کل توالی نیست. این مکانیسم اجازه میدهد تا مدل بدون مصرف حافظه نجومی، جزئیات نزدیک را بهطور دقیق حفظ کند.
توجه پراکنده فشرده ۲ (CSA2)
مدل V4.1-Flash برای حمله به اندازه حافظه در محور لایهها، از مکانیزم توجه پراکنده فشرده ۲ (CSA2) استفاده میکند. در حالی که نسخه V4 ترکیبی از CSA و توجه بهشدت فشرده (Heavily Compressed Attention) بود، نسخه جدید بهطور خالص از CSA2 بهره میبرد. در این ساختار، هر لایه به یکی از سه حالت زیر اختصاص مییابد:
- Full: محاسبه KV اصلی، تصویر کردن K شاخصساز (Indexer K) از آن و انتخاب ۵۱۲ شاخص برتر (Top-512) جدید.
- Reindex: استفاده مجدد از KV اصلی و K شاخصساز لایه Full قبلی، اما امتیازدهی مجدد به آنها با استفاده از Q شاخصساز لایه فعلی.
- Reuse: حذف کامل شاخصساز و استفاده مجدد از هر دو مورد KV اصلی و آخرین شاخصهای Top-K.
در ۱۸ لایه رمزگذار CSA2، نسبت فشردهسازی ۲ در ۳ گروه ۶تایی است (۱ لایه Full و ۵ لایه Reuse). ۲۰ لایه رمزگشا نیز از نسبت ۱ در ۵ گروه ۴تایی استفاده میکنند: لایه اول Full به همراه ۳ لایه Reuse است و بقیه لایهها شامل یک Reindex به همراه ۳ لایه Reuse هستند. هر لایه همچنان Q اصلی و SWA KV مخصوص به خود را حفظ میکند.
علاوه بر این، یک شاخصساز پراکنده سلسلهمراتبی (Hierarchical Sparse Indexer) با ساخت یک استخر کاندیدا تا ۱۶,۳۸۴ موقعیت (شامل ۲۰۴۸ بلوک ۸تایی)، رمزگشا را بهینه میکند. این امر تضمین میکند که لایههای Reindex بعدی بهجای امتیازدهی به کل زمینه، روی یک مجموعه محدود و بهینه امتیازدهی کنند.
کوانتش و مدیریت حافظه
بر اساس مستندات فنی، ذخیرهسازی با کوانتش (Quantization) حافظه KV اصلی به فرمت E2M1 (FP4) با یک مقیاس E4M3 بهازای هر ۱۶ کانال بیشتر کاهش یافته است. این روش از استاندارد NVFP4 پیروی میکند اما بدون مقیاس جهانی آن است. این آموزشِ آگاه از کوانتش که در مرحله پسآموزش (Post-training) معرفی شده، فضای ذخیرهسازی را در مقایسه با حافظه FP8 در نسخه V4 تقریباً نصف کرده است.
در سطح استقرار، SWA KV دیگر روی SSD ذخیره نمیشود، بلکه در یک استخر توزیعشده که از ۱۰٪ از DRAM میزبان جدا شده، با زمان ماندگاری (TTL) چند دقیقهای قرار میگیرد. در مقابل، KV جهانی دارای ضمانت ماندگاری ۷۲ ساعته است. در صورت نبود داده در حافظه (Miss)، مکانیزم Encoder SWA Bounded Replay بهجای محاسبه تمام لایهها ضربدر پنجره، تنها ۱۲۸ توکن را بازسازی میکند.
توسعههای فنی تکمیلی
DeepSeek چندین بهینهسازی دیگر را برای کاهش سربار پیاده کرده است:
- Single-Pass mHC: جابجایی ضرایب ترکیب ورودی به اندازه یک بلوک، که اجازه میدهد یک کرنل ادغامشده Mega-mHC ترافیک حافظه فعالسازها را نصف کند.
- ماژول Engram: یک ماژول حافظه شرطی که در لایههای ۱ و ۱۴ قرار گرفته است.
- DSpark: رمزگشایی گمانهزنانه (Speculative Decoding) که پس از پیشآموزش، در حالی که بدنه مدل منجمد (Frozen) بود، آموزش دیده است.
- Head-wise Muon: اعمال این بهینهساز برای بهبود وزنهای مدل.
بنچمارکهای آموزشی و عملکردی
پیشآموزش این مدل روی ۴۵ تریلیون توکن چندوجهی با نسبت ۷ به ۱ (متن به چندوجهی) انجام شده است. توجه پراکنده از ابتدا با طول توالی ۶۴ هزار توکن و بدون گرمکردن (Warmup) متراکم آموزش دیده و سپس زمینه تا ۱ میلیون توکن در ۳۴ تریلیون توکن گسترش یافته است. این مدل در کدنویسی و دانش جهانی با DeepSeek-V4-Pro-Base برابری میکند، در حالی که تنها از یکسوم کل پارامترها و یکچهارم پارامترهای فعال استفاده میکند.
در مراحل پسآموزش، تمرکز بر سنتز مقیاسبزرگ وظایف عاملهای قابلتأیید و یادگیری تقویتی (RL) روی چارچوبهایی مانند Claude Code، Codex، OpenCode، Pi، mini-SWE و DeepSeek Harness بود، که در آن از تقطیر (Distillation) On-policy از بیش از ۴۰ مدل معلم استفاده شد. این رویکرد در ادامه تلاشهای DeepSeek برای ارتقای توانمندیهای عاملهای هوشمند است که پیشتر در مدل V4-Flash-Vision-Exp نیز شاهد رقابت تنگاتنگ آن با مدل Opus 4.8 بودیم. در آزمونهای رودررو، V4.1-Flash از Opus-5 و GPT-5.6 Sol در محک Terminal-Bench 2.1 (امتیاز ۹۰.۶ در برابر ۸۸.۸) و DeepSWE v1.1 (امتیاز ۷۴.۲ در برابر ۷۳.۰) پیشی گرفت. همچنین این مدل امتیاز ۳۱.۲ در Terminal-Bench 4.0 و ۵۴.۸ در Automation-Bench کسب کرد.
نکته قابل توجه این است که با گسترش زمینه از ۴ هزار به ۱ میلیون توکن، عملیات اعشاری (FLOPs) رمزگشایی تکتوکنی تنها ۲۵٪ افزایش مییابد. این تغییر معماری نشان میدهد که صنعت در حال فاصله گرفتن از حافظههای KV متراکم و حرکت به سمت نمایشهای پراکنده، مشترک و کوانتیده است. DeepSeek با جداسازی نیازهای KV رمزگذار و رمزگشا ثابت کرد که پنجرههای ۱ میلیون توکنی را میتوان بدون افزایش خطی هزینه حافظه مدیریت کرد.
توسعهدهندگان اکنون میتوانند به وزنهای باز این مدل تحت لایسنس MIT از طریق Hugging Face دسترسی داشته باشند که از vLLM، SGLang و Transformers پشتیبانی میکند. تیم تحقیق همچنین یک API عمومی را معرفی کرده است که دارای سه سطح استدلال پایین (Low)، بالا (High) و حداکثری (Max) است.
گام بعدی شما
- اگر توسعهدهنده عاملهای هوش مصنوعی هستید، وزنهای باز این مدل را از Hugging Face دریافت کرده و با vLLM یا SGLang تست کنید.
- برای کاهش هزینه استنتاج در پروژههای خود، معماری رمزگذار-رمزگشای علی را برای مدیریت پنجرههای متنی بلند بررسی کنید.
- عملکرد مدل را در وظایف اتوماسیون ترمینال با استفاده از محک Terminal-Bench 4.0 بسنجید.
اما تأثیر این بهینهسازیها بر سختافزارهای لبه حتی جذابتر است — به تحلیل ما دربارهی تراشههای NPU نسل جدید مراجعه کنید.



گفتگو