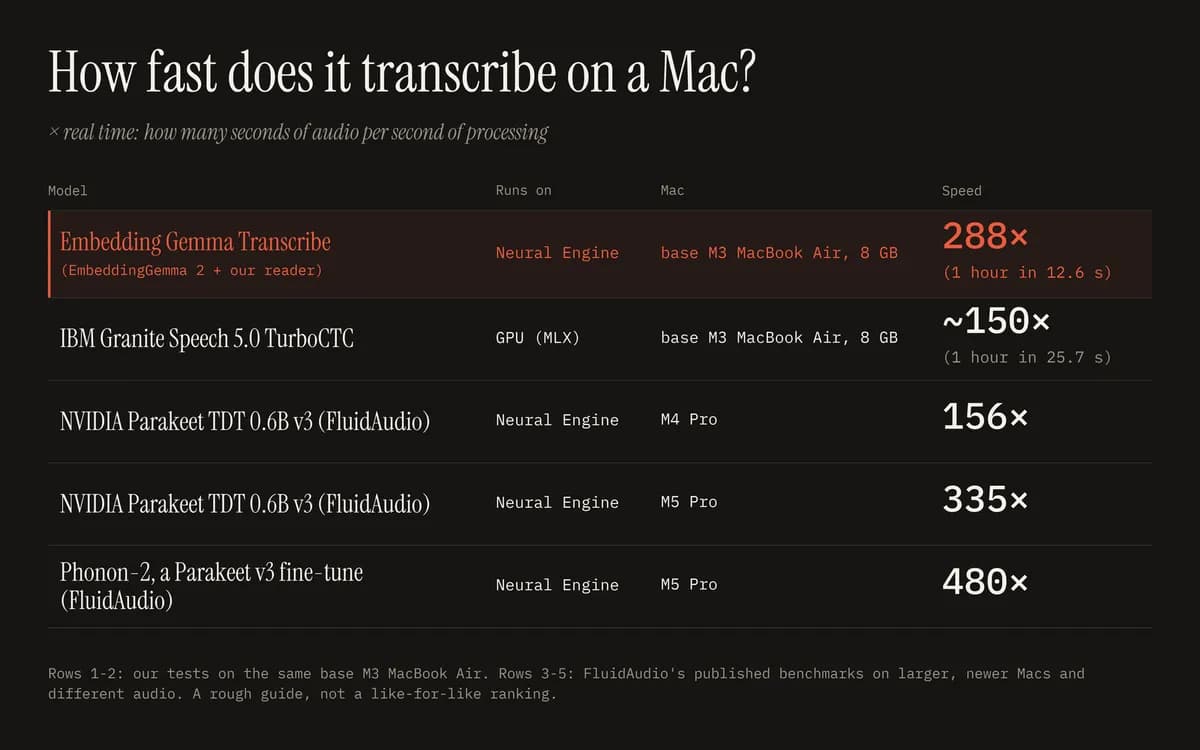
۱۲.۶ ثانیه؛ این تمام زمانی است که یک مکبوک ایر M3 پایه برای تبدیل یک ساعت فایل صوتی به متن نیاز دارد. این سرعت خیرهکننده مدیون ابزاری به نام Embedding Gemma Transcribe است که از مدل EmbeddingGemma 2 شرکت گوگل برای انجام عملیات تبدیل گفتار به متن (Speech-to-Text) بهصورت کاملاً محلی استفاده میکند.
بیشتر مدلهای بازشناسی گفتار (ASR) صرفاً برای تبدیل صوت به متن آموزش دیدهاند. اما EmbeddingGemma 2 یک مدل بردار معنایی (Embedding) — شبیه به کارت معرفی عددی برای هر واژه که میگوید این کلمه «همسایهی» چه کلمات دیگری است — و چندوجهی (Multimodal) است؛ یعنی متن، تصویر، صوت و ویدیو را در یک فضای ریاضی مشترک قرار میدهد. همانطور که در تحلیلهای قبلی ما دربارهی مدلهای چندوجهی اشاره کردیم، در این فضای مشترک، کلمات گفتهشده در نزدیکی معادلهای نوشتاری خود قرار میگیرند. توسعهدهندگان متوجه شدند که میتوان مختصات صوتی را مستقیماً بهعنوان متن «خواند».
طبق گزارشی که در ۱۳ اکتبر ۲۰۲۶ منتشر شد، این سیستم از یک «خواننده» (Reader) کوچک استفاده میکند که قطعات صوتی را به فضای متنی مدل منتقل میکند. سپس نزدیکترین تطابق از میان حدود ۲۲۹,۰۰۰ واژه انگلیسی انتخاب شده و یک مدل بسیار کوچک دیگر، علائم نگارشی و حروف بزرگ را اصلاح میکند.
بر اساس مستندات فنی، عملکرد این سیستم روی یک مکبوک ایر M3 با ۸ گیگابایت رم به شرح زیر است:
- Embedding Gemma Transcribe: سرعت ۲۸۸ برابر زمان واقعی (۱ ساعت در ۱۲.۶ ثانیه)
- IBM Granite Speech 5.0 Turbo: سرعت ۱۵۰ برابر زمان واقعی (۱ ساعت در ۲۵.۷ ثانیه)
به نقل از توسعهدهندگان، این خواننده در کمتر از دو ساعت و با استفاده از ۸ عدد GPU مدل H100 آموزش دیده است. اگرچه نرخ خطای کلمه (Word Error Rate) فعلی حدود ۵٪ است — که نسبت به نرخ ۲ تا ۳ درصدی مدلهای تخصصی بیشتر است — اما ادعا شده که با آموزش بهتر خواننده، این فاصله پر خواهد شد. در همین راستا، رقابت برای کاهش نرخ خطا شدت یافته است و مدل MAI-Transcribe-2 مایکروسافت توانسته است به نرخ خطای ۲.۵ درصد دست یابد تا پاسخدهی بلادرنگ را بهینه کند.
این رویکرد ثابت میکند که فضاهای برداری چندوجهی میتوانند جایگزین معماریهای سنتی تبدیل گفتار به متن شوند. برای کاربر، این یعنی دیکته و تبدیل صوت به متن تقریباً آنی که هرگز دستگاه را ترک نمیکند و حریم خصوصی را بر دقت مطلق ترجیح میدهد. این در حالی است که برخی شرکتها بر گسترش زبانی تمرکز کردهاند و برای مثال مایکروسافت مدل MAI-Transcribe-2 را برای پشتیبانی از ۶۰ زبان مختلف عرضه کرد.
در حال حاضر نسخه ۱.۶ برای سیستمعامل macOS 14 و بالاتر روی تراشههای اپل سیلیکون در دسترس است.
گام بعدی شما
- اگر از مکبوکهای سری M استفاده میکنید، نسخه v1.6 را برای تست سرعت استنتاج محلی نصب کنید.
- برای پروژههایی که سرعت و حریم خصوصی اولویت دارند، این مدل را جایگزین APIهای ابری کنید.
- منتظر بهروزرسانیهای آینده برای کاهش نرخ خطای کلمه به زیر ۳٪ باشید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو