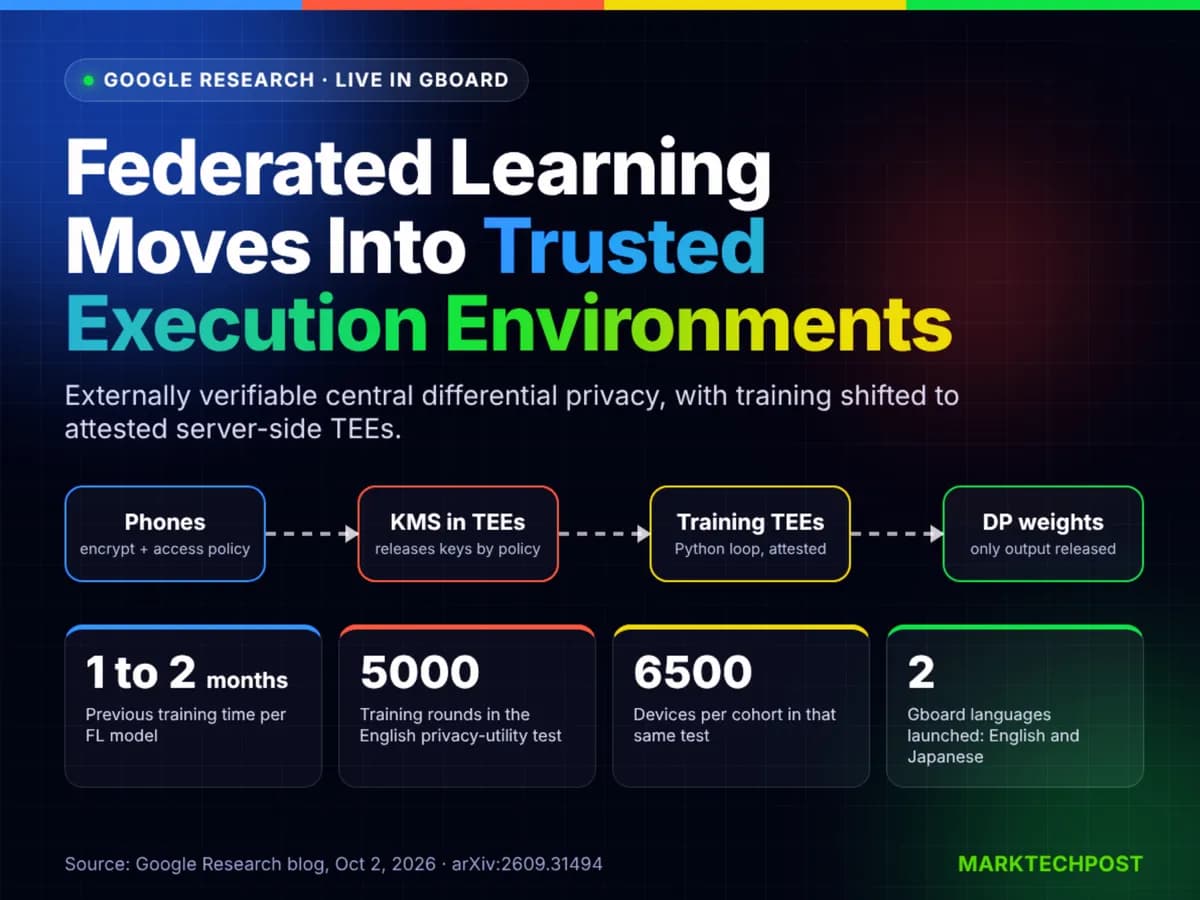
تصور کنید سیستمی از هوش مصنوعی توزیعشده داشته باشیم که در آن حریم خصوصی دیگر وابسته به اعتماد کورکورانه به اپراتور نباشد. گوگل ریسرچ (Google Research) با استقرار نسل جدیدی از سامانه یادگیری فدرال (Federated Learning - FL) به این هدف دست یافته است تا برای نخستین بار، تضمینهای حریم خصوصی تفاضلی (Differential Privacy - DP) مرکزی را بهصورت خارجی قابلراستیآزمایی کند.
گوگل سالهاست از یادگیری فدرال برای قابلیتهایی نظیر Smart Compose و پیشبینی کلمه در Gboard، پیشنهادهای پاسخ در Google Messages و انتخاب هوشمند متن در اندروید استفاده میکند. با این حال، یک شکاف اعتمادی همواره وجود داشت: در حالی که دستگاهها دادهها را برای تجمیع ارسال میکردند، ناظران خارجی نمیتوانستند بهطور مستقل تأیید کنند که این دادهها هرگز ثبت یا بازرسی نشدهاند. همانطور که در تحلیل قبلی ما دربارهی تلاشهای گوگل برای بهینهسازی دسترسی مدلها برای کاربران رایگان اشاره کردیم، این چرخش معماری اکنون آسیبپذیری بنیادی «سرور مورد اعتماد» را هدف قرار داده است.
شکاف اعتماد در سامانههای پیشین
نسخههای قبلی یادگیری فدرال برای ایجاد حفاظت رمزنگاریشده به «تجمیع امن» (Secure Aggregation) متکی بودند. اما طبق مستندات گوگل، این رویکرد با الگوریتمهای پیشرفتهی حریم خصوصی تفاضلی مرکزی، مانند matrix factorization DP-FTRL، سازگار نبود. علاوه بر این، کاربران مجبور بودند اعتماد کنند که گوگل نویزهای DP را بهدرستی به دادههای تجمیعشده اضافه میکند.
به نقل از پست گوگل ریسرچ در تاریخ ۲ اکتبر ۲۰۲۶، سامانه جدید محاسبات گرادیان کلاینت را از دستگاه موبایل به سرور منتقل میکند. برای جلوگیری از دسترسی اپراتور سرور به دادههای خام، این منطق در محیطهای اجرای مورد اعتماد (Trusted Execution Environments - TEE) میزبانی میشود؛ بخشهای امنی از پردازنده که کد و دادهها را از بقیه سیستم ایزوله میکنند. این ساختار باعث میشود منطق سرور «گواهیپذیر» (Attestable) باشد و نیاز به اعتماد به اپراتور حذف شود.
خط لوله فنی و سازوکار اجرا
این سامانه بر پایه کارهای پیشین گوگل در زمینه تحلیلهای فدرال محرمانه بنا شده و چهار مؤلفه اصلی را برای تضمین حریم خصوصی سرتاسری هماهنگ میکند:
- بارگذاری دادهها: دستگاهها نمونههای آموزشی را بهصورت محلی رمزگذاری کرده و یک سیاست دسترسی (Access Policy) به آن میچسبانند. این سیاست دقیقاً مشخص میکند کدام محاسبات TEE مجاز به پردازش دادهها هستند. دستگاهها پیش از بارگذاری، تأیید میکنند که این سیاست در Rekor (یک دفتر ثبت شفافیت عمومی توسط Sigstore) منتشر شده باشد.
- مدیریت کلید و تأیید سیاست: یک سامانه مدیریت کلید (KMS) که از TEEهای در حال اجرای پروتکل اجماع RAFT ساخته شده، کلیدهای رمزگشایی را تنها به بارهای کاری (Workloads) میدهد که با سیاست منتشرشده مطابقت داشته باشند. KMS گواهی از راه دور TEE را با لاگهای Rekor تطبیق میدهد.
- اجرای بار کاری: یک TEE ریشه، حلقه آموزش پایتون را اجرا کرده و زیروظایف را به TEEهای کارگر تفویض میکند. ارکستراسیون این فرآیند از یک زبان فدرال (Federated Language) تخصصی مشتقشده از TensorFlow Federated استفاده میکند و در نهایت تنها وزنهای مدل DP برای تحلیلگر آزاد میشود.
- تحمل خطا: برای پایداری، سامانه یک وضعیت بازیابی رمزگذاریشده توسط KMS برای هر دور ذخیره میکند تا در صورت شکست TEE ریشه یا کارگر، پیشرفت آموزش از دست نرود.
قابلیت راستیآزمایی و متنباز بودن
اکنون بازرسان خارجی میتوانند با بررسی لاگهای Rekor، هر بار کاری در سرور را که دستگاهها به آن تغذیه میکنند، ردیابی کنند. از آنجا که باینریهای KMS و پردازش دادهها از کدهای متنباز بهصورت بازتولیدپذیر (Reproducible) ساخته میشوند، منطق مربوط به حریم خصوصی بهصورت سختافزاری کدگذاری شده و قابل گواهی است.
گوگل برای محافظت از معماریهای اختصاصی مدلهایش، امکان بارگذاری منطق سریالشده در زمان اجرا (Sideloading) را فراهم کرده است. با این حال، تمام کدهای حیاتی حریم خصوصی باید در برنامه گواهیشده سختافزاری باقی بمانند. این امر تضمین میکند که اپراتورها تنها متریکها و وزنهای مدل DP را ببینند و دادههای رمزگذاریشده تنها برای مدت محدودی پس از بارگذاری قابل رمزگشایی باشند.
تأثیر بر عملکرد Gboard
گوگل پیش از این از این سامانه برای عرضه مدلهای پیشبینی کلمه در زبانهای انگلیسی و ژاپنی استفاده کرده است. این انتقال دو دستاورد اصلی داشت. نخست، با جمعآوری تمام بارگذاریها پیش از اجرای آموزش در سرور، گوگل تأخیرهای ناشی از نوسانات شبانهروزی در دسترس بودن دستگاهها را حذف کرد.
این تغییر اجازه داد تا برنامه یک زمانبندی بهینه برای مشارکت کاربران محاسبه کرده و پارامترهای DP را تنظیم کند. برای اعتبارسنجی این موضوع، گوگل منحنیهای «حریم خصوصی-سودمندی» را از طریق آموزش یک مدل انگلیسی در ۵۰۰۰ دور با گروههای ۶۵۰۰ دستگاه در هر دو سامانه قدیم و جدید استخراج کرد.
دوم، گلوگاه آموزش از دستگاه به سرور منتقل شد. در حالی که مدلهای قبلی یادگیری فدرال برای هر بار آموزش به ۱ تا ۲ ماه زمان نیاز داشتند، رویکرد مبتنی بر TEE محاسبات را در چندین ماشین موازی میکند. اگرچه گوگل عدد دقیقی برای افزایش سرعت منتشر نکرد، اما گزارش داده است که زمان محاسبات بهطور قابلتوجهی کاهش یافته و تنها به منابع در دسترس TEE محدود است.
مقایسه با سایر چارچوبها
برخلاف ابزارهایی مانند pfl-research اپل که صرفاً برای شبیهسازی هستند، این سامانه در محیط عملیاتی (Production) فعال است. در مقایسه با NVIDIA FLARE یا Flower، این معماری بهطور منحصربهفردی حریم خصوصی تفاضلی مرکزی را با یک دفتر ثبت شفافیت عمومی برای کدهای سرور و ساختهای بازتولیدپذیر TEE ترکیب میکند. این رویکرد در حالی اهمیت مییابد که بحثهای گستردهای پیرامون منشأ دادههای آموزشی در مدلهای پیشرو جریان دارد؛ برای مثال، بررسیهای اخیر درباره ردپای دادههای OpenAI در مدل Qwen نشان میدهد که شفافیت در منبع دادهها چقدر برای جامعه علمی حیاتی است.
این چرخش، فرض بنیادی یادگیری فدرال را از «اعتماد به ارائهدهنده» به «راستیآزمایی کد» تغییر میدهد. گوگل با انتقال محاسبات سنگین به سرور و حفظ ایزولاسیون رمزنگاریشده، حریم خصوصی را از محدودیتهای محاسباتی دستگاه جدا کرد.
توسعهدهندگانی که به پیادهسازی این سیستم علاقهمند هستند، میتوانند به باینریهای هسته TEE و زبان فدرال دسترسی یابند که هر دو تحت لایسنس Apache 2.0 متنباز شدهاند.
گام بعدی شما
- بررسی مستندات زبان فدرال گوگل برای درک نحوه جداسازی منطق آموزش از دادههای حساس.
- مطالعه لاگهای Rekor برای درک نحوه پیادهسازی شفافیت در سیستمهای توزیعشده.
- ارزیابی جایگزینی TEE با روشهای سنتی تجمیع امن در پروژههای یادگیری توزیعشده.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و نقش آنها در ایزولاسیون دادهها مراجعه کنید.



گفتگو