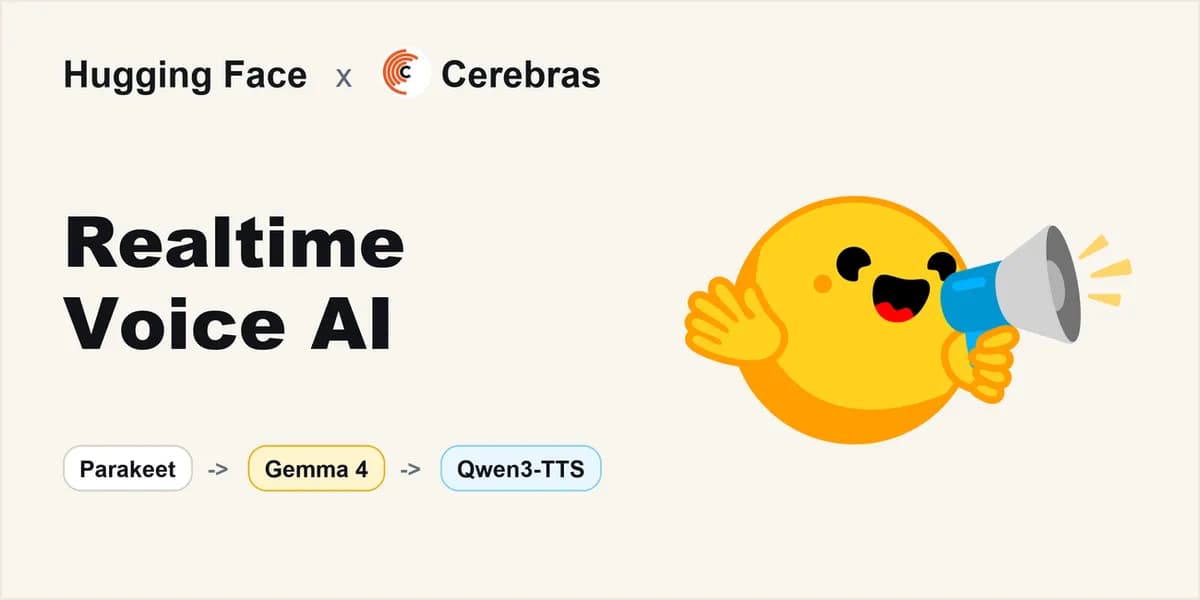
تصور کنید در حال گفتگو با یک هوش مصنوعی هستید، اما هر پاسخ با یک سکوت آزاردهنده چندثانیهای شروع میشود؛ همین شکاف است که رباتها را از انسان جدا میکند. در ۱ ژوئیه ۲۰۲۶، شرکتهای هگینگ فیس (Hugging Face) و سربرس (Cerebras) یک خط لوله صوتی-به-صوتی (Speech-to-Speech) را معرفی کردند که هدفش حذف کامل این تأخیرهاست تا تعاملات زنده و واقعی به نظر برسند.
همانطور که در تحلیل قبلی ما دربارهی چرخش هگینگ فیس بهسمت مدلهای جهانی و رفتارهای عاملمحور اشاره کردیم، این پروژه تمرکز را از استدلال محض به اجرای بلادرنگ منتقل کرده است. در دنیای صوت، پاسخی که ۳ ثانیه طول بکشد یک شکست محسوب میشود؛ بنابراین در این معماری، تأخیر (Latency) — شبیه به تپق زدن یا مکثهای طولانی در یک مکالمه تلفنی — دیگر یک اثر جانبی نیست، بلکه گلوگاه اصلی است که باید برطرف شود. این رویکرد در راستای تلاشهای گستردهتر برای بهینهسازی فرآیندهای صوتی است، مشابه آنچه در بررسی مسیرهای جدید کاهش هزینه تولید صوت مشاهده کردیم که بر جایگزینی مدلهای زبانی سنگین با متدهای پردازش سیگنال تأکید داشت.
طبق مستندات هگینگ فیس، این سیستم از یک معماری باز و لایهبندی شده استفاده میکند که هر بخش آن قابل جایگزینی است. این چرخه صوتی به ترتیب زیر عمل میکند:
- ورودی صوتی: دریافت لحظهای صدا.
- بازشناسی گفتار (Speech Recognition): پردازش توسط مدل Parakeet متعلق به انویدیا (Nvidia).
- استنتاج (Inference) — درست مثل لحظهای که یک آشپز بعد از خواندن دستور، غذا را میپزد — توسط مدل Gemma 4 31B گوگل دیپمایند روی سختافزار سربرس انجام میشود.
- تبدیل متن به گفتار (TTS): خروجی نهایی توسط مدل Qwen3TTS شرکت علیبابا (Alibaba) ارائه میشود.
به گزارش تیم فنی، سربرس بهطور خاص روی «دمِ بلند» تأخیر تمرکز کرده است؛ یعنی همان تأخیرهای شدید در ۵ درصد موارد (P95) که باعث میشود سیستم حتی با میانگین سرعت خوب، غیرقابل اعتماد به نظر برسد. با تثبیت سرعت استنتاج، مدل زبانی دیگر مانع سرعت سایر بخشهای خط لوله نمیشود.
این معماری اکنون در دنیای فیزیکی پیاده شده و قلب تپنده رباتهای Reachy Mini است که بیش از ۹۰۰۰ واحد از آنها فعال هستند. برای هوش مصنوعی تجسمیافته (Embodied AI)، این سطح از پاسخدهی، مرز بین یک ابزار ساده و یک موجود اجتماعی باورپذیر است.
این تحول ثابت میکند که آیندهی مکالمات هوش مصنوعی به همان اندازه که به اندازه مدل وابسته است، به طراحی مشترک سختافزار و نرمافزار بستگی دارد. توسعهدهندگان با ترکیب وزنهای باز (Open Weights) — یعنی دسترسی به دستور پخت مدل بهجای فقط غذای آماده — و تراشههای تخصصی، میتوانند سقف تأخیرهای رایانش ابری عمومی را بشکنند.
گام بعدی شما
- مخزن
huggingface/speech-to-speechرا بررسی کنید تا با نحوه اتصال مدلهای مختلف صوتی آشنا شوید. - اگر روی رباتیک کار میکنید، روی کاهش تأخیر P95 بهجای میانگین سرعت تمرکز کنید.
- ترکیب مدلهای کوچکتر (SLM) با سختافزار تخصصی را برای کاربردهای بلادرنگ تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو