تصور کنید یک برنامهنویس جاوا بخواهد قابلیت جستوجوی تصاویر مشابه را به فروشگاه آنلاینش اضافه کند، اما مجبور باشد برای این کار یک زیرساخت مجزا از پایتون برپا کند. این وابستگی آزاردهنده اکنون به پایان رسیده است.
پروژهی ImageSearch4J که در ۴ اکتبر ۲۰۲۶ منتشر شد، ثابت کرد که یک خط لولهی کامل تبدیل تصویر به بردار معنایی (Embedding) — شبیه به یک کارت معرفی عددی برای هر واژه یا تصویر که میگوید این مورد «همسایهی» چه موارد دیگری است — میتواند بهطور کامل در یک پردازش واحد جاوا اجرا شود.
سالهاست که در صنعت یک قانون نانوشته وجود دارد: آموزش مدل در پایتون رخ میدهد و استقرار آن نیز اغلب به پایتون نیاز دارد. این وضعیت باعث ایجاد «اصطکاک در زنجیره ابزار» (Toolchain Friction) میشود؛ جایی که بکاندهای جاوا باید از طریق HTTP یا gRPC با سرویسهای یادگیری ماشین ارتباط برقرار کنند. این مدل، خط لولهی استقرار را دو برابر کرده و عیبیابی را پیچیده میکند. تصور کنید یک جستوجوی ساده در کاتالوگ محصولات، برای یافتن یک عکس مشابه، به دو پشته تکنولوژی متفاوت و دو مجموعه سیستم مانیتورینگ نیاز داشته باشد. وقتی در محیط تولید مشکلی پیش میآید، تیم جاوا و تیم ML باید با هم عیبیابی کنند؛ صرفاً فهمیدن اینکه مشکل در کدام سمت است میتواند نیمی از روز را ببلعد. این پیچیدگی فقط بهصورت خطی افزایش نمییابد، بلکه چندین برابر میشود.
ImageSearch4J این الگو را میشکند و با هوش مصنوعی نه بهعنوان یک سرویس، بلکه بهعنوان یک کتابخانه برخورد میکند. این رویکرد، سربار سریالسازی بینزبانی و بار عملیاتی نگهداری یک پایگاهداده برداری مجزا را حذف میکند. طبق مستندات این پروژه در dev.to، هدف این است که قابلیتهای AI مانند هر لایهی سرویس دیگر در یک اپلیکیشن Spring Boot، یکپارچه شوند. این تلاش برای بومیسازی ابزارهای هوش مصنوعی در اکوسیستم جاوا، مشابه رویکردی است که پروژه Solon AI برای پیادهسازی خط لولههای RAG بدون وابستگی به پایتون در پیش گرفته است. نتیجه سیستمی است که از ورودی تصویر تا خروجی نتایج، در یک فایل JAR و یک پردازش واحد گنجانده شده است؛ بدون پایتون، بدون RPC و بدون نیاز به زنده نگه داشتن یک پایگاهداده برداری مجزا.
معماری سه ستونی
برای دستیابی به این خط لولهی خالص، پروژه سه فناوری کلیدی را ترکیب کرده است تا آموزش، مدل و زیرساخت را از هم تفکیک کند. این معماری تضمین میکند که آموزش از استقرار، مدل از موتور اجرا، و قابلیت AI از زیرساخت جدا باشد:
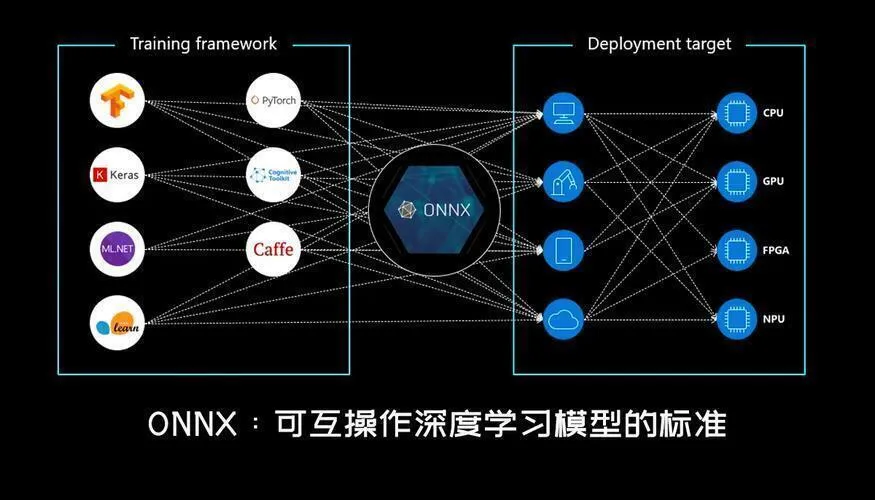
- ONNX (Open Neural Network Exchange): این پروژه از ONNX بهعنوان یک «قرارداد» استفاده میکند. ONNX یک پروژه تحت بنیاد لینوکس است که یک گراف محاسباتی را بدون وابستگی به چارچوب خاصی تعریف میکند. مدلها در چارچوبهایی مثل PyTorch یا PaddlePaddle آموزش دیده و به فرمت ONNX صادر میشوند. به این ترتیب، بخش جاوا فقط استاندارد ONNX را میفهمد و تیم آموزش میتواند بدون تغییر یک خط کد جاوا، چارچوب آموزشی را عوض کند. این پروژه بهطور خاص از مدلهای PicoDet-LCNet و PP-LCNetV2 از خانواده PP-ShiTu استفاده میکند که در سمت Paddle آموزش دیده و به ONNX تبدیل شدهاند. از آنجایی که مشخصات ONNX سازگاری عقبرو (Backward Compatibility) را تضمین میکند، رانتایمهای جدیدتر میتوانند مدلهای قدیمیتر را اجرا کنند که برای نگهداری بلندمدت حیاتی است.
DJL (Deep Java Library): این کتابخانه که توسط AWS توسعه یافته و در سال ۲۰۱۹ در کنفرانس re:Invent معرفی شد، یک API مستقل از موتور برای جاوا فراهم میکند. DJL اجازه میدهد استنتاج (Inference) — یعنی لحظهای که مدل واقعاً جواب تولید میکند — با استفاده از ONNX Runtime انجام شود بدون اینکه برنامهنویس نیاز به نوشتن لایهی استنتاج سفارشی داشته باشد. DJL Serving مسیر رسمی استقرار در SageMaker است که از قابلیتهایی چون دستهبندی پویا (Dynamic Batching)، مقیاسپذیری خودکار و میزبانی چند-موتوره پشتیبانی میکند. این پروژه از نسخه ۰.۳۸.۰ استفاده میکند که حفرههای امنیتی نسخههای ۰.۱۳.۰ تا ۰.۳۶.۰ را (که در نسخه ۰.۳۷.۰ رفع شده بود) برطرف کرده است.
Apache Lucene: بهجای استفاده از پایگاهدادههای برداری مستقل مثل Milvus, Qdrant یا KNN در Elasticsearch، پروژه از Lucene 9.12 استفاده میکند. چون Lucene یک فایل JAR است، در همان پردازش برنامه اجرا میشود و تأخیر شبکه و نیاز به داشبورد یا نقاط شکست مجزا را حذف میکند. این سیستم از ایندکسهای برداری HNSW (موجود از نسخه ۹.۰) و کوانتش اسکالر (Scalar Quantization) برای فشردهسازی بردارهای float32 به int8 استفاده میکند. این کار حافظه ایندکس را به حدود ۲۵٪ کاهش داده اما دقت بازیابی (Recall) را بالای ۹۵٪ نگه میدارد. علاوه بر این، Lucene اجازه میدهد یک سند واحد هم دارای فیلد برداری و هم فیلد متنی معکوس باشد؛ این زیربنایی برای جستوجوی ترکیبی (Hybrid Search) فراهم میکند که با استفاده از
BooleanQueryنتایج KNN و زیر-پرسوجوهای متنی را با هم ادغام میکند.
حل باگ «دربرگیری» با SANMS
یکی از مهمترین دستاوردهای فنی این پروژه، معرفی SANMS (حذف غیربیشینه آگاه از ساختار) است. در سیستمهای NMS سنتی، همپوشانی جعبهها مدیریت میشود اما وقتی یک جعبه کاملاً درون جعبهای دیگر قرار دارد (مثلاً یک برچسب کوچک روی یک بطری بزرگ)، سیستم شکست میخورد.
در سیستمهای استاندارد، برچسب کوچک اغلب امتیاز اطمینان بالاتری (مثلاً ۰.۹۵) نسبت به کل بطری (مثلاً ۰.۶۰) دارد. چون منطق پاییندستی بر اساس امتیاز مرتب میشود، سیستم بهجای کل محصول، برچسب را جستوجو میکند. نویسنده چندین راهکار را امتحان کرد که همگی شکست خوردند:
- بالا بردن آستانه اطمینان: افزایش آستانه به بالای ۰.۶ باعث حذف جعبه برچسب شد، اما همزمان جعبه بطری (با امتیاز ۰.۶۰) را هم حذف کرد و نتیجه صفر شد.
- تنظیم آستانههای IoU در NMS: این روش شکست خورد چون در موارد تودرتو، همپوشانی نسبت به اجتماع بسیار کوچک است (IoU میتواند به ۰.۰۱ برسد)، بنابراین هیچ آستانهای نمیتواند آنها را ادغام کند.
- نگه داشتن فقط بزرگترین جعبه: این کار ریسک انتخاب میز یا قفسه بهجای سوژه را داشت، زیرا جعبههای پسزمینه اغلب بزرگتر از سوژه هستند.
SANMS این مشکل را با تغییر معیار از «همپوشانی» به «دربرگیری هندسی» حل میکند:
۱. ترتیب مساحت نزولی: جعبهها از بزرگترین به کوچکترین مساحت پردازش میشوند تا ابتدا «کل» مدیریت شود.
۲. مقایسه مختصات: بهجای استفاده از IoU، مستقیماً مختصات بررسی میشود تا دربرگیری هندسی تشخیص داده شود.
۳. بهارثبری امتیاز: اگر یک جعبه بزرگ کاملاً یک جعبه کوچک را دربر بگیرد، جعبه کوچک حذف شده و امتیاز بالای آن به جعبه بزرگ منتقل میشود (بیشینه element-wise).
این بهبود هندسی خالص در پسپردازش، بدون هیچ پارامتر اضافی و بدون هزینه آموزش، باعث میشود سیستم بهجای یک بافت متمایز، خودِ سوژه اصلی عکس را جستوجو کند. این لایه روی NMS داخلی خانواده PP-ShiTu قرار میگیرد: NMS داخلی همپوشانی (حذف تکراریها) را مدیریت میکند و SANMS دربرگیری (ادغام) را.
بازیابی بدون نیاز به آموزش
این پروژه تفاوت مهمی بین طبقهبندی (Classification) و بازیابی (Retrieval) قائل میشود. در طبقهبندی، دانش در وزنهای مدل تثبیت شده و برای دستههای جدید باید مدل را دوباره آموزش داد. اما در بازیابی، مدل فقط یک تابع کلی «تصویر به بردار» است و دانش در گالری تصاویر ذخیره میشود.
| ویژگی | طبقهبندی (Classification) | بازیابی (Image Search) |
|---|---|---|
| محل ذخیره دانش | وزنهای مدل | گالری تصاویر |
| افزودن دسته جدید | آموزش مجدد (داده + محاسبات) | افزودن چند تصویر |
| نقش مدل | طبقهبند (Classifier) | تابع تصویر $\rightarrow$ بردار |
این یعنی برای افزودن یک محصول جدید، نیازی به مهندس ML، خوشههای GPU یا تنظیم تابع زیان (Loss Function) در مرحله استقرار نیست. بخش جاوا فقط استنتاج انجام میدهد که در مقایسه با آموزش توزیعشده، بسیار سبک است (فقط بارگذاری مدل و اجرای یک Forward Pass). به همین دلیل پروژه سبک میماند؛ عملیات «بهروزرسانی بردار» جایگزین چیزی میشود که در سیستمهای دیگر «آموزش مجدد» نامیده میشود.
پیادهسازی و API
سیستم بر پایه Spring Boot 3 ساخته شده و یک نقطه اتصال POST /api/search ارائه میدهد. این درخواست یک فایل، یک عدد صحیح topk (پیشفرض ۱۰) و یک عدد اعشاری threshold (پیشفرض ۰.۴) را میپذیرد.
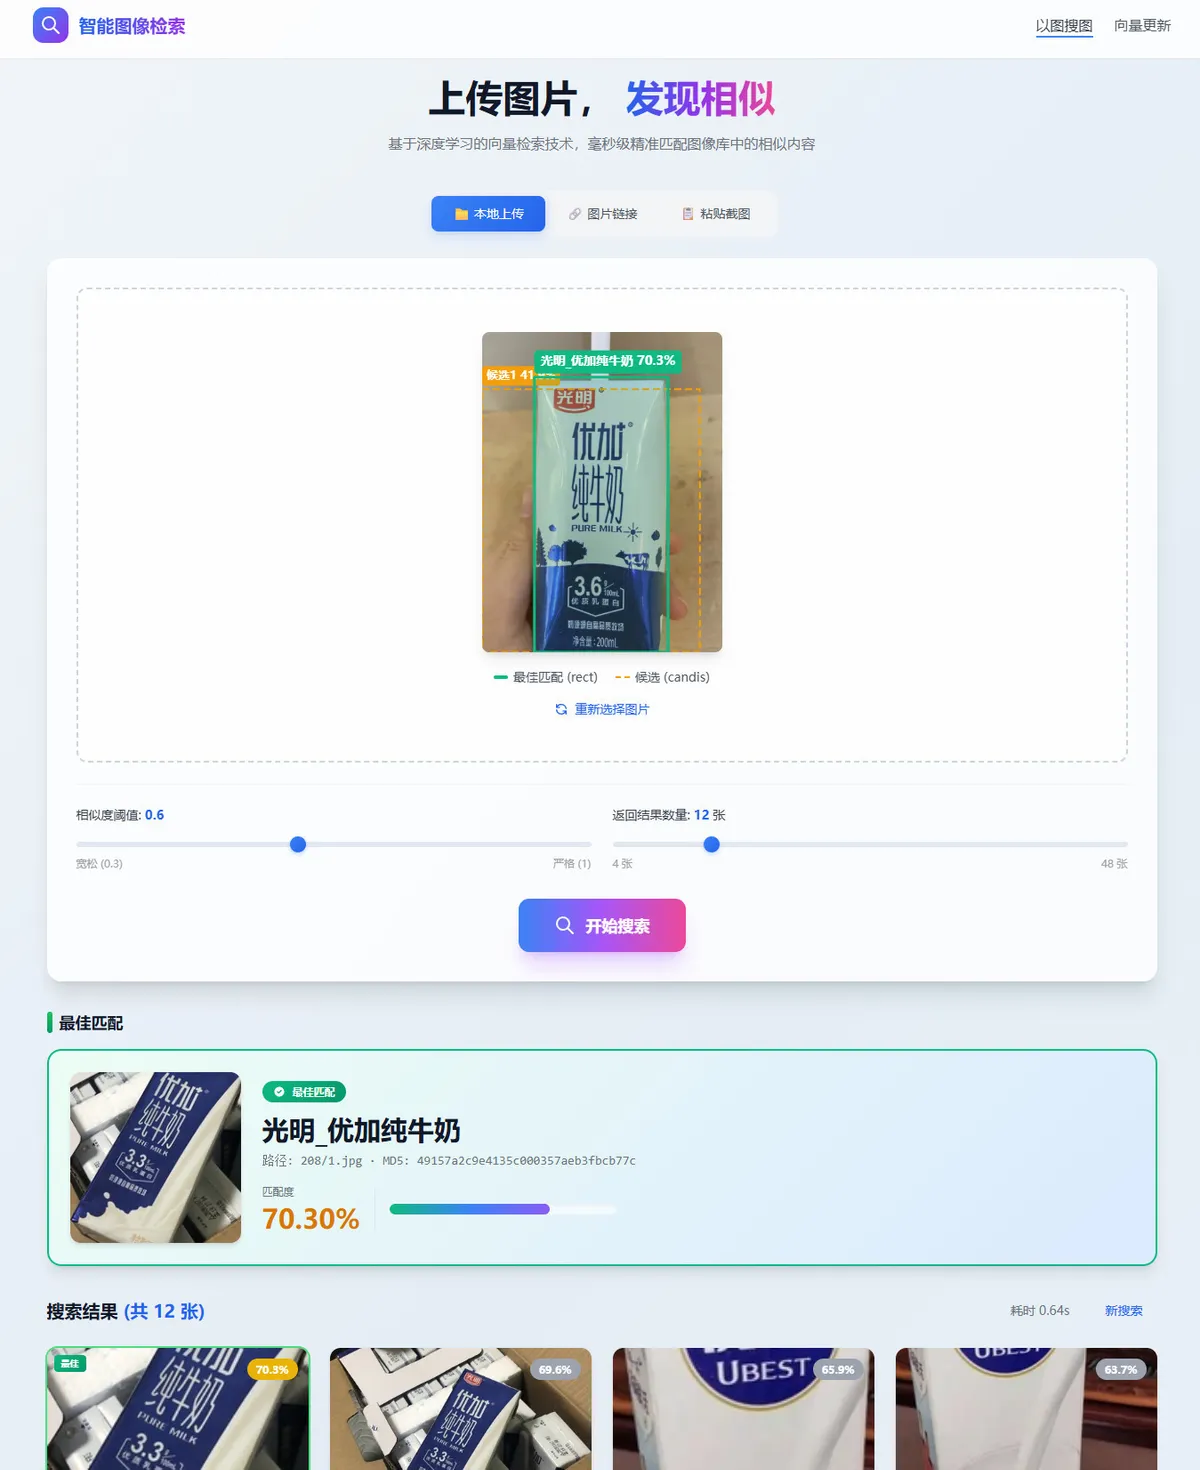
پاسخ سیستم شامل یک شیء match (بهترین نتیجه)، یک لیست similarList (نتایج رتبهبندی شده) و یک rect (محدوده سوژه در تصویر) است. این تفکیک به فرانتاند اجازه میدهد بین «محتملترین مورد در تصویر» و «موارد مشابه در گالری» تمایز قائل شود. حتی اگر تطبیق برداری پیدا نشود، rect و candis (جعبههای کاندید) بازگردانده میشوند تا UI نشان دهد که سوژهای شناسایی شده، هرچند در گالری موجود نیست.
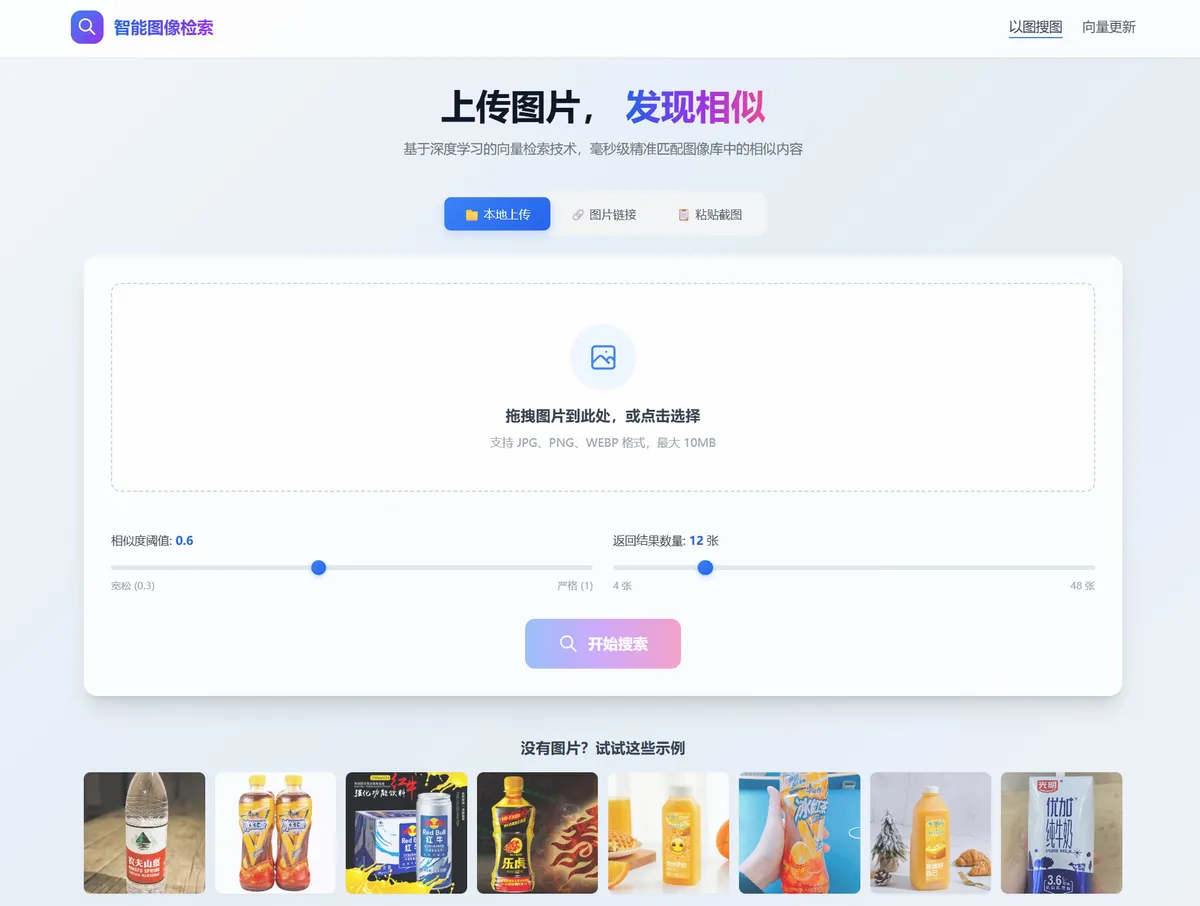
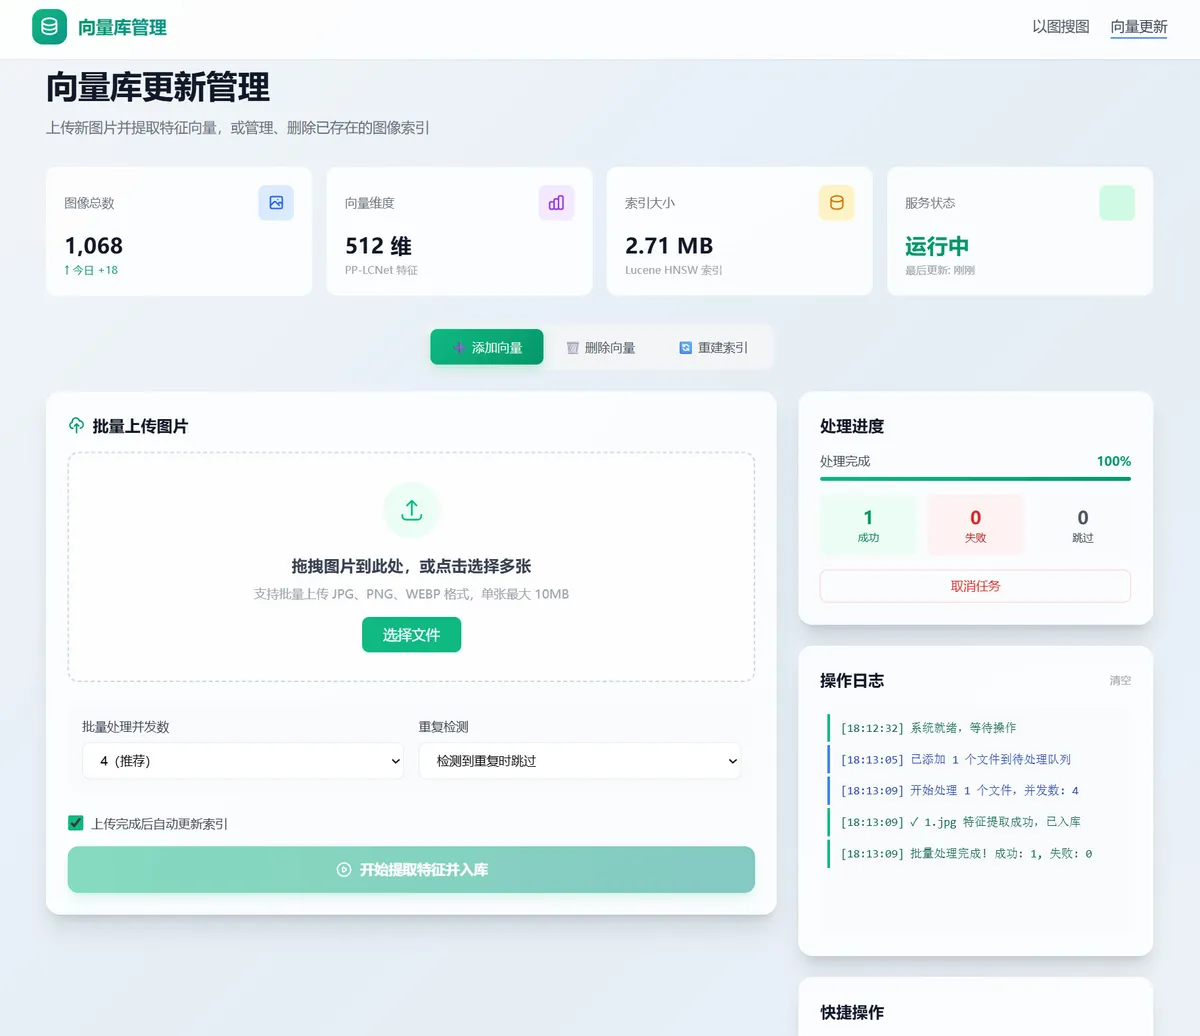
برای مدیریت، پروژه از دو صفحه استاتیک بدون فریمورک (HTML ساده و JS خام) استفاده میکند. یکی جستوجوها را از طریق آپلود محلی، URL یا اسکرینشات مدیریت میکند و دیگری صفحهای برای بهروزرسانیهای افزایشی بردار، آپلودهای دستهجمعی و مشاهده لاگها است. نویسنده تعمداً این صفحات را سبک نگه داشت تا سد ورود را پایین بیاورد و از پیچیدگیهای فریمورکهای مدرن فرانتاند دوری کند.
توازن عملیاتی و راهاندازی
اگرچه رویکرد جاسازیشده (Embedded) در سادگی و تأخیر برنده است، اما جایگزین جهانی نیست. اگر شرکتی از قبل خوشه عظیم Elasticsearch دارد، استفاده از قابلیتهای برداری داخلی ES 8.x احتمالاً بهینهتر است. ImageSearch4J برای کسانی است که یک پایه سبک و مستقل بدون سربار عملیاتی دیتابیسهای توزیعشده میخواهند.
برای شروع، توسعهدهندگان به Zulu JDK 17 و Maven 3.8 نیاز دارند. روند کار شامل مراحل زیر است:
۱. آمادهسازی گالری: قرار دادن مجموعه داده (مانند drink_dataset_v2.0) در مسیر ~/image_gallery/. برنامه در هنگام شروع این مسیر را بررسی کرده و در صورت نبود، لینک دانلود را ارائه میدهد. گالری به فایلی به نام drink_label_all.txt نیاز دارد که در هر خط، یک تصویر را با نام دسته (با جداکننده Tab) متصل میکند.
۲. اجرا: اجرای دستور mvn spring-boot:run. در اولین اجرا، برنامه بهطور خودکار مدلهای ONNX bundled (شامل picodet_lcnet_x2_5_640_mainbody.onnx و general_PPLCNetV2.onnx) را در مسیر ~/models/ استقرار داده و ایندکس برداری را میسازد.
۳. ایندکسگذاری: سیستم از رفرش NRT (Near-Real-Time) استفاده میکند؛ دیدهشدن دادهها هر ثانیه و Commitها هر پنج دقیقه رفرش میشوند، به این معنی که تصاویر جدید بدون نیاز به ریاستارت، قابل جستوجو میشوند.
یک نکته فنی مهم، تنظیم ty.onnx-engine-path است. بهطور پیشفرض، ONNX Runtime کتابخانههای Native را در یک پوشه موقت استخراج میکند که بهدلیل محدودیتهای File.deleteOnExit باعث انباشت فایلهای زائد میشود. تنظیم این مسیر به یک پوشه ثابت (مثلاً ${user.home}/.djl.ai/onnx/linux-x64) از استخراج مکرر جلوگیری میکند. کاربران میتوانند برای بهینهسازی عملکرد در محیط تولید، این کتابخانهها را دستی از onnxruntime-1.29.0.jar در مخزن .m2 استخراج کنند (برای لینوکس x64، استخراج محتویات ai/onnxruntime/native/linux-x64/* به مسیر هدف).
این تغییر در رویکرد نشان میدهد که بازتاب «فقط پایتون» برای هوش مصنوعی در حال تبدیل شدن به یک محدودیت قدیمی است. با انتقال AI به لایههای بنیادی اپلیکیشن، توسعهدهندگان میتوانند بهجای لولهکشی زیرساخت، روی منطق کسبوکار تمرکز کنند. همانطور که نویسنده اشاره میکند، حالت ایدهآل برای AI جایی است که توسعهدهنده اپلیکیشن اصلاً متوجه حضور آن نشود؛ جایی که بارگذاری مدل و رفرش ایندکس در لایه Service پنهان شده و کد کسبوکار فقط یک فراخوانی متد ساده باشد.
گام بعدی شما
- اگر از Spring Boot استفاده میکنید، کتابخانه DJL را برای اجرای مدلهای ONNX بدون نیاز به پایتون بررسی کنید.
- برای کاهش مصرف حافظه در جستوجوی برداری، متد کوانتش (Quantization) را در Lucene 9 پیادهسازی کنید.
- در پروژههای تشخیص اشیا، الگوریتم SANMS را برای حل مشکل جعبههای تودرتو جایگزین NMS معمولی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو