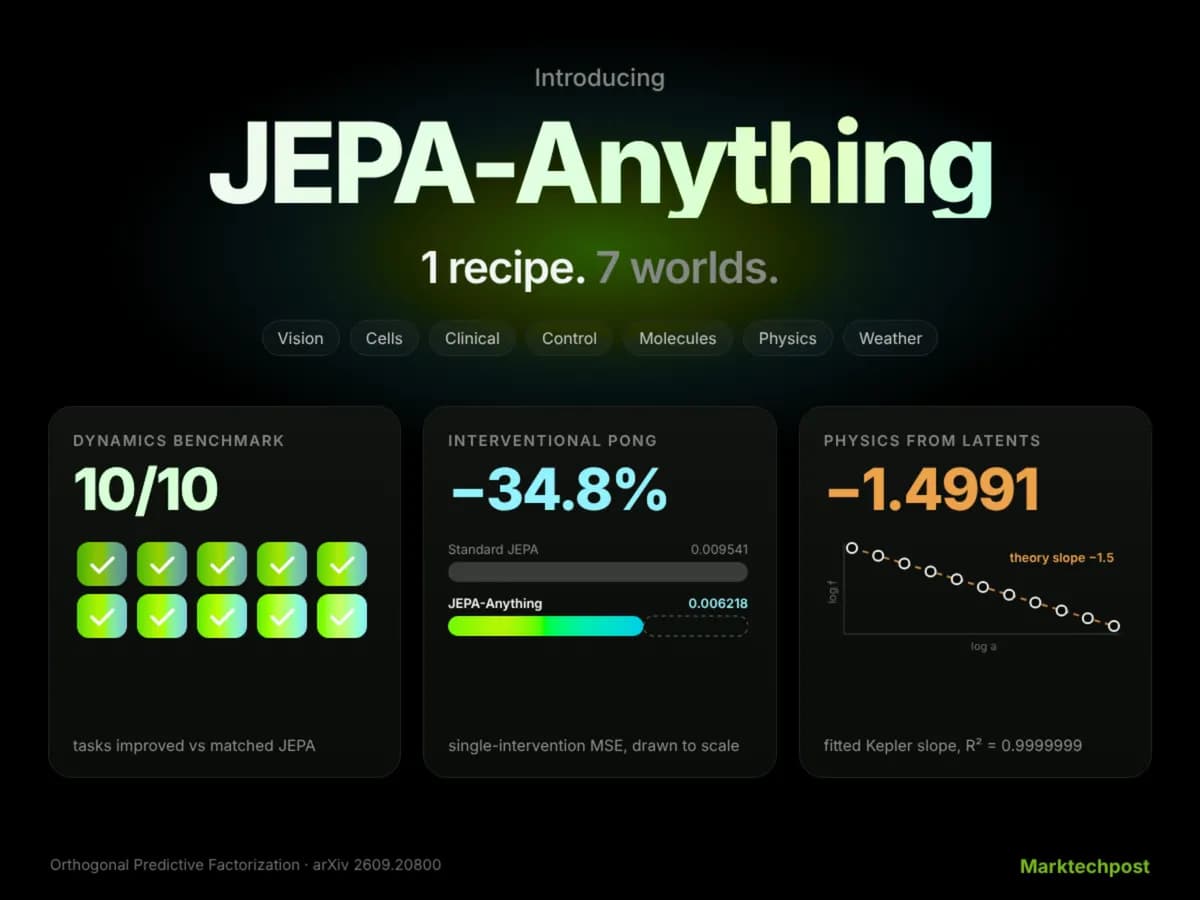
یک دستورالعمل یادگیری واحد اکنون میتواند مدلهای جهانی (World Models) را برای هفت دامنه علمی کاملاً متفاوت بسازد. در ۶ اکتبر ۲۰۲۶، پژوهشگران PhAI Labs و چندین دانشگاه برجسته از جمله CUHK، فودان، استنفورد، آکسفورد و پرینستون، چارچوب JEPA-Anything را معرفی کردند. این چارچوب هدف آن حذف نیاز به طراحی مدلهای پیشبین اختصاصی برای هر حوزه پژوهشی جدید است.
بسیاری از مدلهای جهانی فعلی از مشکلی به نام «تخصیص ظرفیت» رنج میبرند. در معماریهای پیشبین تعبیه مشترک (Joint-Embedding Predictive Architectures یا JEPA)، مانند I-JEPA یا V-JEPA 2، معمولاً از یک رمزگذار زمینه (Context Encoder)، یک رمزگذار هدف EMA و یک پیشبین (Predictor) استفاده میشود. طبق مستندات این پژوهش، یک تعبیه هدف یکپارچه و یکپارچه (Monolithic) باعث میشود ساختارهای با واریانس (Variance) بالا بر دادهها غالب شوند و حالتهای ضعیفتر اما حیاتی را سرکوب کنند. این امر منجر به ایجاد گرادیانهای متضاد شده و توانایی مدل برای یادگیری سیستمهای پیچیده و چندوجهی را مختل میکند.
برای حل این مشکل، JEPA-Anything مکانیزم «تجزیه پیشبین متعامد» (Orthogonal Predictive Factorization یا OPF) را معرفی میکند. در این روش، بهجای یک هدف واحد، هدف نهان با عرض d به K زیرفضای یادگرفتهشده با عرض r تقسیم میشود (به طوری که d = K × r). در اکثر آزمایشها، مقدار K=4 در نظر گرفته شده است. هر فاکتور پیشبین اختصاصی خود را دارد و در نهایت، نتایج با استفاده از شبهمعکوس مور-پنروز (Moore-Penrose pseudoinverse) از ماتریس پروژکتور ترکیب میشوند تا یک حالت نهان کامل برای رمزگشایی، برنامهریزی یا پیشبینی (Rollout) ایجاد شود. این رویکرد ترکیب نتایج از زیرفضاهای مختلف، یادآور استراتژیهای پیشرفتهتر در مدلهای ترکیبی است که در آن مدلهای ثانویه برای خنثیسازی خطاهای مدلهای پایه در ساختارهای Stacking به کار میروند تا دقت نهایی افزایش یابد.
به نقل از گزارش تیم توسعه، برای اطمینان از متمایز بودن و مفید بودن این فاکتورها، سه منظمساز (Regularizer) خاص به تابع زیان (Loss Function) اصلی هر دامنه اضافه شده است:
- زیان متعامد (Orthogonality loss): ستونهای هر پروژکتور را ارتونرمال نگه میدارد و تضمین میکند که پروژکتورهای مختلف زیرفضاهای غیرهمپوشان را اشغال کنند.
- زیان فعالیت فاکتور (Factor-activity loss): یک لولای (Hinge) روی انحراف معیار هر مختصه است تا هیچ فاکتوری «مرده» یا غیرفعال نشود.
- زیان واریانس رمزگذار (Encoder-variance loss): یک سیگنال ضد-فروپاشی (Anti-collapse) مستقیم به رمزگذار آنلاین ارسال میکند.
آداپتورهای دامنه، توکنبندی و رمزگذارها را مدیریت میکنند، در حالی که کتابخانه اصلی، هسته مشترک را تحت عنوان OrthogonalFactorProjection ارائه میدهد. این متعامد بودن برای سنتز پایدار حیاتی است. در محیط CITRIS Interventional Pong، یک مدل چندسره بدون محدودیت با ظرفیت مشابه، عدد شرط (Condition number) ۴۳۸.۵۲ داشت؛ در حالی که نسخه متعامد به ۱.۰۰۰۰۵ رسید و همپوشانی بین فاکتورها تقریباً صفر بود.
این چارچوب در حوزههای بینایی، زیستشناسی، مسیرهای بالینی، کنترل، دینامیک مولکولی، میدانهای فیزیکی و هواشناسی آزمایش شد. بر اساس گزارش Marktechpost، نتایج در محکهای معتبری چون CausalWorld، DeepMind Control، PDEBench و WeatherBench2 بسیار چشمگیر بود.
گروه اول: بازخوانی نهایی (Terminal Readout)
در کاربردهای زیستشناسی، خوشهبندی Zero-shot در دادههای PBMC (AvgBIO) به ۰.۷۷۵۲ رسید که از رکورد ۰.۷۱۹۴ مدل Cell-JEPA بیشتر است. همچنین مقدار پیرسون برای اختلالات نورمن (Norman perturbation) از ۰.۷۸۷ به ۰.۸۱۴ افزایش یافت. برای پیشبینیهای بالینی روی بیش از ۱,۰۰۰ رویداد در دادههای UK Biobank، میانگین PRAUC به ۰.۷۱۸ رسید، در حالی که برای مدل JEPA استاندارد مشابه، این مقدار ۰.۷۱۱ بود.
گروه دوم: دینامیکهای جهانی نهان
در محیط Interventional Pong، میانگین مربعات خطا (MSE) در مداخلات تکگانه ۳۴.۸۳٪ کاهش یافت، مداخلات ترکیبی دیدهنشده ۱۲.۹۰٪ بهبود یافت و پیشبینی ۶ مرحلهای (6-step free rollout) ۸.۵۸٪ ارتقا پیدا کرد. JEPA-Anything معیارهای تمام ۱۰ تکلیف دینامیک مشابه را بهبود بخشید. آزمایشهای بیشتر روی APEBench Burgers نشان داد که خطای پیشبینی ۶ مرحلهای در تمام Seedها ۴۴.۷٪ کاهش یافته است. در دینامیک مولکولی، با استفاده از یک ستون فقرات به سبک TrajCast برای پیشبینیهای ۱۰۰ مرحلهای، این مدل کمترین میزان MAE و RMSD را برای آب، کوارتز، پاراستامول و بنزن ثبت کرد.
گروه سوم: تحلیلهای علمی
تحلیل فاکتوری، مسدود کردن IL-18 به همراه CD73 را به عنوان یک مداخله سرطان پیشنهاد کرد که بعدها در آزمایشهای Wet-lab روی کشتهای مشترک، ارگانوئیدهای مشتق شده از بیمار، قطعات تومور و موشها تأیید شد. در فیزیک، حالتهای مداری نهان توانستند قانون کپلر را با شیب برازش شده -۱.۴۹۹۱ بازیابی کنند که تقریباً با مقدار تئوریک -۱.۵ مطابقت دارد.
با این حال، بهبودهای مربوط به برنامهریزی (Planning) به محیط وابسته بود. در حالی که با پارامترهای مشابه تا حد ۰.۳٪، JEPA-Anything بازده CEM را در محیطهای Walker2d و HalfCheetah بهبود بخشید، اما مدل JEPA استاندارد در محیط Hopper عملکرد بهتری داشت.
این تغییر رویکرد نشان میدهد که آینده مدلهای جهانی در «تجزیه ساختاری» است، نه صرفاً افزایش تعداد پارامترها. با اجبار مدل به تجزیه دنیا به فاکتورهای متعامد، پژوهشگران میتوانند سیگنالهای ظریفی را شکار کنند که پیش از این در میان الگوهای غالب دادهها گم میشدند.
برای جامعه فنی، این دستاورد معیار را از «تنظیم اختصاصی برای هر دامنه» به «دستورالعملهای معماری مشترک» تغییر میدهد و ثابت میکند که یک رویکرد ریاضی واحد برای فضای نهان میتواند در علوم سخت و رباتیک بهطور یکسان تعمیم یابد.
کتابخانه اصلی این پروژه تحت مجوز Apache-2.0 منتشر شده و نقاط بازرسی (Checkpoints) پژوهشی در Hugging Face برای اعتبارسنجی بیشتر در دسترس است.
گام بعدی شما
- بررسی مستندات
OrthogonalFactorProjectionدر کتابخانه منتشر شده برای پیادهسازی در دادههای تخصصی. - مقایسه نتایج مدلهای متعامد با مدلهای تکسره (Single-head) در محیطهای شبیهساز دینامیک.
- دنبال کردن نتایج آزمایشهای Wet-lab برای اعتبارسنجی پیشبینیهای مدل در حوزه بیومدیکال.
اما تأثیر این معماری بر کاهش هزینههای استنتاج در مقیاس صنعتی موضوع دیگری است — به تحلیل ما درباره بهینهسازی حافظه در مدلهای نهان مراجعه کنید.



گفتگو