تصور کنید یک هنرمند خانگی هستید که ساعتها وقت صرف دوخت لباس میکند، اما حالا باید همان مقدار زمان را برای نوشتن توضیحات محصول در شش پلتفرم مختلف تلف کنید. ListingLift این بنبست را با تبدیل یک فایل HTML ساده به یک ماشین تولید محتوا تبدیل کرده است که هیچ هزینهای برای کاربر ندارد. این ابزار به فروشندگان اجازه میدهد تا لیستهای حرفهای برای بازارهای آنلاین ایجاد کنند، در حالی که هزینه نهایی هر تولید (Marginal Cost) صفر است.
به نقل از مستندات پروژه، این ابزار که توسط آنیرودا آداک برای چالش Hacktoberfest ۲۰۲۶ توسعه یافته، تمام فرآیند استنتاج (Inference) — یعنی همان لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی و نه دورهی آموزش آشپز — را از ابر به سختافزار خود کاربر منتقل کرده است. با این کار، نیاز به APIهای ابری کاملاً حذف شده است. این یعنی فروشندگان میتوانند بدون نیاز به اینترنت و بدون پرداخت حتی یک ریال بابت توکن، توضیحات حرفهای برای Etsy، آمازون، eBay، Meesho، Shopify و اینستاگرام بسازند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، حذف واسطههای ابری، حریم خصوصی را به یک ویژگی ساختاری تبدیل میکند، نه یک وعده در متن قرارداد. ListingLift دقیقاً همین مسیر را طی کرده است تا دغدغه فروشندگانی مثل مادر توسعهدهنده — که پارچههای سنتی کانتا (Kantha-stitch dupattas) را در بنگال غربی از لایههای ساریهای قدیمی با دوختهای دستی میدوزد — را حل کند. برای این هنرمندان، مشکل اصلی تولید محصول نیست، بلکه توصیف تکراری آن در قالبهای سختگیرانه هر پلتفرم است. در حالی که پیشتر پوشش دادیم چگونه افزونههای کروم OpenAI کنترل تبهای مرورگر را برای اتوماسیون به دست گرفتند، ListingLift با حذف کامل ابر، مسیر متفاوتی را میرود و عکس محصول و یادداشتهای خام را به محتوای آماده برای کپی تبدیل میکند. این رویکرد یادآور ابزارهای مشابهی است که فرآیند تبدیل عکس محصول به لیستهای کامل فروشگاهی را خودکار کردهاند تا سرعت ورود کالا به بازار افزایش یابد.
موتور استنتاج محلی
این برنامه از WebLLM (نسخه ۰.۲.۸۶) و WebGPU استفاده میکند تا مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — را مستقیماً در حافظه موقت (Cache) مرورگر اجرا کند. در اولین اجرا، مدل (مثلاً Gemma 3 1B با حجم تقریباً ۷۰۰ مگابایت) از یک CDN عمومی دانلود میشود و پس از آن، برنامه کاملاً آفلاین کار میکند؛ به این معنا که یک فروشنده میتواند در حالت هواپیما و بدون هیچ اتصال دادهای، لیستهای خود را تولید کند.
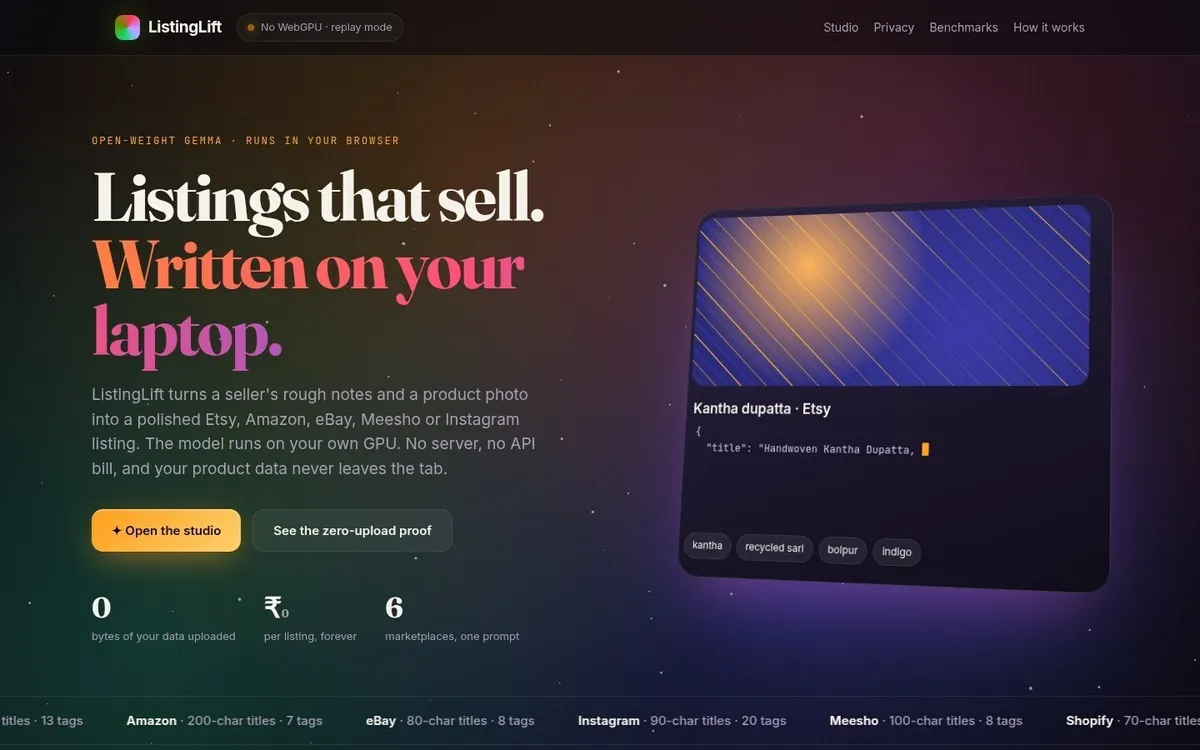
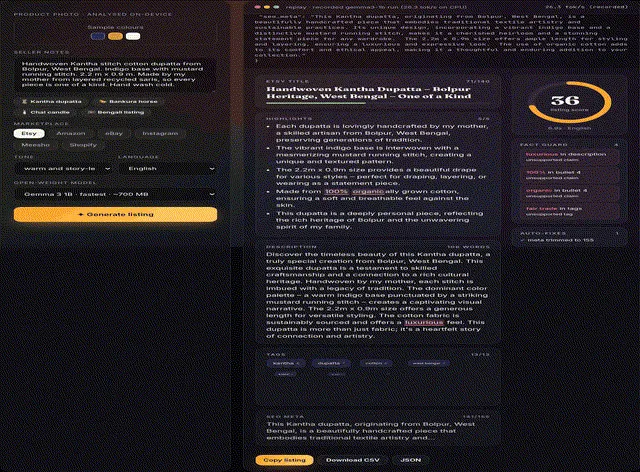
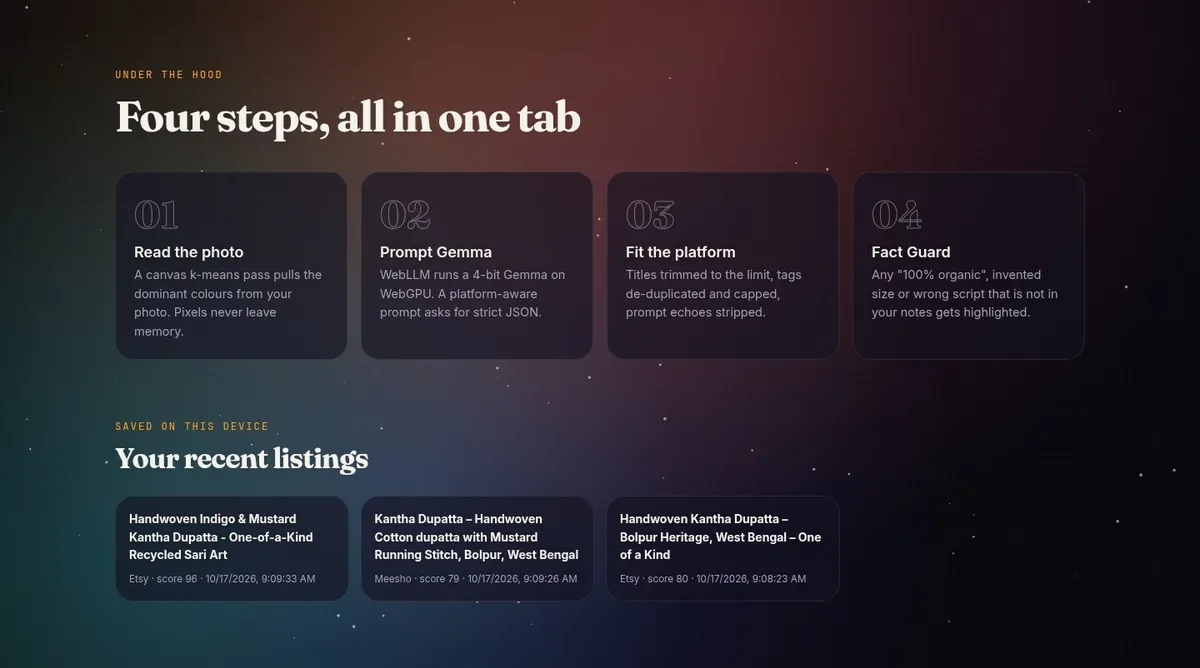
برای تحلیل بصری، برنامه یک پردازش سریع k-means روی یک بوم ۶۴×۶۴ انجام میدهد تا رنگهای غالب را از عکس محصول استخراج کند. این پیکسلها هرگز از حافظه دستگاه خارج نمیشوند. کاربر سپس یادداشتهای خام خود را وارد میکند — مواردی مثل اینکه کالا چیست، چه کسی آن را ساخته، اندازه، متریال و دستورات مراقبتی — و سپس پلتفرم، لحن و زبان مورد نظر را انتخاب میکند.
کاربران بسته به سختافزار خود و نیاز به کیفیت، میتوانند یکی از سه مدل زیر را انتخاب کنند:
- Gemma 3 1B IT (gemma3-1b-it-q4f16_1-MLC): سریعترین گزینه و پیشفرض برای اکثر کاربران با کمترین حجم دانلود.
- Gemma 2 2B IT (gemma-2-2b-it-q4f16_1-MLC): کندتر، اما در بنچمارکها ادعاهای ساختگی (Invented Claims) کمتری از خود نشان داده است.
- Gemma 4 E2B (gemma-4-E2B-it-q4f16_1-MLC): جدیدترین نسل که نیازمند دانلود حجم بیشتری از دادهها است.
جزئیات پیادهسازی فنی
ListingLift بهطور عمدی بسیار سبک طراحی شده است: یک فایل HTML واحد، بدون مرحله Build، بدون بکاند و بدون هیچ فریمورکی. تمام منطق برنامه از طریق View Source برای بازرسی کامل در دسترس است.
- بارگذاری مدل: برنامه از یک تابع ناهمگام (Asynchronous) به نام
getEngineبرای وارد کردن WebLLM ازesm.runاستفاده میکند. پیشرفت این فرآیند از طریق یک Callback رصد شده و در نوار وضعیت و برچسب UI نمایش داده میشود. - منطق استریم: برنامه از یک API سازگار با OpenAI که توسط WebLLM ارائه شده استفاده میکند. دمای مدل (Temperature) روی ۰.۶ و محدودیت
max_tokensروی ۹۰۰ تنظیم شده است. خروجی را توکن به توکن (Token) — یعنی تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — به رابط کاربری میفرستد تا حس زنده بودن ایجاد شود. - مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن برای گرفتن بهترین جواب — در این ابزار بهگونهای است که تابع
buildPromptقوانین خاص هر پلتفرم را تزریق میکند. این تابع صراحتاً به مدل دستور میدهد: «فقط از حقایق موجود در یادداشتهای فروشنده استفاده کن. هرگز متریال، درصدها، گواهینامهها یا اندازهها را اختراع نکن.» همچنین خروجی را در قالب یک JSON سختگیرانه با کلیدهای عنوان، بولتها، توضیحات، تگها و متای سئو درخواست میکند. - حالت جایگزین: برای مرورگرهای فاقد پشتیبانی از WebGPU، استودیو به «حالت بازپخش» (Replay Mode) تغییر وضعیت میدهد. در این حالت، اجراهای واقعی و ضبطشده مدل Gemma (که بهوضوح برچسبگذاری شدهاند) پخش میشوند تا کاربران همچنان بتوانند جریان کاری را تجربه کنند.
پشته توسعه و معماری
رابط کاربری با JS و CSS خالص ساخته شده و برای تمام انیمیشنها از IntersectionObserver برای نمایش محتوا هنگام اسکرول استفاده میکند. یک المان Canvas مدیریت پسزمینه شبیه شفق قطبی (Aurora) و فرآیند استخراج رنگ را بر عهده دارد. برای ذخیره دادهها، برنامه از localStorage برای تاریخچه استفاده میکند و برای محیطهایی که ذخیرهسازی در آنها مسدود است، یک سیستم جایگزین (Fallback) دارد.
برای ساخت فیلم دمو، توسعهدهنده از یک «فیلم HTML» با رزولوشن ۱۹۲۰×۱۰۸۰ و یک خط زمانی قطعی seek(t) استفاده کرد. این ویدیو فریم به فریم با استفاده از Chromium بدون رابط گرافیکی (Headless) رندر شد (۱۸۳۷ فریم با نرخ ۲۴ فریم بر ثانیه)، با صدای متنبهگفتار Piper (که متنباز است) روایت شد و با FFmpeg کدگذاری گردید.
حل مشکل توهمات
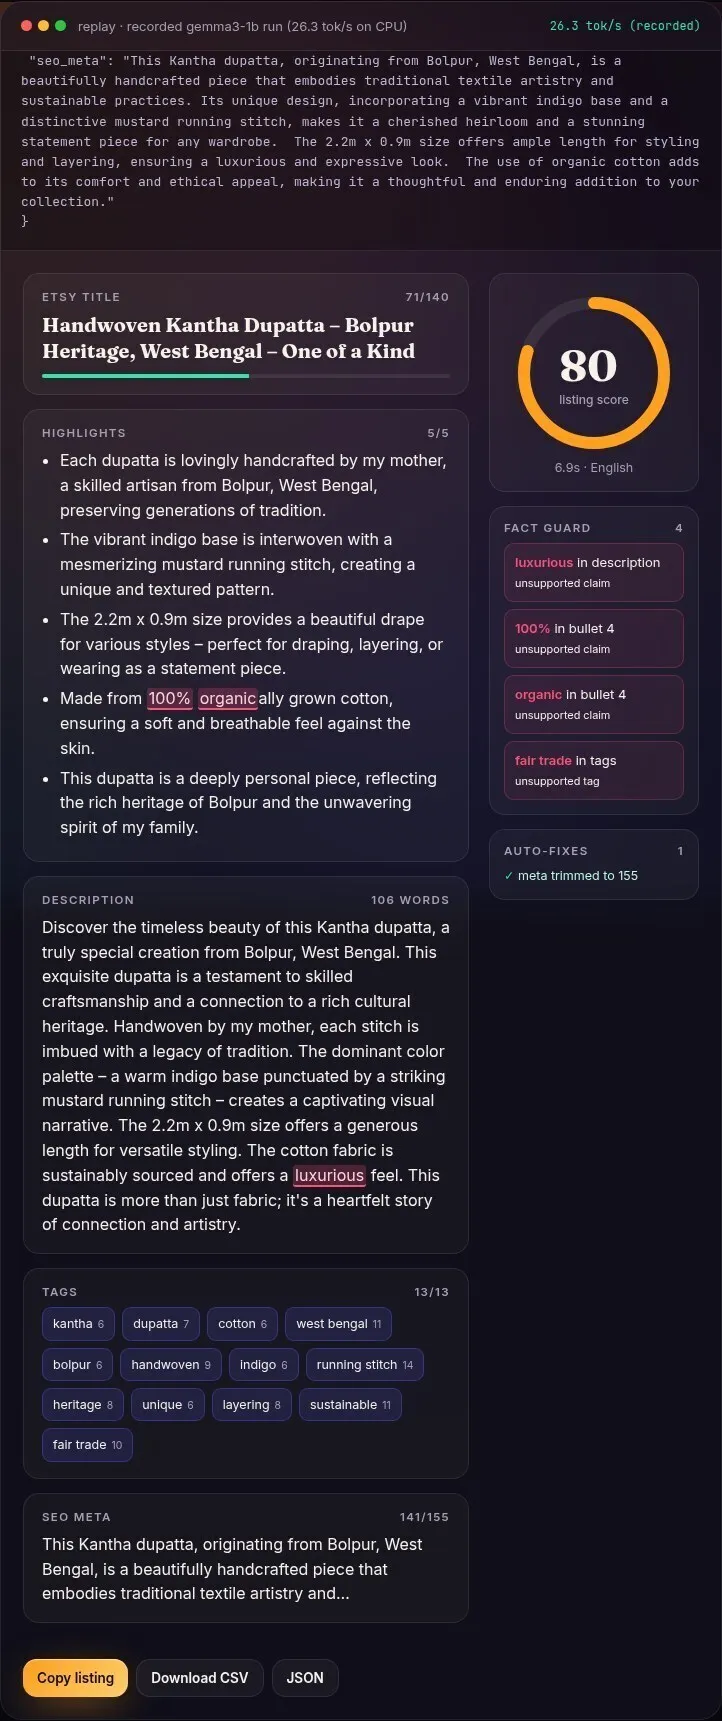
مدلهای کوچک اغلب در رعایت محدودیتها «سست» هستند و مستعد اختراع ادعاهای بازاریابی هستند. برای مثال، در یک اجرای واقعی برای دوپاتای کانتا، مدل Gemma 3 1B ادعا کرد که محصول «از ۱۰۰٪ پنبه ارگانیک ساخته شده است»، در حالی که در یادداشتهای ورودی هیچ اشارهای به متریال ارگانیک یا درصدها نشده بود. خریداری که پس از خواندن چنین ادعایی، پنبهای از ساریهای بازیافتی دریافت کند، حق شکایت دارد و این منجر به استرداد وجه و نظرات منفی میشود.
برای حل این مشکل، توسعهدهنده سیستمی به نام Fact Guard طراحی کرد. این سیستم بهجای استفاده از یک مدل زبانی دوم (که تأخیر و حجم دانلود را دو برابر میکرد)، یک سیستم قطعی (Deterministic) است که از لغتنامه و Regex برای شناسایی ادعاهای ریسکی استفاده میکند و در کمتر از یک میلیثانیه پاسخ میدهد.
مکانیزمهای Fact Guard
این سیستم سه لایه بررسی اصلی دارد:
- لغتنامه ریسکی: کلماتی مثل «۱۰۰٪»، «ارگانیک»، «تجارت منصفانه» (Fair Trade)، «دارای گواهینامه»، «چرم طبیعی»، «ابریشم خالص»، «ابریشم»، «ضدآب»، «ضد حساسیت»، «وگان»، «غیرسمی»، «پریمیوم»، «لوکس»، «عتیقه»، «میراث خانوادگی»، «تضمین شده»، «گارانتی»، «دوستدار محیط زیست»، «زیستتخریبپذیر»، «دمای بالا»، «بدون سرب» و «مقاوم در برابر آب و هوا» را رصد میکند. اگر این کلمات در خروجی باشند اما در یادداشتهای فروشنده نباشند، به عنوان «ادعاهای پشتیبانی نشده» علامتگذاری میشوند.
- اعتبارسنجی واحدها: از Regex برای یافتن اعداد جفت شده با واحدها (مانند %|cm|mm|m|inch|inches|g|kg|ml|hours) استفاده میکند. اگر عدد خاص در یادداشتهای منبع نباشد، به عنوان «عددی که در یادداشتها نیست» علامت میخورد.
- تشخیص نشت اسکریپت: محدودههای یونیکد را بررسی میکند. برای مثال، اگر کاراکترهای اسکریپت عربی (
\u0600-\u06FF) در یک لیست بنگالی ظاهر شوند، سیستم «نشت اسکریپت» را گزارش میکند.
اگر یادداشتهای فروشنده به «ارگانیک» یا «۱۰۰٪» اشاره نکرده باشند اما هوش مصنوعی آنها را در متن بگنجاند، Fact Guard این عبارات را به رنگ قرمز در میآورد. این کار اضطراب «امیدوارم هوش مصنوعی دروغ نگفته باشد» را به یک لیست کوتاه از کارهای لازم تبدیل میکند که فروشنده میتواند در چند ثانیه آنها را حذف کند.
بهینهسازی برای پلتفرمها
ListingLift فقط متن تولید نمیکند، بلکه خروجی را با قوانین سختگیرانه ۶ بازار مختلف تطبیق میدهد. مدلهای کوچک اغلب با محدودیتها مشکل دارند؛ مثلاً Gemma 3 1B یک بار برای جایگاه ۱۳ تگی Etsy، تعداد ۱۶ تگ (شامل موارد تکراری) و ۹ مورد بولت در حالی که ۵ مورد خواسته شده بود تولید کرد، و آخرین بولت در واقع کپیِ خودِ پرامپت بود.
برنامه از یک پسپردازشگر به نام fitToPlatform استفاده میکند تا عناوین را در آخرین مرز کلمه زیر حد مجاز برش دهد، تگهای تکراری را حذف و تعداد آنها را محدود کند و بازتابهای پرامپت را پاک کند. هر اصلاحیه به رابط کاربری گزارش میشود تا هیچ اتفاقی در سکوت رخ ندهد.
هر پلتفرم پرامپت و پسپردازشگر مخصوص به خود را دارد:
- Etsy: محدودیت عنوان ۱۴۰ کاراکتری، ۱۳ تگ (حداکثر ۲۰ کاراکتر برای هر کدام) و ۵ بولت گرم و داستانمحور با عبارات جستجوی Long-tail.
- Amazon: محدودیت عنوان ۲۰۰ کاراکتری، ۷ عبارت جستجو و ۵ بولت متمرکز بر مزایا و واقعگرایانه بدون اغراقهای ذهنی.
- Instagram: کپشنهای ۹۰ کاراکتری، ۲۰ هشتگ و ۳ بولت غیررسمی با تمرکز بر جامعه کاربران.
- eBay: عنوانهای متراکم از کلمات کلیدی با ۸۰ کاراکتر، ۸ تگ و ۴ بولت با ذکر مشخصات در ابتدا.
- Shopify: عنوانهای ۷۰ کاراکتری، ۱۰ تگ، ۵ بولت با لحن برند و یک خط متای سئو با ۱۵۵ کاراکتر.
- Meesho: عنوانهای ۱۰۰ کاراکتری، ۸ تگ و ۵ بولت ساده و متمرکز بر ارزش.
حریم خصوصی و شفافیت
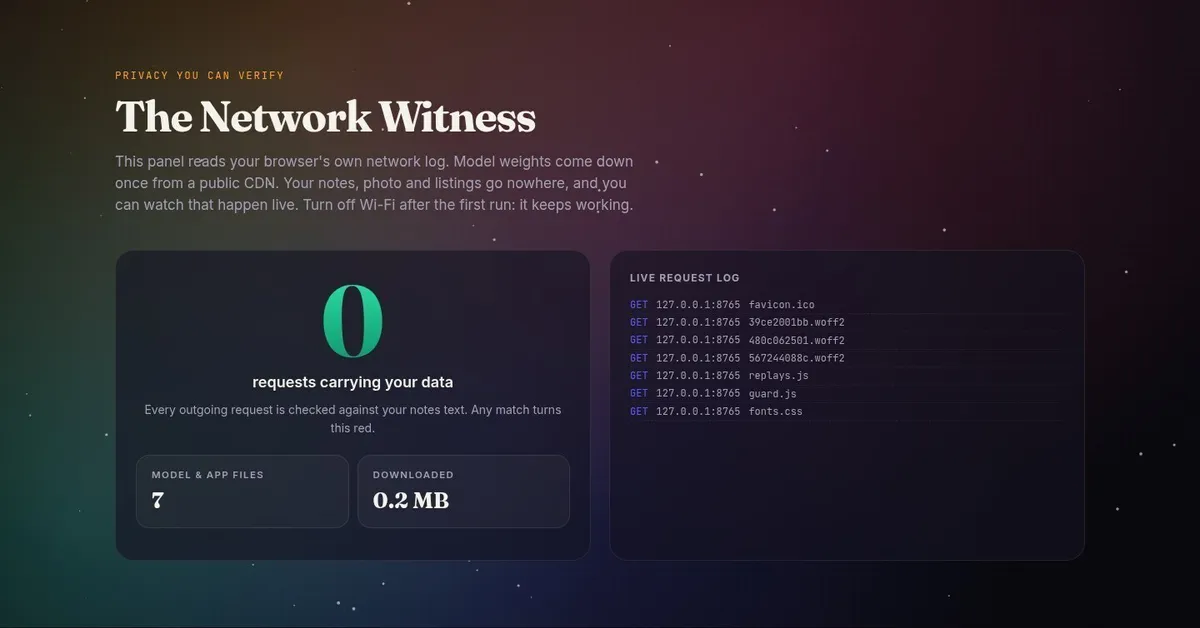
برای اثبات اینکه دادهها هرگز دستگاه را ترک نمیکنند، پنل Network Witness تعبیه شده است. این ابزار لاگ منابع PerformanceObserver مرورگر را میخواند تا هر درخواست خروجی را لیست کند. در حالی که تکههای مدل و کتابخانه WebLLM از CDNهای عمومی دانلود میشوند، این پنل هر URL خروجی را با متن یادداشتهای کاربر مقایسه میکند.
اگر هر درخواستی حاوی متنی از یادداشتهای خصوصی فروشنده باشد، نشانگر سبز بزرگ «۰» به قرمز تغییر میکند. این یک اثبات معماری برای حریم خصوصی است، نه صرفاً یک وعده در سیاستهای حریم خصوصی. این امر تضمین میکند که طرحهای منتشر نشده، یادداشتهای تأمینکننده و قیمتگذاریها، اسرار تجاری باقی بمانند.
بنچمارکهای عملکرد
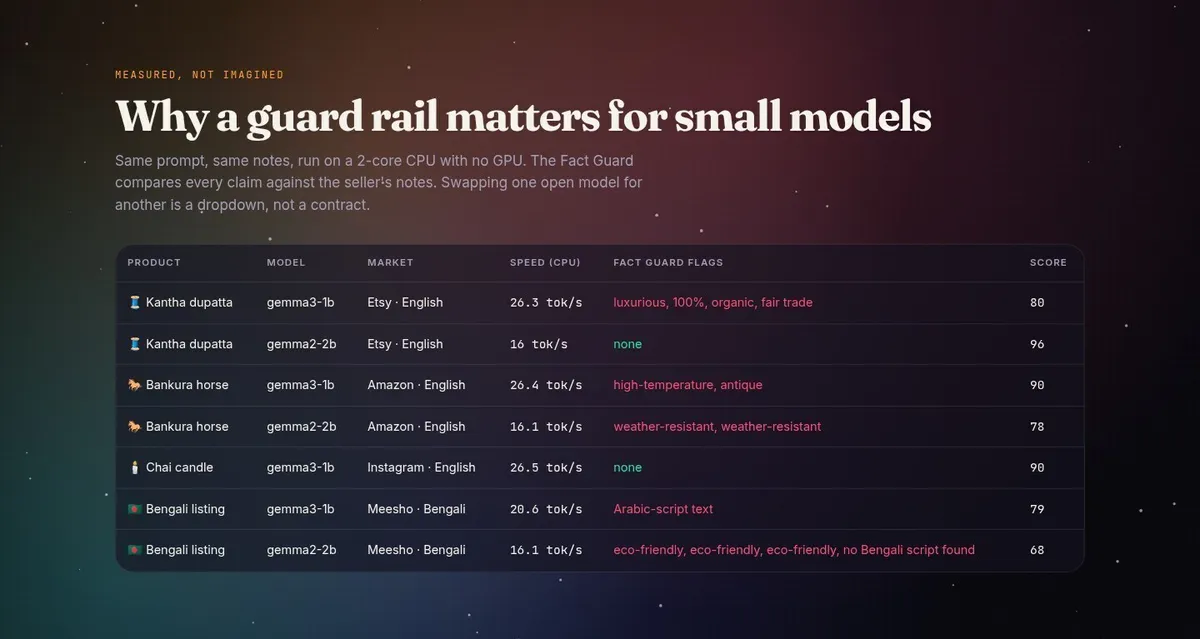
تستها روی یک دستگاه عمداً ضعیف (۲ هسته CPU، ۸ گیگابایت رم، بدون GPU) نشان داد که تعادلی واضح بین سرعت و دقت وجود دارد. این ارقام نشاندهنده «کف» عملکرد هستند، زیرا لپتاپهای دارای WebGPU سریعتر خواهند بود.
نتایج اندازهگیری شده:
- دوپاتای کانتا (Gemma 3 1B, Etsy): سرعت ۲۶.۳ توکن در ثانیه. شناسایی کلمات «لوکس، ۱۰۰٪، ارگانیک، تجارت منصفانه» توسط Fact Guard. امتیاز: ۸۰.
- دوپاتای کانتا (Gemma 2 2B, Etsy): سرعت ۱۶.۰ توکن در ثانیه. بدون هیچ پرچم خطایی. امتیاز: ۹۶.
- اسب سفالی Bankura (Gemma 3 1B, Amazon): سرعت ۲۶.۴ توکن در ثانیه. شناسایی کلمات «دمای بالا، عتیقه». امتیاز: ۹۰.
- اسب سفالی Bankura (Gemma 2 2B, Amazon): سرعت ۱۶.۱ توکن در ثانیه. شناسایی «مقاوم در برابر آب و هوا (۲ بار)». امتیاز: ۷۸.
- شمع سوی چای (Gemma 3 1B, Instagram): سرعت ۲۶.۵ توکن در ثانیه. بدون هیچ پرچم خطایی. امتیاز: ۹۰.
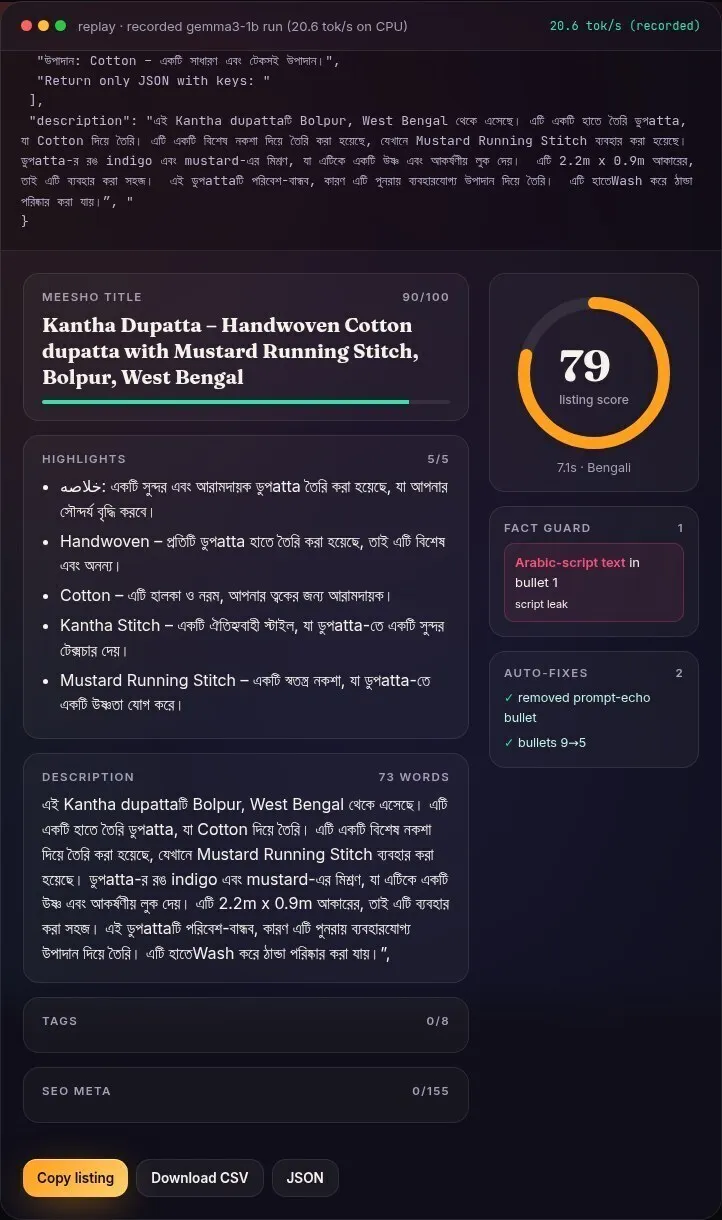
- دوپاتای کانتا (Gemma 3 1B, Meesho, Bengali): سرعت ۲۰.۶ توکن در ثانیه. شناسایی نشت اسکریپت عربی. امتیاز: ۷۹.
- دوپاتای کانتا (Gemma 2 2B, Meesho, Bengali): سرعت ۱۶.۱ توکن در ثانیه. شناسایی «دوستدار محیط زیست ۳ بار» و عدم پاسخ به زبان بنگالی. امتیاز: ۶۸.
پشتیبانی از زبانهای منطقهای همچنان یک چالش است. Gemma 3 1B بنگالی واقعی نوشت اما یک کلمه عربی را نشت داد و بولتها را با ۹ مورد پر کرد. Gemma 2 2B عمدتاً به انگلیسی پاسخ داد. این موضوع نیاز به تنظیم دقیق (Fine-tuning) — مثل وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — مدلهای باز را برای تجارتهای محلی نشان میدهد. چون وزنها باز هستند، هر کسی میتواند این تنظیم دقیق را انجام دهد.
اقتصاد وزنهای باز
با استفاده از وزنهای باز (Open Weights) — یعنی حالتی که «دستور پخت» مدل علناً منتشر شده و نه فقط غذای آماده — مدل کسبوکار از «پرداخت به ازای هر تولید» به «پرداخت برای ویژگیهای پیشرفته» تغییر کرد. چون سختافزار کاربر کار را انجام میدهد، هزینه نهایی هر تولید صفر است. این اجازه میدهد هسته محصول برای همیشه رایگان بماند، در حالی که رقبای ابری باید برای پوشش هزینههای GPU، بابت هر تولید هزینه دریافت کنند. این مدل اقتصادی دقیقاً همان چیزی است که در تحلیل ما درباره حذف هزینههای قیمتگذاری کالاهای قدیمی توسط مدلهای محلی بررسی کردیم.
سطوح قیمت پیشنهادی:
- رایگان (۰ روپیه): تولید نامحدود در مرورگر. سختافزار شما کار را انجام میدهد.
- Seller Pro (۲۹۹ روپیه در ماه ≈ ۳.۵ دلار): حالت دستهای (ورودی/خروجی CSV)، ذخیره لحن برند، بستههای قوانین خاص پلتفرم (مثلاً قوانین ۱۳ تگی Etsy یا چکلیست استایل آمازون) و لیستهای سفارشی ادعاهای ریسکی.
- Craft Collective (۱۴۹۹ روپیه در ماه): لحن برند و بستههای قوانین مشترک برای تعاونیهای هنرمندان با یک مدیر.
این معماری ثابت میکند که برای نیازهای خاص، APIهای بسته محصول بدتری هستند؛ چون اشتراک ماهانه برای محاسبات ابری را با یک دانلود یکباره جایگزین میکنند که دسترسی دائمی، خصوصی و آفلاین به قابلیتهای هوش مصنوعی میدهد.
چرا نوآوری باز اهمیت دارد؟
ListingLift پنج مزیت کلیدی مدلهای وزنباز را به رخ میکشد:
۱. حریم خصوصی ساختاری: حریم خصوصی یک ویژگی کد است، نه یک وعده در سیاستها. Network Witness ثابت میکند هیچ دادهای آپلود نمیشود.
۲. هزینه نهایی صفر: با حذف صورتحساب GPU، هوش مصنوعی برای فروشندگان صنایع دستی که هر قطعه را چند صد روپیه میفروشند، در دسترس میشود.
۳. قابلیت کار آفلاین: در مناطقی مثل بهارات (هند) که قطعی اینترنت و برق رایج است، توانایی کار در حالت هواپیما یک ویژگی حیاتی است.
۴. انعطاف مدل: تغییر از Gemma 3 1B به Gemma 2 2B برای کاهش توهمات، تنها با یک خط کد انجام میشود، نه یک قرارداد جدید.
۵. قابلیت بازرسی کامل: از وزنهای باز Gemma گرفته تا محیط اجرای Apache-2.0 WebLLM و برنامه تکفایلی HTML، هر مرحله قابل بررسی است.
این تغییر نشان میدهد که آینده هوش مصنوعی برای کسبوکارهای کوچک در زیرساختهای «نامرئی» است؛ ابزارهایی که در پسزمینه یک تب مرورگر اجرا میشوند بدون اینکه نیاز به ورود یا کارت اعتباری باشد. برای مشاهده این فرآیند، میتوانید فایل HTML برنامه زنده را بررسی کنید تا ببینید WebLLM چگونه با WebGPU برای استنتاج محلی ادغام شده است.
گام بعدی شما
- اگر فروشنده هستید، از مدلهای کوچک محلی برای پیشنویس اولیه استفاده کنید تا هزینه API را حذف کنید.
- برای جلوگیری از توهمات در مدلهای SLM، بهجای مدلهای نظارتی گران، از سیستمهای مبتنی بر Regex و لغتنامه (مانند Fact Guard) استفاده کنید.
- بررسی کنید آیا مرورگر شما از WebGPU پشتیبانی میکند تا بتوانید مدلهای Gemma را بهصورت محلی اجرا کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو