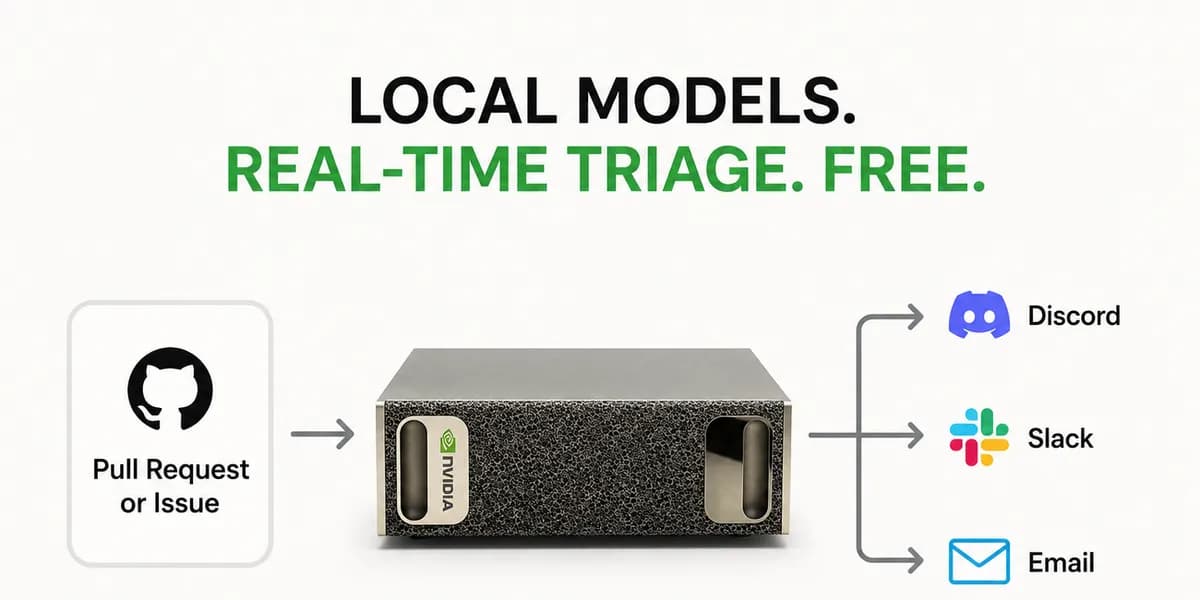
تصور کنید مدیر یک مخزن کد هستید که روزانه صدها درخواست تغییر (PR) و گزارش خطا دریافت میکند و باید هر لحظه تصمیم بگیرید کدام مورد بحرانی است. این مشارکتها باید سریعاً طبقهبندی، اولویتبندی و به نگهداران (Maintainers) مربوطه ارجاع شوند تا سرعت توسعه حفظ شود. اگر هنوز برای این فرآیند به APIهای ابری وابسته هستید، ریسک آن است که دسترسی شما در یک شب قطع شود و کل خط لوله مدیریت پروژه از کار بیفتد. من، اونور (Onur)، به عنوان نگهدار این حوزه خاص، در تلاش هستم تا مدلهای محلی را با OpenClaw سازگار کنم تا بتوانیم به سرعت به مسائل بحرانی (P0) واکنش نشان دهیم.
طبق اعلام تیم OpenClaw در ۲۲ ژوئن ۲۰۲۶، حالا میتوان این وابستگی را با یک خط لوله «طبقهبندی عاملمحور» (Agentic Classification) کاملاً محلی جایگزین کرد که طبقهبندیهای پرهزینه ابری را حذف میکند. این تحول در زمانی رخ میدهد که بسیاری از توسعهدهندگان متوجه شدهاند تکیه به مدلهای بسته، یعنی پذیرش یک ریسک استراتژیک؛ درست مانند اتفاقی که با حذف مدل Claude Fable 5 توسط آنتروپیک رخ داد و بسیاری از کسبوکارها را شوکه کرد. این اتفاق یادآور آن است که ساخت یک بیزنس روی مدلهای بسته، ایجاد یک وابستگی متزلزل است.
برای تیمهایی که پروژههای متنباز حجیم را مدیریت میکنند، مالکیت کامل زیرساخت هوش مصنوعی (AI Stack) و اجرای مدلها به صورت محلی دیگر یک انتخاب لوکس نیست، بلکه شرط بقا و پایداری است. این رویکرد با پیشرفتهای اخیر در ابزارهای هوش مصنوعی محلی همسو است که اجرای عاملهای خصوصی را حتی بدون نیاز به سختافزارهای صنعتی بسیار سنگین ممکن ساخته است. همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، کنترل بر لایهی استنتاج، تنها راه تضمین تداوم عملیات است.
در حالت سنتی، شما یا باید برای اتوماسیون این فرآیند ماهانه ۲۰۰ دلار برای اشتراکهای سطح بالای ChatGPT Pro هزینه میکردید یا برای صرفهجویی در سهمیه، ساعتها منتظر پردازش دستهای (Batching) میماندید که هر ۲ یا ۶ ساعت یکبار اجرا میشد. اما تیم OpenClaw با استفاده از سختافزاری مثل NVIDIA GB10 (یک DGX Spar 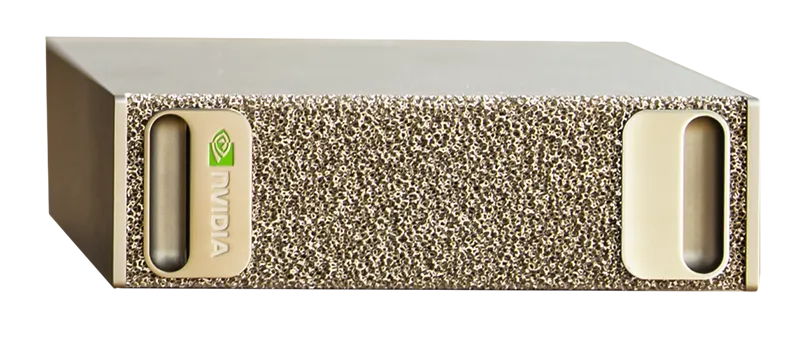 k) با ۱۲۸ گیگابایت حافظه یکپارچه، به اعلانهای آنی دست یافتند که تنها هزینه آن برق مصرفی است (با فرض اینکه سختافزار را از قبل در اختیار دارید).
مکانیسم طبقهبندی عاملمحور
این سیستم از یک دستانداز عاملمحور به نام Pi استفاده میکند و فراتر از طبقهبندی متنی ساده حرکت میکند. برخلاف طبقهبندهای قدیمی مبتنی بر BERT، این روش از خروجیهای ساختاریافته و استفاده از ابزار (Tool Use) — شبیه به دستیاری که قبل از جواب دادن، ابتدا پوشههای بایگانی را میگردد — برای تخصیص برچسبها استفاده میکند. هدف، دستهبندی موارد در مجموعهای محدود از برچسبهاست، مانند: local_models ،self_hosted_inference ،acp ،agent_runtime ،codex و ui_tui.
برای تضمین امنیت و دقت، این تیم یک «دستورالعمل» (Recipe) خاص را پیاده کرده است:
- Localpager-agent: پیکربندی خاصی از Pi که نقاط انتهایی (Endpoints) مدل محلی را فراخوانی میکند. این عامل در اولین پرامپت، عنوان PR، متن بدنه و یک بخش کوتاه شده (Truncated excerpt) از تغییرات کد (PR diff) را دریافت میکند.
- Reposhell: یک پوسته bash محدود و فقط-خواندنی است. این لایه از «تزریق پرامپت» (Prompt Injection) توسط PRهای مخرب جلوگیری میکند. این کار با مسدود کردن دستوراتی مثل
curlو اجازه دادن به عملیاتهای فقط-خواندنی انجام میشود. برای مثال، اگر مدلی سعی کند دستورcurl localhostرا اجرا کند، سیستم پیامpolicy denied command: unsupported command "curl"را با کد خروجیexit_code=2برمیگرداند. - دستورات مجاز Reposhell: دسترسی عامل به دستورات محدودی نظیر
pwd،ls،find،rg،grep،sed -n،cat،head،tail،wc -l،git status --short،git show --name-only،git grepوgit ls-filesمحدود شده است. مدل تصور میکند که از bash استفاده میکند، اما این پوسته به مسیرcwd=/repo/openclawو مخزنrepos=openclawمتصل است. مثالهایی از جستجوهای خاص شامل استفاده ازrg -n -i "lm studio"یاgit ls-files srcاست. - ابزار Final_json: ابزاری اختصاصی که عامل باید در نهایت برای ارسال نتیجه طبقهبندی خود در یک قالب JSON سختگیرانه (Strict Schema) از آن استفاده کند.
این سازوکار به مدل اجازه میدهد پیشفرضهای خود را اصلاح کند. به نقل از مستندات پروژه، در یک جلسه، مدل qwen3.6-35b-a3b در حال طبقهبندی مسئله شماره ۸۴۶۲۱ («اصلاح مدیریت دلیل توقف بازنویسی فراخوانی ابزار Kimi») بود. در بلوک تفکر (Thinking block) مدل دیده شد که ابتدا برچسب coding_agent_integrations را در نظر گرفت، زیرا مسیر تغییر یافته extensions/kimi-coding این احتمال را ایجاد میکرد. با این حال، مدل با استفاده از دستورات ls extensions ،ls extensions/kimi-coding و cat extensions/kimi-coding/package.json از طریق reposhell، متوجه شد که این افزونه در واقع @openclaw/kimi-provider است. در نتیجه، مدل برچسبها را به inference_api و tool_calling تغییر داد و صراحتاً برچسب اشتباه قبلی را حذف کرد.
جزئیات فنی پیادهسازی
مدل Localpager-agent از طریق یک رابط خط فرمان (CLI) با آرگومانهای خاص برای مدیریت جلسه و دسترسی به ابزارها اجرا میشود:
--model: تعیین شناسه مدل (Model ID).--base-url: آدرس پایه سازگار با OpenAI.--session-dir: دایرکتوری برای خروجیهای جلسه.--final-schema: مسیر فایلruntime-schema.json.--tools: به صورتbash,final_jsonتعریف شده است (که در آن bash به reposhell مپ شده است).--reposhell-socket: فایل.sockبرای ارتباط با reposhell.--reposhell-default-repoو--reposhell-visible-repo: شناسههای مربوط به دسترسی به مخازن.-p: پرامپت رندر شده که از یک فایل مارکداون خوانده میشود (مثلاً$(cat <rendered-prompt.md>)).
عملکرد و بنچمارکها
تیم OpenClaw دو مدل gemma-4-26b-a4b و qwen3.6-35b-a3b را روی یک مجموعه داده ارزیابی ۳۳۰ ردیفه آزمایش کرد. برای ساخت این دادهی مرجع (Gold-standard dataset)، هر مورد ۵ بار برچسبگذاری شد (۳ بار توسط GPT-5.5 و ۲ بار توسط Opus 4.8). برای نهایی کردن این لیست، توافق مدلها و داوری انسانی مورد نیاز بود تا تعاریف برچسبها بهبود یابد و تصمیمات طراحی داخلی محصول برجسته شود.
برای کارهای اولیه روی پرامپت، تیم از DeepSeek-V4-Flash از طریق پیادهسازی antirez (به طور خاص فایل DeepSeek-V4-Flash-IQ2XXS-w2Q2K-AProjQ8-SExpQ8-OutQ8-chat-v2.gguf از antirez/deepseek-v4-gguf) استفاده کرد. این تنظیمات از سرور DS4 روی CUDA بهره میبرد. با این حال، DS4 به عنوان عامل اصلی رد شد چون در اجراهای مختلف ناهماهنگ بود و برای توان عملیاتی بالا بیش از حد بزرگ بود؛ سرور DS4 تقریباً ۱۴ توکن در ثانیه با حداکثر همزمانی (Concurrency) ۱ ارائه میداد.
نتایج نشاندهندهی یک موازنه واضح میان دقت و سرعت است:
- Gemma (gemma-4-26b-a4b): بازخوانی (Recall) بالاتر (۰.۹۰۵ ± ۰.۰۰۴) و زمان اجرای واقعی (Wall-clock time) بسیار کمتر (۱.۴۱ ثانیه ± ۰.۰۴) داشت. این مدل نرخ مثبت کاذب (False Positive) بالاتری داشت (۲۲۷.۰ ± ۱۰.۵) اما سرعت خروجی تجمیعی برتر (۴۰۲.۶ توکن در ثانیه) با همزمانی ۱۶ را ثبت کرد.
- Qwen (qwen3.6-35b-a3b): دقت (Precision) بیشتر (۰.۸۳۱ ± ۰.۰۰۷)، نرخ تطابق دقیق (Exact Match) بالاتر (۰.۵۴۰ ± ۰.۰۱۴) و مثبت کاذب کمتر (۱۰۵.۷ ± ۶.۴) نشان داد. با این حال، زمان اجرای آن کندتر بود (۱۳.۵۱ ثانیه ± ۰.۷۹) و همزمانی آن ۴ بود. نتایج Qwen شامل تلاشهای مجدد (Retries) برای شکستهای خروجی ساختاریافته بود، جایی که مدل پیش از فراخوانی
final_jsonبا محدودیت توکن مواجه میشد. - DeepSeek-V4-Flash: اگرچه کمترین مثبت کاذب (۳۰ مورد) را داشت، اما زمان اجرای آن (۱۴۴.۱۴ ثانیه) و سرعت ۱۳ توکن بر ثانیه، آن را برای استفاده در لحظه (Real-time) روی GB10 غیرعملی میکرد.
بهینهسازیهای فنی کلید رسیدن به این اعداد بود. تیم از vLLM با کوانتشی NVFP4 استفاده کرد که یک فرمت سازگار با سختافزار Blackwell است. این فرمت ترافیک حافظه را کاهش داده و در مقایسه با GGUFهای قابل حمل (مانند Q4_K_M)، فضای بیشتری برای دستهبندی (Batching) ایجاد میکند. آنها همچنین توان عملیاتی را با موارد زیر افزایش دادند:
- Prefix caching
- FP8 KV cache
- CUTLASS MoE backend
- حالت Language-model-only
این تنظیمات به gemma-4-26b-a4b اجازه داد تا به خروجی تجمیعی ۴۰۲.۶ توکن در ثانیه برسد. در تستهای مجزا، این مدل در همزمانی ۳۲ به بیش از ۷۰۰ توکن تجمیعی در ثانیه دست یافت. اجرای کامل بنچمارک ۳۳۰ ردیفه در حدود ۷.۵ دقیقه به پایان رسید.
ارکستراسیون و اعتبارسنجی
معماری کلی سیستم «نیمهعاملمحور» است؛ یعنی طبقهبندی با عامل انجام میشود اما ارسال اعلانها طبق قوانین قطعی (Deterministic) است. این کار از رقابت بر سر منابع در GPU جلوگیری کرده — و پهنای باند را برای کارهایی که واقعاً به استنتاج نیاز دارند رزرو میکند — و احتمال خطای اعلان را کاهش میدهد.
۱. Gitcrawl: ابزار openclaw/gitcrawl به عنوان یک آینهی محلی از مخزن عمل میکند تا عامل نیازی به مرور مداوم URLهای گیتهاب نداشته باشد.
۲. پایگاهداده SQLite: دادههای ورودی PR/issue را نرمالسازی کرده و در پایگاه داده اختصاصی localpager ذخیره میکند. هر مورد جدید یک «شغل» (Job) طبقهبندی را فعال میکند.
۳. صف Worker: یک Worker شغل را برمیدارد و یک شیء بستر گیتهاب (GitHub context object) شامل عنوان، متن، برچسبها، نویسنده، وضعیت و در صورت نیاز، کامنتها، فایلهای تغییر یافته و بخشهای diff را میسازد.
۴. اجرای عامل: بستر متنی رندر شده و به localpager-agent ارسال میشود. عامل میتواند فکر کند و از reposhell استفاده کند، اما در نهایت باید نتیجه را در قالب طرحواره (Schema) تعریف شده صادر کند.
۵. اتصال به دیسکورد: نتیجه در SQLite ذخیره شده و بر اساس سیاستهای اعلان تعریف شده توسط کاربر به دیسکورد ارسال میشود.
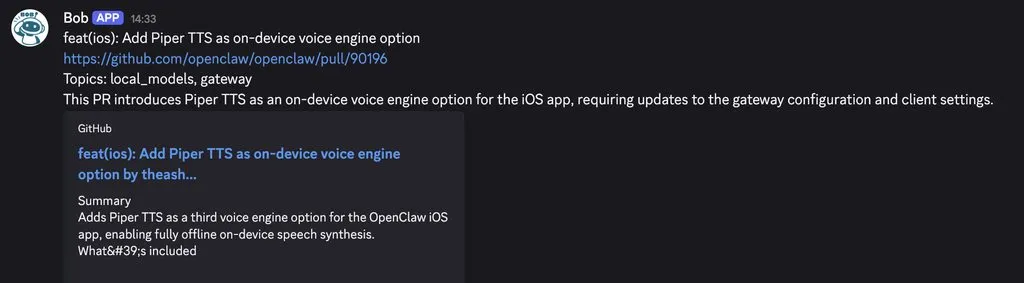
برای اعتبارسنجی سیستم محلی، تیم یک «حلقه بازرسی» (Audit Loop) ایجاد کرد. هر ۲ ساعت، یک عامل GPT-5.5 دستهای از مسائل/PRها را در یک محیط Sandbox مدیریت میکند تا عملکرد مدل محلی را قضاوت کند. عامل OpenClaw یک فایل ماشین-خوان را بهروزرسانی میکند و یک اسکریپت، میزان مثبت و منفی کاذب را محاسبه میکند.
برای مثال، بازرس «منفیهای کاذب» (False Negatives) را شناسایی میکند؛ مانند مسئله شماره ۸۸۴۹۹ (openai-responses provider: 404 on previous_response_id) که اعلان باید برای agent_runtime ،api_surface و sessions ارسال میشد اما هیچ اعلانی ارسال نشد. همچنین «مثبتهای کاذب» (False Positives) را مییابد؛ مانند PR شماره ۸۸۲۷۵ (fix(models-config): allow self-hosted providers without apiKey) و PR شماره ۸۸۲۶۶ (refactor: extract model catalog core package) که با وجود عدم نیاز در پروفایل علاقهمندی کاربر، اعلان ارسال شده بود.
هزینه این بازرسی پژوهشمحور حدود ۴۰ هزار توکن GPT-5.5 در هر بررسی ۲ ساعته است (که بیشتر آنها کش شدهاند) و در مجموع حدود ۲ تا ۳ سنت در هر اجرا یا تقریباً ۹ دلار در ماه میشود. در عمل، تیم پیشنهاد میکند برای کالیبراسیون در طول یک دوره آزمایشی از مدلهای بزرگتر استفاده کنید و سپس به طور کامل به یک مدل محلی کوچکتر کوچ کنید.
تحلیل: ظهور طبقهبندی با توان عملیاتی بالا
این پیادهسازی ثابت میکند که «طبقهبندی عاملمحور» — جایی که مدل قبل از تصمیمگیری، با ابزارها به دنبال بستر بیشتر میگردد — برای کارهای حجیم و بدون به خطر انداختن امنیت، کاملاً عملی است. برای توسعهدهنده، این به معنای گذار از «پرامپتهای تکمرحلهای» (One-shot prompt) به سیستمی است که واقعاً میتواند پیش از برچسبگذاری یک باگ، کدبیس را بازرسی کند.
این رویکرد مورد خاصی از مجموعهای گستردهتر از وظایف است که «طبقهبندی با توان عملیاتی بالا» (High Throughput Triage) نامیده میشوند. مدلهای بازمتن (Open-weights) با اندازه متوسط اکنون به اندازه کافی توانمند هستند تا به عنوان فیلترهای با دقت بالا عمل کنند و نیاز به مدلهای گرانقیمت SOTA برای هر تکتک کارهای دستهبندی سطح پایین را کاهش دهند. این الگو محدود به گیتهاب نیست و در چندین حوزه دیگر کاربرد دارد:
- روزنامهنگاری: دستهبندی اخبار در جریانهای عظیم اطلاعاتی.
- رسانههای اجتماعی: فیلتر کردن پستهای مورد علاقه در X یا رددیت.
- پشتیبانی مشتری: طبقهبندی بهینه تیکتهای پشتیبانی.
- مدیریت محتوا: فیلتر کردن درخواستهای بازبینی برای بررسی.
- فروش: فیلتر کردن سرنخهای بالقوه برای ارتباط (Outreach leads).
- پژوهش: فیلتر کردن موضوعات خاص از مقالات arXiv.
اگر در حال حاضر برای کارهای سادهی مسیریابی، مبالغ زیادی بابت لایههای ابری با حجم توکن بالا میپردازید، مهاجرت به یک مدل MoE محلی روی سختافزارهای کلاس Blackwell میتواند هزینههای ماهانه API شما را حذف کرده و تأخیر را به میلیثانیه برساند. برای آزمایش این رویکرد، میتوانید مخازن OpenClaw و localpager را بررسی کنید تا ببینید چگونه پوسته محدود و صف شغل مبتنی بر SQLite را پیاده کردهاند.
گام بعدی شما
- مخازن OpenClaw و localpager را در گیتهاب بررسی کنید تا با نحوه پیادهسازی پوسته محدود آشنا شوید.
- اگر سختافزار Blackwell دارید، ترکیب vLLM و کوانتش NVFP4 را برای افزایش توان عملیاتی تست کنید.
- یک حلقه بازرسی (Audit Loop) با مدلهای بزرگتر طراحی کنید تا نرخ خطای مدل محلی خود را بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو