
تصور کنید دوربین امنیتی شما بهجای ضبط سادهی ویدیو، در هر لحظه درصدی دقیق از احتمال حضور یک انسان را گزارش کند. شما در حال خواندن یک جمله نیستید، بلکه در حال مشاهدهی یک جریان دادهی زنده از میزان اطمینان مدل هستید. این یعنی تبدیل یک مدل مولد به یک ابزار اندازهگیری دقیق که بهجای نوشتن جملات، دادههای ساختاریافته تولید میکند.
طبق گزارشی از وبلاگ allanrbo، در ۲۶ سپتامبر ۲۰۲۶، یک نمایش فنی ثابت کرد که میتوان مدل Gemma 4 12B را در ساختاری شبیه به Jev قرار داد تا طبقهبندی بصری بلادرنگ را از طریق احتمالات توکن (logprobs) انجام دهد. این رویکرد، چرخهی سنتی «پرسش و پاسخ» را کنار میگذارد؛ بهجای اینکه از مدل بخواهیم صحنه را توصیف کند، او را مجبور میکنیم بین گزینههای پیشفرض یکی را انتخاب کند. این تغییر، مدل زبانی بزرگ (LLM) را از یک همصحبت تبدیل به یک استخراجکنندهی دادههای ساختاریافته میکند.
همانطور که در تحلیل قبلی ما دربارهی لنگرهای دادهای اشاره کردیم، تمرکز بر تقویت حافظه مدل اهمیت دارد، اما این تکنیک روی نقطهی مقابل یعنی بازدهی استنتاج (Inference) — که مثل لحظهی خودِ آشپزی است، نه دورهی آموزش آشپز — تمرکز میکند. در حالی که یادگیری بیشتر به مدل کمک میکند تا بیشتر بداند، طبقهبندی بر اساس logprob باعث میشود مدل سریعتر و پیشبینیپذیرتر پاسخ دهد. در این راستا، درک دقیق پارامترهای نمونهبرداری و تأثیر آنها بر هزینههای استنتاج میتواند به بهینهسازی بیشتر این مدلهای بلادرنگ کمک کند.
سازوکار Logprob
تکنیک اصلی بر اساس درخواست احتمالات توکن برای اولین توکنی است که مدل تولید میکند. این یک روش تثبیتشده است، همانطور که در «کتابچه دستورالعمل logprobs» شرکت OpenAI دیده میشود، اما در اینجا برای جریانهای بینایی بلادرنگ به کار گرفته شده است. توسعهدهنده با تنظیم max_completion_tokens روی عدد ۱ و فعال کردن logprobs باعث میشود API احتمال هر توکن ممکن برای کلمهی بعدی را برگرداند.
برای اینکه این سیستم به یک طبقهبندیکننده تبدیل شود، پرامپت بهصورت یک سؤال چندگزینهای طراحی میشود. برای مثال، یک پرامپت ممکن است به این صورت باشد: «وضعیت: سفارش من شکسته رسیده است و من درخواست بازپرداخت دارم. سؤال: کدام تیم باید رسیدگی کند؟ [A] حسابداری [B] ارسال [C] مرجوعی. فقط حرف گزینهی درست را بنویس.»
چون مدل تنها یک توکن تولید میکند، پاسخ تقریباً آنی است. سپس توسعهدهنده این احتمالات را نرمالسازی کرده و به درصد تبدیل میکند تا امتیاز اطمینان هر گزینه مشخص شود. این کار از پاسخهای طولانی جلوگیری کرده و تأخیر را بهشدت کاهش میدهد، هرچند پردازش ورودی همچنان زمانبر است.
معماری سامانه و مدلهای بینایی
این پروژه از پروژههایی مثل Jev و پروژههای قابل میزبانی محلی مانند OpenJev و SemIf الهام گرفته تا مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — را به یک حسگر انعطافپذیر تبدیل کند.
نویسنده اشاره میکند که برای بهینهسازی، اگر بکاند پشتیبانی کند، میتوان یک پیشوند وضعیت مشترک (shared state prefix) برای هر یک از سؤالات را در KV Cache (حافظه موقت کلید-مقدار) ذخیره کرد. این کار هزینه محاسباتی پردازش ورودی برای چندین سؤال در هر فریم را کاهش میدهد. این نوع بهینهسازی در مقیاس صنعتی مشابه رویکرد شرکتهایی است که با استفاده از کاتالوگهای مدل یکپارچه سعی در کاهش هزینههای عملیاتی AI دارند.
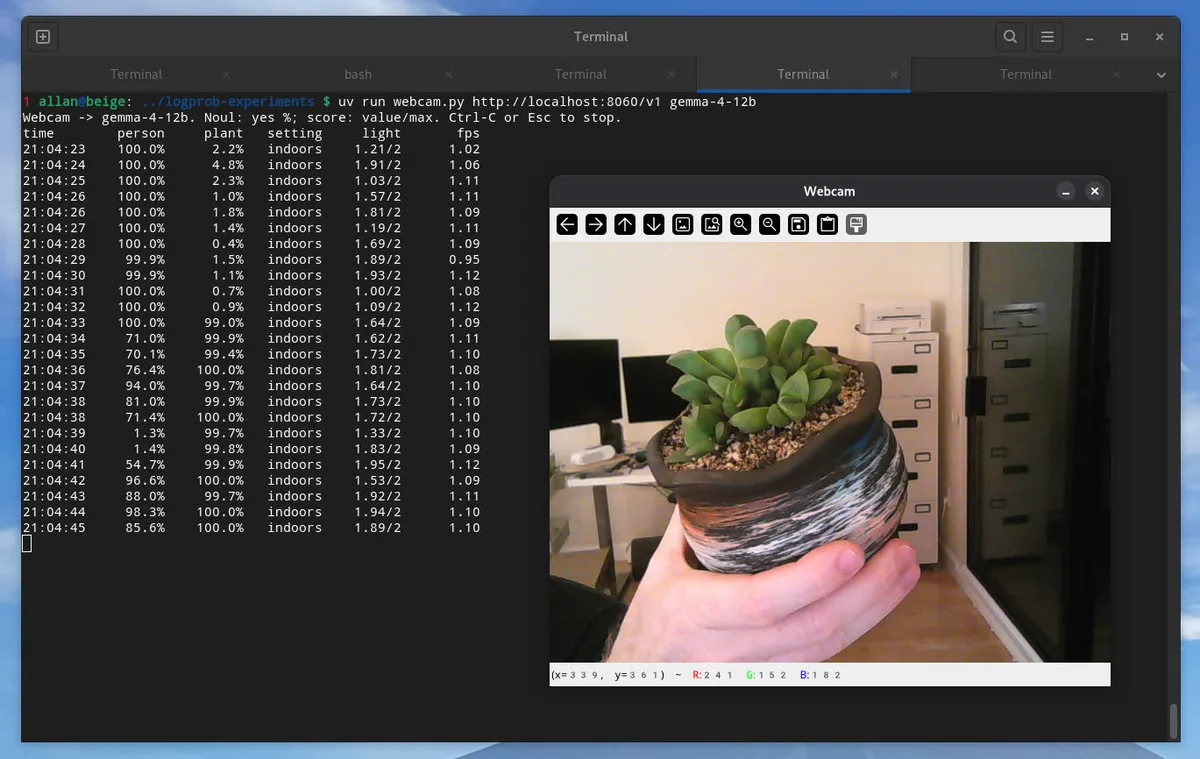
در این پیادهسازی، برای گسترش به مدلهای بینایی، یک فیلد سفارشی attachments برای تصاویر اضافه شده است. این کار اجازه میدهد همان منطق روی مدلهای چندوجهی (Multimodal) — که مثل ما با چند حس دنیا را میخوانند — اعمال شود تا بتوانند تصاویر JPEG کدگذاریشده به صورت base64 را ببینند. در یک تست عملی با وبکم، سیستم در هر فریم سه سؤال میپرسید:
- آیا انسانی دیده میشود؟
- محیط داخلی است یا خارجی؟
- میزان روشنایی صحنه چقدر است؟
بنچمارکهای عملکردی
انتخاب سختافزار و مدل تأثیر زیادی بر تعداد فریم در ثانیه (FPS) دارد. طبق گزارش فنی، استفاده از مدل Gemma 4 12B (بهطور خاص نسخه QAT) روی کارت گرافیک NVIDIA RTX 3090 از طریق llama.cpp، منجر به دستیابی به تقریباً ۱ فریم در ثانیه شد، در حالی که سه سؤال در هر فریم پردازش میشد.
در مقابل، تست با مدل gpt-6-luna شرکت OpenAI تنها ۰.۲ فریم در ثانیه خروجی داد. نویسنده این کندی را نه به قدرت پردازش خام مدل، بلکه به سربار اتصالهای شبکهای مجزا برای هر سؤال در هر فریم نسبت میدهد.
جزئیات پیادهسازی فنی
این سیستم از uv برای مدیریت وابستگیها و OpenCV برای دسترسی به وبکم استفاده میکند. اسکریپت تفاوتهای API بین سرویسهای محلی و ابری را به شرح زیر مدیریت میکند:
- llama.cpp:
- استفاده از اندپوینت
/chat/completions. - نیاز به تنظیم
logprobs: Trueوtop_logprobs: 1024برای نمایش گزینههای جایگزین. - تنظیم دمای مدل (
temperature) روی ۰ و تلاش استدلالی (reasoning_effort) رویnone. - اجرا با مدل با اندازه حدود ۷ گیگابایت و یک پروژکتور چندوجهی حدود ۱۷۵ مگابایت.
- استفاده از اندپوینت
- OpenAI:
- استفاده از اندپوینت
/responses. - نیاز به
top_logprobs: 20وinclude: ["message.output_text.logprobs"]برای بازیابی دادههای لازم. - تنظیم
top_p: 1برای جلوگیری از هرس کردن گزینههای جایگزین وreasoning: {"effort": "none"}.
- استفاده از اندپوینت
برای تضمین دقت، یک فرآیند نرمالسازی سختگیرانه اجرا میشود:
- محاسبه وزن: وزنها با فرمول
math.exp(logprobs[letter] - peak)محاسبه میشوند که در آن peak بیشترین logprob در بین گزینههای موجود است. - مدیریت توکنهای مفقود: توکنهایی که توسط API برگردانده نمیشوند، وزن صفر میگیرند.
- اعتبارسنجی: اگر مجموع احتمال نرمالشدهی توکنهای مفقود بیش از 1e-6 باشد، اسکریپت خطای ValueError میدهد، زیرا امتیازهای حذفشده غیرقابل چشمپوشی تلقی میشوند.
استقرار و تنظیمات فنی
برای کسانی که قصد استقرار محلی روی لینوکس با درایورهای NVIDIA را دارند، نصب curl ،zstd و uv ضروری است. این فرآیند به یک فایل باینری مستقل llama.cpp نیاز دارد که برای معماری CUDA 86 (مخصوص RTX 3090) کامپایل شده باشد.
گردش کار استقرار شامل مراحل زیر است:
۱. دانلود مدل gemma-4-12b-it-qat-q4_0.gguf و پروژکتور متناظر mmproj-gemma-4-12b-it-qat-q4_0.gguf.
۲. سرویسدهی مدل از طریق دستور llama serve --models-dir ~/models/ --port 8060.
۳. اجرای اسکریپت webcam.py برای انتقال فریمها از /dev/video0 به سرور محلی.
انعطافپذیری در برابر تخصص
مدلهای تخصصی بینایی ماشین (مانند YOLO) قطعاً برای این وظایف بهینهتر هستند، اما برتری اصلی این روش در انعطافپذیری است. کاربر میتواند شرط تشخیص را صرفاً با ویرایش یک دستور متنی ساده تغییر دهد.
نیازی به آموزش مجدد مدل یا تنظیم فایل وزنها برای افزودن یک دستهی جدید نیست. اگر بخواهید بهجای «انسانها»، «گیاهان» را تشخیص دهید، کافی است پارامترهای درخواست JSON را بهروزرسانی کنید. این اسکریپت از سه نوع سؤال پشتیبانی میکند:
- انتخابی (Choice): انتخاب بین چندین دستهی متمایز (مثلاً محیط داخلی در برابر خارجی).
- بله/خیر (Noul): یک بررسی دوگانه (True/False) که درصد احتمال را برمیگرداند.
- امتیازی (Score): یک سطح ترتیبی (مثلاً تاریک، کمنور، روشن) که یک مقدار مورد انتظار را محاسبه میکند.
این تغییر رویکرد اجازه میدهد تا نمونهسازی سریع (Rapid Prototyping) برای محرکهای بصری انجام شود. یک توسعهدهنده میتواند «تعریف» یک صحنه را در عرض چند ثانیه و با استفاده از زبان طبیعی به عنوان لایهی پیکربندی، تغییر دهد.
این روش عملاً مدل LLM را به یک طبقهبندیکننده Zero-shot (بدون نمونه) تبدیل میکند که هم بهصورت محلی برای حفظ حریم خصوصی و هم از طریق API برای مقیاسپذیری قابل استقرار است. برای توسعهدهندگان، این بدان معناست که مرز بین «هوش مصنوعی مولد» و «هوش مصنوعی تحلیلی» در حال محو شدن است. همان مدلی که شعر مینویسد، اکنون میتواند به عنوان یک حسگر پرسرعت برای یک سیستم خودکار عمل کند.
در آینده باید منتظر ادغام KV-caching در این جریانهای کاری باشیم. اگر بکاندهای سرویسدهنده بتوانند پیشوند وضعیت مشترک یک پرامپت را کش کنند، هزینه و تأخیر پردازش چندین سؤال در هر فریم باز هم کاهش خواهد یافت.
گام بعدی شما
- اگر از مدلهای محلی استفاده میکنید، کتابخانه llama.cpp را برای تست استخراج logprobs روی دادههای بصری خود نصب کنید.
- برای کاهش تأخیر در پروژههای واقعی، قابلیت KV-caching را در بکاند سرویسدهی مدل خود فعال کنید.
- ساختار پرامپتهای خود را از توصیفی به چندگزینهای تغییر دهید تا سرعت استنتاج را افزایش دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو