
برنامهنویسان اکنون میتوانند بارهای کاری تولیدی هوش مصنوعی را بدون پرداخت هزینه برای هر توکن اجرا کنند. Manifest را تصور کنید؛ یک لایه مسیریابی متنباز که به تیمها اجازه میدهد درخواستهای غیرحیاتی را از مدلهای پیشرو و گرانقیمت دور کرده و به مجموعهای منتخب از گزینههای رایگان هدایت کنند.
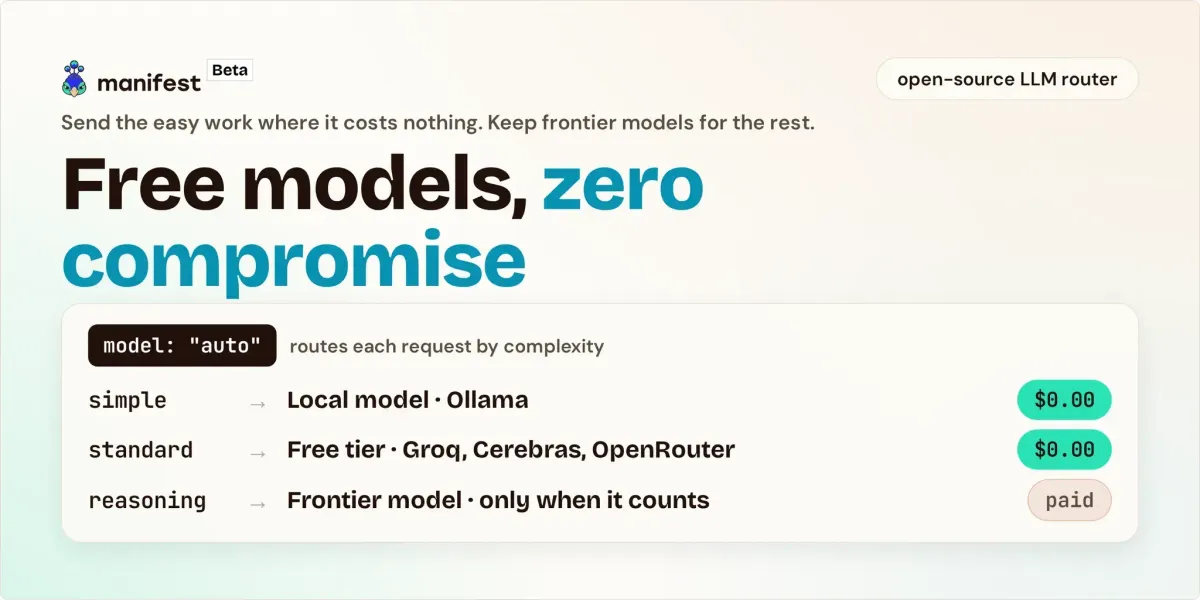
بسیاری از تیمهای هوش مصنوعی به این دلیل هزینه اضافی پرداخت میکنند که میترسند با تغییر مدل از یک مدل سطح اول (Top-tier) به یک مدل کوچکتر، کیفیت پاسخها افت کند. عبارت «رایگان» اغلب در ذهن توسعهدهندگان با «کیفیت پایینتر» مترادف است، بنابراین تیمها فقط برای اطمینان خاطر، هزینه هر درخواست را میپردازند. در واقعیت، وظایف پایه مانند خلاصهسازی تیکتها، استخراج فیلدها و طبقهبندی پیامها، نتایج تقریباً یکسانی را در اندازههای مختلف مدلها ارائه میدهند. یک مدل سریع 8B و یک مدل پیشرو، برای این وظایف پاسخ یکسانی تولید میکنند، اما تنها یکی از آنها در صورتحساب نهایی ظاهر میشود. Manifest این تضاد را با خودکارسازی تصمیم مسیریابی بر اساس پیچیدگی درخواست حل میکند. این رویکرد به ویژه در مواردی که مدلهای کوچک در مواجهه با پیچیدگیهای عملیاتی دچار چالش میشوند، اهمیت مییابد؛ همانطور که بررسی عملکرد مدل Gemma 4 2B در توابع پیچیده نشان داد، تشخیص مرز بین کارهای ساده و پیچیده کلید بهینهسازی است.
طبق اعلام سازندگان این پروژه، Manifest تا تاریخ ۲ ژوئیه ۲۰۲۶، فهرستی از بیش از ۱۰۰ مدل رایگان از دهها ارائهدهنده مختلف را بهروزرسانی میکند. این کاتالوگ ایستا نیست؛ بلکه یک لیست متنباز است که هر روز یکبار همگامسازی (Sync) میشود تا ظهور و disappearance لایههای رایگان را ردیابی کند. این مدلها در دو دستهبندی متمایز قرار میگیرند:
استنتاج محلی
استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه خودِ آشپزی است نه دورهی آموزش آشپز — بر روی سختافزار خصوصی، هزینهی هر توکن را حذف کرده و حریم خصوصی دادهها را تضمین میکند. Manifest سرورهای محلی را دقیقاً به همان روشی متصل میکند که به هر ارائهدهنده دیگر متصل میشود و از موارد زیر پشتیبانی میکند:
- Ollama
- LM Studio
- llama.cpp
- هر سرور دیگری که با استاندارد OpenAI سازگار باشد.
مدلهای محلی منحصربهفرد هستند زیرا هزینه نهایی آنها تنها به برق مصرفی محدود میشود. از آنجایی که پرامپت (Prompt) هرگز دستگاه را ترک نمیکند، کل فرآیند کاملاً خصوصی است. برای کسانی که به دنبال پیادهسازی کامل این ساختار هستند، راهنمای استقرار محلی Qwen3-Coder با استفاده از Ollama ابزارهای لازم برای رسیدن به هزینه صفر توکن را فراهم میکند. علاوه بر این، هیچ محدودیت نرخی (Rate Limit) وجود ندارد زیرا شما سهمیه خود را با غریبهها شریک نمیشوید. نکته کلیدی این است که شما به سختافزار نیاز دارید و یک مدل محلی کوچک، رقیب مدل Opus نیست؛ به همین دلیل نباید سختترین کارها را به آن سپرد.
لایههای رایگان ابری
طبق گزارش مستندات Manifest، این سیستم چندین ارائهدهنده ابری رایگان با عملکرد بالا را ردیابی میکند که بسیاری از آنها برای شروع نیازی به کارت اعتباری ندارند. نقاط برجسته عبارتند از:
- Groq: ارائه مدلهای Llama 3.3 70B و Llama 3.1 8B بر روی سختافزارهای فوقسریع.
- Cerebras: توانایی ارسال تقریباً ۲۶۰۰ توکن در ثانیه.
- OpenRouter: ارائه بیش از ۳۵ مدل با پسوند ':free'، شامل DeepSeek R1 و Qwen3 Coder.
- NVIDIA NIM: granting access به بیش از ۱۰۰ مدل از طریق برنامه توسعهدهندگان خود.
- لایههای رایگان Google Gemini 2.5 Flash و برنامه آزمایشی (Experiment plan) شرکت Mistral.
مسیریابی به این دلیل ضروری است که لایههای رایگان با محدودیتهای عملیاتی همراه هستند. بسیاری از ارائهدهندگان کاربران را به چند ده درخواست در دقیقه یا چند صد درخواست در روز محدود میکنند. برخی ارائهدهندگان همچنین پنجره متنی (Context Window) — یعنی میزان متنی که مدل همزمان در ذهن نگه میدارد، شبیه میز کاری که فقط جای چند ورق دارد — را در طرح رایگان محدود میکنند. در این فضای رقابتی، تقابل OpenModels و OpenRouter نشان میدهد که شفافیت در هزینهها و دسترسی به مدلها چگونه به ابزار اصلی رقابت در سال ۲۰۲۶ تبدیل شده است.
حریم خصوصی دادهها و حقوق استفاده نیز بسته به ارائهدهنده متفاوت است:
- گوگل صراحتاً ذکر میکند که پرامپتهای رایگان Gemini ممکن است برای بهبود محصولاتش مورد استفاده قرار گیرند.
- برخی از کلیدهای آزمایشی (Trial keys) برای کارهای تجاری مجاز نیستند.
موتور مسیریابی Manifest این هشدارها را روی هر ارائهدهنده علامتگذاری میکند. این امر تضمین میکند که کارهای ساده و غیرحساس به لایههای رایگان بروند، در حالی که هر مورد خصوصی در یک مدل محلی باقی بماند تا هیچ دادهای از دستگاه خارج نشود.
این رویکرد، زیرساخت هوش مصنوعی را از وابستگی به یک مدل واحد به یک استراتژی لایهبندی شده تبدیل میکند. با تنظیم مدلها روی حالت 'auto' از طریق یک نقطه اتصال (Endpoint) واحد، توسعهدهندگان دیگر اپلیکیشنهای خود را مستقیماً به ارائهدهندگان منفرد مانند Groq یا Ollama متصل نمیکنند. Manifest هر درخواست را امتیازدهی کرده و مسیریابی میکند. توسعهدهندگان میتوانند یک مدل محلی یا رایگان را به لایههای «ساده» و «استاندارد» اختصاص دهند یا آنها را به عنوان جایگزین (Fallback) لیست کنند، تا ترافیک آسان بدون نیاز به تغییر مجدد در کد، هزینهای ایجاد نکند.
این سیستم یک جعبه سیاه نیست. هر پاسخ حاوی سرآیندهایی (Headers) است که نشان میدهد کدام مدل پاسخ داده، در کدام لایه قرار گرفته، کدام ارائهدهنده آن را سرویس داده و چرا این مسیر انتخاب شده است. این شفافیت به تیمها اجازه میدهد دقیقاً ببینند چه مقدار از ترافیک آنها به صورت رایگان اجرا شده است.
برای کاربر نهایی یا توسعهدهنده، این بدان معناست که صورتحساب دیگر منعکسکننده کل ترافیک نیست، بلکه تنها ترافیکی است که واقعاً نیاز به یک مدل پیشرو داشته است. زیرساخت از یک هزینه ثابت به ازای هر درخواست، به یک سیستم پویا تبدیل میشود که در آن تنها سختترین مسائل هزینه دارند. محدودیتهای هر گزینه دیگر مشکلساز نیستند زیرا هر درخواست جایی فرود میآید که بهترین تناسب را با آن داشته باشد.
برای شروع بهینهسازی هزینهها، توسعهدهندگان میتوانند کاتالوگ زنده را بررسی کرده و اولین ارائهدهنده رایگان خود را در manifest.build/free-models متصل کنند.
گام بعدی شما
- فهرست مدلهای رایگان را در manifest.build/free-models بررسی کنید.
- درخواستهای ساده (مانند استخراج داده) را به مدلهای محلی یا رایگان منتقل کنید.
- برای دادههای حساس، مسیرهای ابری رایگان را حذف و فقط از استنتاج محلی استفاده کنید.
اما داستان سختافزاری این تحولات حتی شگفتانگیزتر است؛ به بررسی ما دربارهی تراشههای Blackwell و اثر آنها بر هزینه استنتاج مراجعه کنید.



گفتگو