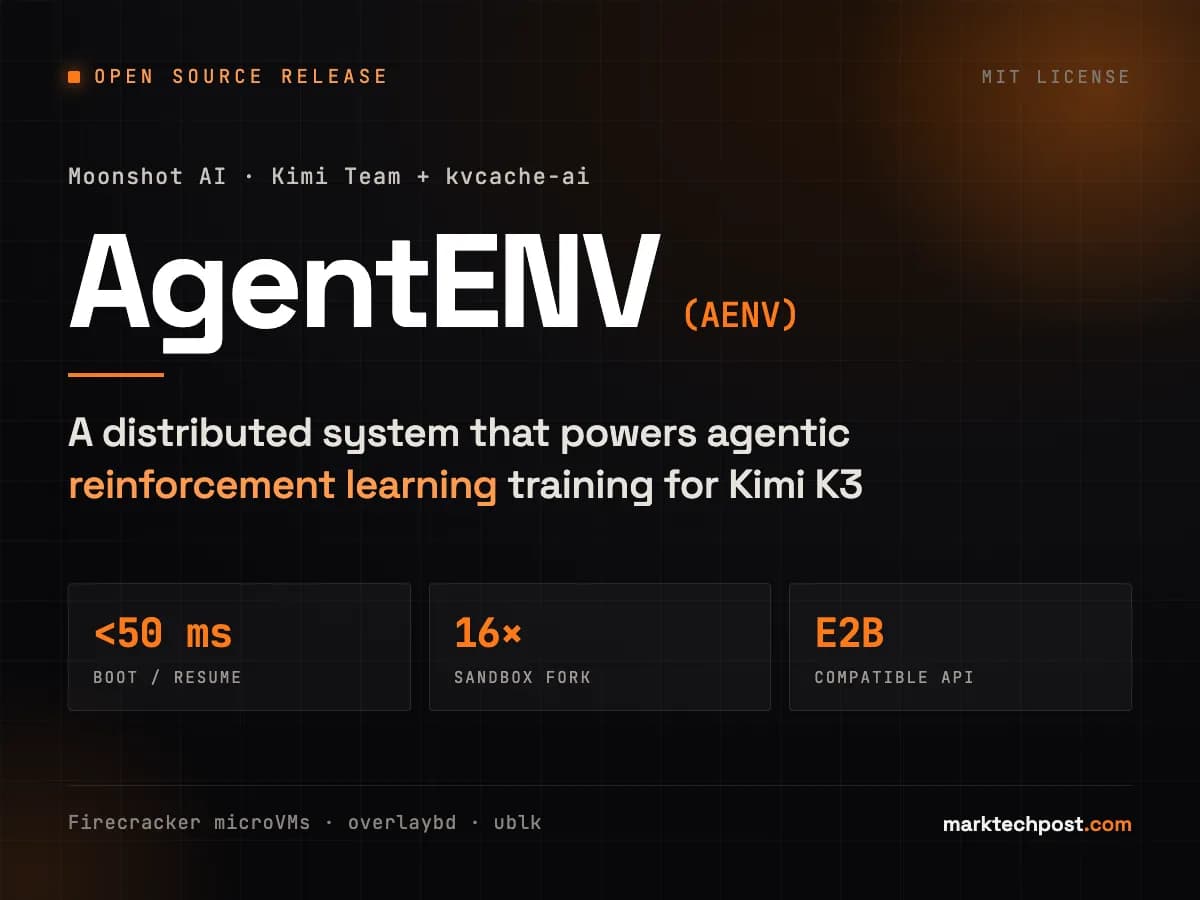
تصور کنید برای هر بار آزمایش یک مدل هوش مصنوعی، نیاز داشته باشید یک کامپیوتر کامل را در کمتر از ۵۰ میلیثانیه روشن کنید و سپس آن را دور بریزید. اگر در حال آموزش مدلهای عظیم هستید، این تنها راه دستیابی به امنیت و مقیاسپذیری در محیطهای واقعی است.
آموزش عاملهای هوش مصنوعی (AI Agents) در مقیاس صنعتی، برخلاف تولید متن ساده، نیازمند زیرساختی است که برای هر اجرای مدل، یک محیط کامپیوتری امن و یکبارمصرف فراهم کند. این نیاز به محیطهای ایزوله، بهویژه زمانی که عاملها در قالب سیستمهای پیچیده و چندگانه برای اتوماسیون فرآیندهای تجاری به کار میروند — مانند آنچه در رویکرد پلتفرم AgentCrew برای خودکارسازی بازاریابی محتوایی مشاهده میشود — اهمیت دوچندانی مییابد. برای حل این چالش، تیم Kimi از شرکت Moonshot AI و مجموعه kvcache-ai سامانه AgentENV (AENV) را به صورت متنباز (تحت لایسنس MIT) عرضه کردند. این پلتفرم توزیعشده، زیربنای یادگیری تقویتی (Reinforcement Learning) برای مدل Kimi K3 است؛ مدلی با ۲.۸ تریلیون پارامتر که بر پایه معماری ترکیب خبرهها (Mixture-of-Experts) طراحی شده است. کد این پروژه به طور کامل تحت لایسنس MIT منتشر شده است تا توسعهدهندگان بتوانند از آن استفاده کنند.
در دنیای واقعی، یادگیری تقویتیِ عاملمحور با یک تضاد سخت روبروست: سرعت در برابر امنیت. کانتینرها سریعاند اما بهدلیل اشتراک هسته (Kernel)، برای اجرای کدهای تولیدشده توسط مدل ریسک امنیتی دارند. در مقابل، ماشینهای مجازی (VM) ایزولاسیون کامل میبخشند اما برای مقیاسهای آموزشی، بیش از حد کند و حافظهبر هستند. با تکیه بر منطق سیستمهای توزیعشده با کارایی بالا — مشابه معماریهایی که زمان پرسوجوهای بزرگ (Big Query) را از ۴۰ دقیقه به ۹۰ ثانیه کاهش دادند — AgentENV این شکاف را با استفاده از MicroVMهای Firecracker پر کرده است.
زمینه و ضرورت زیرساختی
یادگیری تقویتی عاملمحور مستلزم آن است که مدل درون یک کامپیوتر واقعی عمل کند. هر بار اجرای مدل (Rollout) نیازمند یک محیط لینوکسی ایزوله است که دارای سیستم فایل، پشته شبکه (Network Stack) و فرآیندهای زنده باشد. هدف AgentENV پر کردن شکاف بین کانتینرها و ماشینهای مجازی است تا عملیاتهای «بیکار ماندن» (Idle)، «راهاندازی مجدد» (Restart) و «شاخهبندی» (Branching) به اندازه کافی ارزان شوند که بتوان آنها را در مقیاس آموزش مدلهای عظیم اجرا کرد.
طبق مستندات فنی ارائه شده توسط kvcache-ai، معماری این سامانه بر چندین مکانیسم سطحبالا استوار است:
معماری فنی
- ایزولاسیون: هر محیط آزمایش (Sandbox) یک MicroVM با هسته لینوکس، سیستم فایل و فضای شبکه مستقل است. این ساختار تضمین میکند که کدهای مخرب یا اشتباه مدل به سیستم میزبان آسیب نزنند.
- ذخیرهساز: سیستم فایل ریشه (Rootfs) از طریق دستگاههای بلوکی ublk در فضای کاربر و لایههای overlaybd ارائه میشود. لایههای پایه فقط-خواندنی (Read-only) بین محیطها مشترکاند، در حالی که هر محیط تغییرات خود را در لایه بالایی (Upper Layer) مخصوص به خود مینویسد.
- مدیریت حافظه: برای جلوگیری از اتلاف منابع، سامانه از Memory Ballooning استفاده میکند تا حافظه مهمان قابل بازیابی را به میزبان بازگرداند. این کار باعث حفظ قابلیت Overcommit میشود، زیرا محیطها در طول زمان از یکدیگر فاصله میگیرند (Diverge). همچنین حافظه کشِ میزبان بین دادههای ذخیرهسازی و دادههای Snapshotهای حافظه مشترک است.
- لایه کنترل: یک API مبتنی بر Axum درخواستها را به ارکستراتوری که چرخه حیات Sandboxها را مدیریت میکند، میفرستد. یک دیمون به نام envd وظیفه اجرای دستورات، عملیات فایل و گزارش وضعیت سلامت را روی پورت ۴۹۹۸۳ بر عهده دارد.
- شبکه: یک Reverse Proxy ترافیک HTTP و WebSocket را از کلاینتها به سرویسهایی که درون ماشین مجازی (VM) در حال اجرا هستند، هدایت میکند.
مکانیسمهای Snapshot، توقف و فورک
ارزش اصلی AgentENV در کارایی خیرهکننده عملیات Snapshot و Fork است. این سیستم بهجای نوشتن کامل تصویر هر بار، تغییرات حافظه و سیستم فایل را بهصورت افزایشی (Incremental) ثبت میکند.
- شاخصهای عملکرد: محیطهای مبتنی بر Snapshot در کمتر از ۵۰ میلیثانیه بوت یا بازیابی میشوند. عملیات متوقفسازی (Pause) کمتر از ۱۰۰ میلیثانیه زمان میبرد. ثبت Snapshotهای افزایشی نیز حتی در زمان تغییرات شدید دیسک، زیر ۱۰۰ میلیثانیه تکمیل میشود.
- قابلیت Fork: یک Sandbox در حال اجرا میتواند به ۱۶ فرزند مستقل در یک گره واحد کلون شود. منبع اصلی در طول عملیات کپچر برای مدت کوتاهی متوقف شده و سپس ادامه مییابد. هر فرزند، سیستم فایل، حافظه و پیکربندی منابع منبع را به ارث میبرد.
- گردش کار RL: این قابلیت به توسعهدهندگان اجازه میدهد مراحل گرانقیمت — مانند نصب وابستگیها یا کلون کردن یک مخزن کد — را فقط یکبار انجام دهند. سپس آن وضعیت خاص به صورت موازی برای اجراهای متعدد (Parallel Rollouts) شاخهبندی میشود، بدون اینکه هزینه زمانی نصب دوباره پرداخت شود.
ذخیرهساز و توزیع
اسنپشاتها در ذخیرهسازهای شیگرا سازگار با S3 یا یک سیستم فایل توزیعشده مشترک ذخیره میشوند. برای ذخیرهسازهای مشترک، مستندات حداقل پهنای باند ۱ گیگابیت بر ثانیه را لازم میدانند و به شدت ۱۰ گیگابیت یا بیشتر را توصیه میکنند.
تصاویر از طریق overlaybd بهصورت On-demand (در لحظه نیاز) بارگذاری میشوند. دیسک محلی بهعنوان یک کش محدود عمل میکند که دادههای «داغ» را نگه داشته و دادههای «سرد» را حذف میکند؛ این یعنی مجموعه تصاویر قابل دسترس میتواند از ظرفیت فیزیکی دیسک محلی فراتر رود.
وضعیت Snapshotها در سه لایه سازماندهی شده است:
۱. یک فضای کاری Stage برای آرتیفکتها در زمان ساخت (Build).
۲. یک مخزن اسنپشات تایید شده (Committed) به عنوان منبع حقیقت ماندگار.
۳. یک کش زمان اجرا در سطح گره (Node-local) برای پیکربندیهای مشتق شده در زمان لانچ.
دو بکاند برای مخزن پشتیبانی میشود: posix_fs (پیشفرض) و oss. مسیر oss نیازمند تعیین صریح منطقه (Region) است. یک انتقال Peer-to-Peer اختیاری بر پایه iroh میتواند آرتیفکتهای تایید شده را به گرههای همسایه معرفی کند، هرچند این قابلیت به طور پیشفرض غیرفعال است و مدل اسنپشات تایید شده را تغییر نمیدهد.
چرخه حیات و سازگاری
هر Sandbox دارای یک TTL (زمان تا زندگی) است. به طور پیشفرض، انقضای زمان باعث توقف (Pause) میشود و نه حذف. برای فعال کردن حذف کامل، کاربران باید مقدار autoPause: false را در API ایجاد ارسال کنند.
برای تسهیل پذیرش، AgentENV یک API سازگار با E2B ارائه میدهد. این یعنی تیمهایی که در حال حاضر از SDKهای پایتون یا تایپاسکریپت E2B استفاده میکنند، میتوانند متغیر E2B_API_URL را به سرور خودشان تغییر دهند و بدون دست زدن به کد عامل (Agent)، زیرساخت خود را میزبانی کنند (Self-hosting). همچنین یک CLI بومی به نام aenv برای گردش کارهای خاص ارائه شده است.
مسیرهای استقرار
استقرار این سیستم نیازمند هسته لینوکس ۶.۸ به بالا و دسترسی به /dev/kvm است. اسکریپت نصب بهطور خاص به اوبونتو ۲۴.۰۴ نیاز دارد. در حالی که سرور فقط مخصوص لینوکس است، CLI آن (aenv) از لینوکس و macOS روی معماریهای x86_64 و arm64 پشتیبانی میکند. پنج مسیر استقرار مستند شده است:
- یک اسکریپت نصب که سرور را به عنوان سرویس systemd اجرا میکند.
- یک تصویر داکر از طریق
ghcr.io/kvcache-ai/aenv-server. - یک استک Docker Compose برای شبیهسازی کلاسترهای چند-گرهه.
- مانیفستهای کوبرنتیز (Kubernetes) شامل Gateway، Scheduler و Node DaemonSet.
- مسیر ساخت از سورس با استفاده از Toolchain زبان Rust.
در استقرارهای چند-گرهه، یک Gateway روی پورت ۸۰۸۰ و یک Scheduler روی پورت ۹۰۹۰ قرار میگیرند.
از دیدگاه فنی، این رویکرد این فرض قدیمی را که «ایزولاسیون در سطح هسته برای حلقههای RL بیش از حد کند است» باطل میکند. Moonshot AI با تبدیل محیط به یک «وضعیت قابل ذخیره» (Snapshot-able State) بهجای یک «فرآیند بوت»، هزینه آمادهسازی محیط را از هزینه اجرای rollout جدا کرد. این امر اجازه میدهد آموزشهای متراکمتر و امنتری برای عاملهایی که باید با سیستمهای فایل و شبکههای زنده تعامل داشته باشند، انجام شود.
پژوهشگران و توسعهدهندگان اکنون میتوانند به کد منبع کامل تحت لایسنس MIT در گیتهاب دسترسی داشته باشند تا کلاسترهای آموزشی عامل-محور خود را مستقر کنند.
گام بعدی شما
- اگر در حال توسعه عاملهای کدنویسی هستید، مستندات لایسنس MIT این پروژه در گیتهاب را بررسی کنید.
- برای استقرار، نسخهی اوبونتو ۲۴.۰۴ و دسترسی به
/dev/kvmرا پیشنیاز قرار دهید. - قابلیت سازگاری با E2B را برای مهاجرت از سرویسهای ابری به میزبانی شخصی (Self-hosting) به کار بگیرید.
اما داستان بهینهسازی حافظه در مدلهای تریلیونی هنوز تمام نشده است؛ اثر این معماری بر کاهش تأخیر استنتاج را در گزارش بعدی بررسی خواهیم کرد.



گفتگو