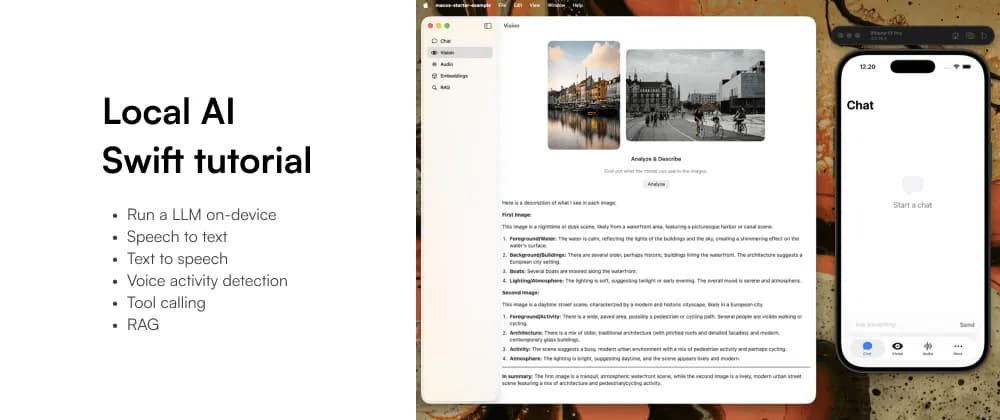
تصور کنید اپلیکیشنی میسازید که حتی در حالت هواپیما هم با سرعت برقآسا پاسخ میدهد و هیچ دادهای از کاربر را به سرورهای خارجی نمیفرستد. با معرفی NobodyWho، این سناریو برای توسعهدهندگان سختافزارهای اپل از یک رویا به یک واقعیت فنی تبدیل شده است.
این کتابخانه با حذف وابستگی به APIهای ابری و هزینههای سنگین سرور، اجازه میدهد عاملهای هوش مصنوعی (AI Agents) — شبیه به دستیاران دیجیتالی که میتوانند بهطور مستقل تصمیم بگیرند و ابزارها را اجرا کنند — بهطور کامل روی دستگاه کاربر مستقر شوند. این رویکرد در واقع گامی عملی در جهت سپردن کنترل سختافزاری دستگاههای موبایل به عاملهای هوش مصنوعی است تا تعامل با محیط فیزیکی و دیجیتال تسهیل شود. نتیجه این تغییر، پاسخهایی با تأخیر صفر و حریم خصوصی مطلق است، زیرا اطلاعات کاربر هرگز از حافظه فیزیکی دستگاه خارج نمیشود.
این چرخش به سمت اجرای محلی، بخشی از روند گستردهتر «اول-آفلاین» در دنیای AI است. همانطور که در تحلیل قبلی ما دربارهی مدلهای همراهِ محلی (Local Waifu) اشاره کردیم، تقاضا برای هوش مصنوعی بدون سانسور، خصوصی و همیشه در دسترس، محرک اصلی این تحول است. برای کاربر نهایی، این یعنی داشتن هوشی که در حالت هواپیما کار میکند و برای استنتاج (Inference) نیازی به پرداخت اشتراک ماهانه ندارد.
ضرورت هوش مصنوعی روی دستگاه
اکثر قابلیتهای فعلی AI بر پایه مدلهای ابری هستند؛ یعنی درخواست به سرور میرود، مدل اجرا میشود و پاسخ بازمیگردد. طبق گزارشهای فنی، این ساختار چهار چالش اساسی ایجاد میکند که اجرای محلی آنها را حل میکند:
- عملکرد آفلاین: هیچ اتصال اینترنتی برای کارکرد هوش مصنوعی مورد نیاز نیست.
- حریم خصوصی ذاتی: دادههای کاربر هرگز دستگاه فیزیکی را ترک نمیکنند.
- تأخیر بسیار کم: تأخیر ناشی از رفتوبرگشت دادهها در شبکه (Network Round-trip) حذف میشود.
- هزینه صفر ابری: فرآیند استنتاج برای توسعهدهنده و کاربر کاملاً رایگان است.
این چالشها در واقع هستهی اصلی تقابل حریم خصوصی و نیاز به سختافزار در پردازشهای محلی در برابر ابری هستند که مسیر توسعه اپلیکیشنهای مدرن را تعیین میکنند. البته یک موازنه وجود دارد: مدلهای محلی کوچکتر و از نظر توانمندی خام، ضعیفتر از مدلهای پیشرو (Frontier Models) در ابر هستند. با این حال، برای کارهایی مثل خلاصهسازی، چتباتهای تخصصی یا جستوجوی محلی، این مدلها بیش از حد کافی هستند.
بر اساس مستندات فنی منتشر شده در ۱ سپتامبر ۲۰۲۶، NobodyWho در واقع یک پوشش (Wrapper) مبتنی بر زبان Rust برای لاماسیپلاسپلاس (llama.cpp) است. این ابزار یک API تمیز در زبان Swift ارائه میدهد که از هر مدلی با فرمت .gguf در سیستمعاملهای iOS، macOS، visionOS و watchOS پشتیبانی میکند. توسعهدهندگان میتوانند این ابزار را از طریق Swift Package Manager و مخزن گیتهاب nobodywho-ooo/nobodywho-swift یا با افزودن آن به فایل Package.swift با نسخه 2.1.0 اضافه کنند.
مدیریت مدل و مکانیزم چت
یکی از نقاط قوت این کتابخانه، مدیریت خودکار مدلهاست. بهجای گنجاندن فایلهای حجیم در بدنه اپلیکیشن (Binary)، NobodyWho میتواند مدلهای GGUF را مستقیماً از Hugging Face دانلود کرده، در دایرکتوری حافظه موقت (Cache) پلتفرم ذخیره کند و در اجراهای بعدی از آنها استفاده کند.
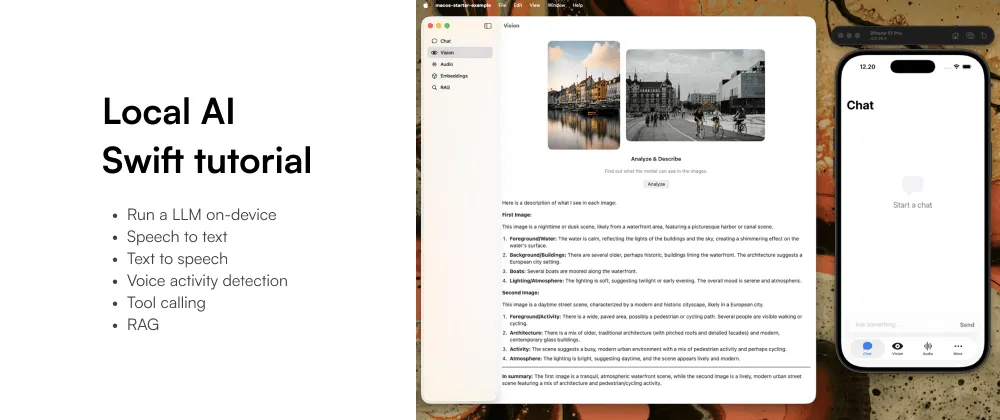
توسعهدهندگان میتوانند مسیر مدل (modelPath) را به سه روش تعریف کنند:
- ارجاع به Hugging Face: با استفاده از فرمت
hf://owner/repo/file.gguf(که به حروف بزرگ و کوچک حساس نیست و عبارتhuggingface://نیز کار میکند). این مدلها در اولین استفاده دانلود و کش میشوند. - لینک HTTPS: لینکهای مستقیم به فایلهای
.ggufکه آنها نیز دانلود و ذخیره میشوند. - مسیر محلی: آدرسهای مستقیم به فایلهای موجود روی دستگاه که بدون دانلود، مستقیماً استفاده میشوند.
برای ردیابی دانلودهای از راه دور، توسعهدهندگان میتوانند یک Closure پیشرفت (Progress Closure) را به Chat.fromPath پاس دهند که تعداد بایتهای دانلود شده و کل حجم فایل را ارائه میدهد. این Closure برای فایلهای محلی یا کش شده بهطور خودکار نادیده گرفته میشود.
برای تعاملات پایه، این کتابخانه از شیء Chat استفاده میکند. فراخوانی ساده chat.ask("Is water wet?").completed() پاسخ نهایی را برمیگرداند. اما نکته فنی اینجاست که chat.ask() در واقع یک توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه تولید میکند — را بهصورت جریانی (Stream) برمیگرداند که با AsyncSequence سازگار است. این قابلیت باعث میشود پاسخها بهصورت لحظهای در رابط کاربری ظاهر شوند و کاربر با «اثر صفحه سفید» که در رابطهای غیر جریانی رایج است، مواجه نشود.
اگر کاربر بخواهد پاسخ را متوقف کند، متد chat.stopGeneration() این وقفه را بهصورت همزمان (Synchronous) مدیریت میکند. فراخوانی این متد از هر Thread ای ایمن است؛ توکنهایی که پیش از توقف تولید شدهاند در جریان و تاریخچه چت باقی میمانند تا انسجام گفتگو حفظ شود.
قابلیتهای چندوجهی و صوتی
این کتابخانه فراتر از متن، از مدلهای چندوجهی (Multimodal) — مدلی که همزمان متن، عکس و صدا را میفهمد — پشتیبانی میکند. برای پیادهسازی این قابلیت، توسعهدهنده باید علاوه بر مدل زبانی اصلی (LLM)، یک مدل تصویرساز یا پروژکشن (Projection Model) را نیز ارائه دهد (که معمولاً با mmproj نامگذاری میشود) تا رسانهها را به توکنهایی تبدیل کند که LLM قادر به درک آنها باشد. در این زمینه، مدل Gemma 4 با مدل پروژکشن BF16 به عنوان یک گزینه استاندارد و قابلاعتماد پیشنهاد شده است.
برای ارسال محتوای چندوجهی، توسعهدهندگان یک Prompt میسازند که ترکیبی از متن، تصاویر و صدا است. برای مثال، یک پرامپت میتواند دستور متنی را با مسیر یک فایل .png و یک فایل صوتی .mp3 ترکیب کند. از آنجایی که تصاویر و صداها فضای «پنجره بافت» (Context Window) را بهسرعت اشغال میکنند، توصیه میشود توسعهدهندگان از contextSize بزرگتری نسبت به چتهای متنی استفاده کنند. همچنین بسیار حیاتی است که مدل زبانی و مدل پروژکشن بهصورت مشترک آموزش دیده باشند.
پردازش صوت نیز از طریق سه خط لوله مجزا انجام میشود:
- تبدیل گفتار به متن (STT): ادغام مدلهای Whisper در فرمت ONNX. این بخش از تبدیل فایلها از طریق
transcribeFileو پردازش بافرهای خام PCM از طریقtranscribePcmپشتیبانی میکند. بافر باید شامل نمونههای mono i16 PCM باشد؛ اگرچه نرخ نمونهبرداری (Sample Rate) میتواند متفاوت باشد، اما NobodyWho بهطور داخلی آن را برای برآورده کردن نیازهای Whisper بازنمونهبرداری (Resample) میکند. تبدیل متن میتواند تکهتکه استریم شود یا بهصورت یک نتیجه کامل دریافت گردد. - تبدیل متن به گفتار (TTS): پشتیبانی از معماریهای Kokoro، Pocket TTS و Supertonic برای سنتز متن به فایلهای صوتی WAV. کتابخانه معماری را از روی رشته ورودی تشخیص میدهد، مگر اینکه از یک پوشه محلی سفارشی بارگذاری شود. هر معماری به گزینههای خاص صدا و زبان نیاز دارد (مثلاً صدای
bf_emmaو زبانen-gbبرای Kokoro). - تشخیص فعالیت صوتی (VAD): استفاده از مدل Silero-VAD برای تشخیص تفاوت بین گفتار و سکوت. برای ورودیهای میکروفون در لحظه، توسعهدهندگان تکههای صوتی را به VAD میفرستند و سیستم وضعیتهایی مانند
.speechStarted،.speech،.silenceیا.speechEndedرا گزارش میکند. متدfinish()قطعه گفتار بافر شده را برمیگرداند و وضعیت را ریست میکند. برای ضبطهای موجود، متدsegmentمیتواند قطعات گفتار را در یک گذر واحد استخراج کند.
حساسیت VAD از طریق پارامترهایی مانند threshold ،minSpeechDurationMs ،minSilenceDurationMs و prerollDurationMs (که از قطع شدن ابتدای جملات جلوگیری میکند) بهشدت قابل تنظیم است و توصیه میشود برای محیطهای خاص بهینهسازی شود.
منطق پیشرفته: فراخوانی ابزار و RAG
برای تبدیل چت ساده به یک ابزار کاربردی، NobodyWho از طریق ماکروی @DeclareTool امکان فراخوانی تابع (Tool Calling) را فراهم میکند. این یعنی مدل میتواند توابع واقعی Swift را درون اپلیکیشن اجرا کند. با افزودن یک توصیف به یک تابع در سطح Top-level یا عضو یک Type، این ماکرو یک متغیر ابزار تولید میکند (مثلاً تابع circleArea به circleAreaTool تبدیل میشود). برای ابزارهایی که نیاز به ثبت وضعیت محلی (Local State Capture) دارند، توسعهدهندگان باید بهجای ماکرو از مقداردهنده دستی Tool استفاده کنند.
همه مدلها ابزارها را بهطور یکسان مدیریت نمیکنند؛ خانواده مدلهای Qwen بهدلیل قابلیت اطمینان بالا توصیه شدهاند. برای مثال، توسعهدهنده میتواند تابعی برای محاسبه مساحت دایره تعریف کند و مدل زمانی که کاربر درخواستی برای محاسبات هندسی دارد، آن تابع را فراخوانی میکند.
همچنین برای متصل کردن هوش مصنوعی به دادههای خصوصی، این کتابخانه ابزارهای لازم برای تولید بازیابیافزا (RAG) را فراهم کرده است. این فرآیند شامل سه مرحله است:
۱. رمزگذاری (Encoding): استفاده از Encoder برای ایجاد بردار معنایی (Embedding) برای پرسش و پایگاه دانش (مثلاً با استفاده از encodeBatch).
۲. جستوجوی شباهت: محاسبه شباهت کسینوسی (Cosine Similarity) بین بردار پرسش و بردارهای اسناد.
۳. بازرتبهبندی (Reranking): استفاده از CrossEncoder برای رتبهبندی و مرتبسازی دقیقترین کاندیدها پیش از ارسال آنها به پرامپت سیستمی چت.
موازنه فنی و تغییر پارادایم
استقرار محلی، پیشفرضهای توسعه اپلیکیشنهای AI را تغییر میدهد. دیگر بحث مدیریت کلیدهای API و نگرانی از هزینه هر توکن مطرح نیست؛ در عوض، توسعهدهنده باید روی مدیریت حافظه RAM و کوانتیزاسیون (Quantization) — یعنی فشردهسازی وزنهای مدل برای اشغال فضای کمتر — تمرکز کند. در این معماری، گلوگاه از پهنای باند شبکه به قدرت واحد پردازش عصبی (Neural Engine) و حافظه RAM دستگاه منتقل میشود.
برای کسانی که قصد پیادهسازی این ویژگیها را دارند، کتابخانه نمونههای اولیه (Starter Examples) برای iOS و macOS ارائه داده است تا انتقال از AI وابسته به ابر به AI اول-محلی تسریع شود. برای مشاهده این قابلیت در عمل، توسعهدهندگان باید مدل Qwen_Qwen3-0.6B-GGUF/Qwen_Qwen3-0.6B-Q4_K_M.gguf را برای تست تعادل بین سرعت و استدلال در سختافزارهای قدیمیتر اپل امتحان کنند.
گام بعدی شما
- اگر توسعهدهنده Swift هستید، کتابخانه NobodyWho را از گیتهاب نصب کرده و با مدلهای کوچک (زیر ۳ میلیارد پارامتر) شروع کنید.
- برای تست تعادل بین سرعت و استدلال در سختافزارهای قدیمیتر اپل، مدل
Qwen3-0.6B-Q4_K_M.ggufرا امتحان کنید. - قابلیت RAG محلی را برای مدیریت اسناد خصوصی کاربر بدون ارسال آنها به ابر پیادهسازی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک اینکه تراشههای جدید اپل چگونه این مدلها را شتابدهی میکنند، به تحلیل ما درباره معماری NPUهای سری M مراجعه کنید.



گفتگو