تصور کنید یک مدل ۲۷ میلیارد پارامتری را روی لپتاپ خود اجرا میکنید، اما بهجای کندی همیشگی، سرعت پاسخدهی یک سرور صنعتی را تجربه میکنید. oMLX با تغییر معادلات سختافزاری و تجمیع منابع چندین مک، این رویای توسعهدهندگان را به واقعیت تبدیل کرده است.
طبق گزارشی که در ۲۶ اوت ۲۰۲۶ منتشر شد، این چارچوب به برنامهنویسان اجازه میدهد از چتباتهای ساده فراتر رفته و میزبانهای مدل شخصی با توان عملیاتی (Throughput) — شبیه به یک اتوبان چندبانده که اجازه میدهد خودروهای بیشتری در هر ثانیه عبور کنند — را مدیریت کنند. استنتاج محلی پیش از این با مدیریت حافظه دستوپنجه نرم میکرد و اغلب مجبور بود پرامپتها را از ابتدا محاسبه کند. همانطور که در تحلیل قبلی ما دربارهی اجرای مدلهای چندوجهی با هارنس DeepSeek اشاره کردیم، صنعت اکنون به سمت بکاندهای تخصصی برای گردشهای کاری عاملمحور (Agentic) حرکت میکند. برای یک توسعهدهنده، این تغییر شبیه جابهجایی از یک آپارتمان مشترک به یک مرکز داده اختصاصی در خانه است.
معماری oMLX
oMLX یک سرور مبتنی بر FastAPI است که روی چارچوب MLX اپل بنا شده است. این سیستم بهجای صفبندی خطی درخواستها، از یک استخر موتور و مدیریت KV Cache (حافظه کلید-مقدار) — شبیه به یک دفترچه یادداشت سریع که مدل برای جلوگیری از تکرار محاسبات، تکههای متن قبلی را در آن مینویسد — بهصورت پجینگ (Paged) استفاده میکند. این رویکرد برای بهینهسازی سرعت استنتاج حیاتی است و جزئیات فنی مدیریت حافظه KV و نقش آن در کاهش تأخیر را در تحلیلهای پیشین بررسی کردهایم. این معماری دقیقاً از رویکرد vLLM در مقیاس صنعتی الگوبرداری شده است.
این طراحی بهطور خاص برای ابزارهایی مثل Claude Code، Cursor و Codex CLI که به پنجرههای زمینه (Context Window) — مثل میز کاری بزرگی که اجازه میدهد چندین سند را همزمان باز نگه دارید — بسیار گسترده نیاز دارند، بهینه شده است. oMLX برای جلوگیری از اتلاف منابع، مکانیزمهای اشتراکگذاری پیشوند و کپی-در-زمان-نوشتن (Copy-on-Write) را پیاده کرده است.
مکانیزمهای حافظه لایهای
این سامانه برای حفظ عملکرد از یک استراتژی حافظه لایهای استفاده میکند:
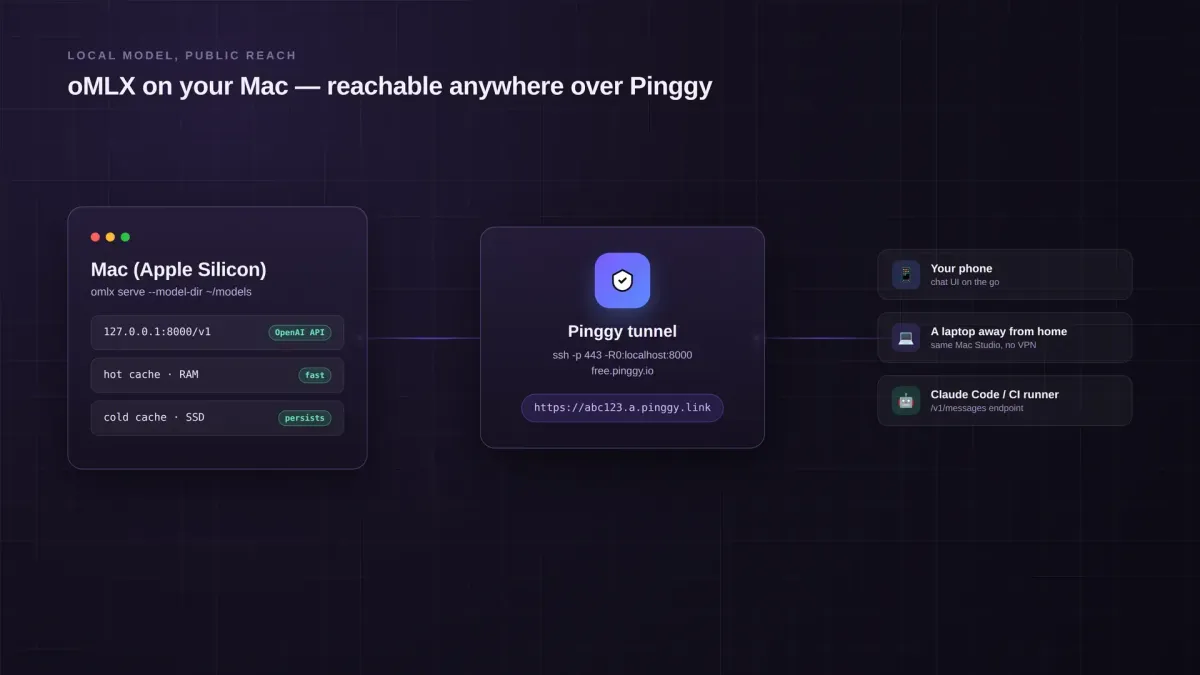
- لایه گرم (Hot Tier): بلوکهای زمینهای که اخیراً استفاده شدهاند را برای بازیابی فوری در RAM ذخیره میکند.
- لایه سرد (Cold Tier): بلوکهای کمکاربرد را با فرمت تخصصی safetensors روی SSD منتقل میکند.
به نقل از مستندات پروژه، چون حافظه سرد روی دیسک قرار دارد، زمینه (Context) حتی پس از ریاستارت سرور باقی میماند. این ویژگی مانع از افت عملکرد در تسکهای طولانیمدت عاملها میشود و تضمین میکند تاریخچه گفتگوها بلافاصله پس از اجرا در دسترس باشند.
استنتاج توزیعشده و مقیاسپذیری
برای کسانی که چندین دستگاه دارند، oMLX یک حالت سرویسدهی توزیعشده آزمایشی معرفی کرده است. این سیستم از JACCL، یک لایه ارتباطی تخصصی، استفاده میکند تا یک مدل واحد را بین مکهایی که از طریق Thunderbolt متصل شدهاند، تقسیم کند. این روش از موازیسازی خط لوله (Pipeline Parallelism) در MLX برای کاهش تأخیر (Latency) در همگامسازی بین دستگاهها بهره میبرد.
بر اساس گزارش dev.to، این پیکربندی تجربه اجرای مدلهای ۲۷ میلیارد پارامتری را از حالت کند به حالتی واقعاً بهرهور تبدیل میکند. کل این فرآیند از طریق یک داشبورد مدیریتی که بنچمارکهای خودکار و اعتماد مبتنی بر کلید SSH را مدیریت میکند، کنترل میشود.
نصب و پیکربندی
نصب این ابزار از طریق Homebrew با دستور brew tap jundot/omlx و سپس brew install jundot/omlx/omlx انجام میشود. کاربران میتوانند سرویس پسزمینه را با omlx start یا سرور را بهصورت مستقیم با omlx serve --model-dir ~/models اجرا کنند.
برای بهینهسازی محیط، توسعهدهندگان میتوانند از پرچمهای زیر استفاده کنند:
--memory-guard safe: تضمین میکند سیستم در حالی که موتور حافظه یکپارچه را اشغال کرده، پاسخدهنده باقی بماند.--paged-ssd-cache-dir: یک درایو NVMe سریع را به لایه حافظه سرد اختصاص میدهد تا سرعت افزایش یابد.
انتشار سرویسهای محلی با Pinggy
برای انتقال این سرویسها به خارج از شبکه محلی، oMLX با Pinggy ادغام شده است. توسعهدهندگان با ایجاد یک تونل SSH امن به free.pinggy.io میتوانند نقطه اتصال محلی خود را به عنوان یک URL عمومی HTTPS منتشر کنند.
این قابلیت اجازه میدهد لپتاپهای راه دور یا سیستمهای CI/CD به مدل محلی بهگونهای دسترسی داشته باشند که انگار یک API ابری است. این روش جایگزین فوروارد کردن پورتهای سنتی شده که اغلب ناامن و دشوار است.
امنیت در اینجا اولویت دارد؛ oMLX از احراز هویت با API Key از طریق پرچم --api-key پشتیبانی میکند و Pinggy لایهای از احراز هویت پایه HTTP را برای جلوگیری از دسترسی غیرمجاز به منابع محاسباتی اضافه میکند.
کاربردهای عملی برای توسعهدهندگان
این تغییر در میزبانی محلی، پیشفرضهای گردش کار برنامهنویسان را تغییر میدهد:
- دستیار کدنویسی راه دور: استفاده از یک مک قدرتمند در دفتر کار به عنوان بکاند استنتاج برای یک مکبوک کوچک در هنگام سفر.
- یکپارچگی با CI/CD: متصل کردن تستهای خودکار به یک مدل محلی برای اعتبارسنجی پاسخها بدون پرداخت هزینه APIهای خارجی. در این راستا، مدلهای جدیدی مانند Oxlo سعی دارند هزینههای استنتاج را از تعداد توکنها جدا کنند تا دسترسی به مدلهای دقیقتر ارزانتر شود.
- نمونهسازی سریع: اشتراکگذاری مدلهای تنظیم دقیق (Fine-tuning) — شبیه به وقتی که به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — با همتیمیها از طریق URLهای موقت.
در واقع، یک مک اداری تبدیل به یک بکاند استنتاج خصوصی میشود که حریم خصوصی و سرعت نمونهسازی سیستمهای عاملمحور را بهشدت افزایش میدهد. البته باید یاد داشت که این یک ابزار توسعه است، نه یک استقرار تجاری چندکاربره؛ اولویت اینجا با کنترل محلی است، نه مقیاس عظیم ابرهای سازمانی.
گام بعدی شما
- لایه ارتباطی JACCL را بررسی کنید تا ببینید آیا سختافزارهای موجود شما برای تجمیع منابع و اجرای مدلهای بزرگتر مناسب هستند یا خیر.
- برای کاهش هزینههای API در محیط تست، یک نقطه اتصال محلی با oMLX ایجاد و آن را به خط لوله CI/CD خود متصل کنید.
- امنیت دسترسیهای راه دور خود را با ترکیب API Key و احراز هویت Pinggy تست کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو