تصور کنید سیستمی را طراحی کردهاید که قرار است تمام دادههای حساس مشتریان را در سرورهای داخلی نگه دارد، اما یک اتصال پنهان برای بررسی لایسنس، تمام حریم خصوصی شما را به باد میدهد. اگر فکر میکنید میزبانی محلی مدل زبانی به معنای امنیت مطلق است، احتمالاً در تلهٔ «وابستگیهای تصادفی» افتادهاید. در حالی که اغلب تصور میشود میزبانی محلی یک مدل زبانی باعث ایمن شدن سیستم میشود، در واقعیت یک استقرار محلی AI تنها به اندازهٔ ضعیفترین اتصال خارجیاش خصوصی است.
به نقل از راهنمای عملی Fonix.AI که توسط AntEngage منتشر شده است، این چارچوب مفروضات رایج را به چالش میکشد. بسیاری از سازمانها به اشتباه تصور میکنند استقرار درونسازمانی (On-premises) یک کلید روشن/خاموش ساده است. در واقعیت، یک سیستم میتواند یک مدل استدلالی (Reasoning Model) — شبیه شطرنجبازی که قبل از هر حرکت چند گام جلوتر را میبیند — را بهصورت محلی اجرا کند، اما همچنان برای تبدیل صوت به متن به یک ارائهدهنده ابری وابسته باشد یا یک API مربوط به CRM راه دور را فراخوانی کند. این وضعیت «وابستگیهای تصادفی» ایجاد میکند که میتواند امنیت را به خطر اندازد یا در زمان قطعی شبکه، باعث شکست کامل سیستم شود. صرفاً میزبانی محلی یک مدل زبانی، تعیین نمیکند که تلفنی، پردازش گفتار، متنها، فراخوانی ابزارها یا مانیتورینگ در کجا اجرا شوند.
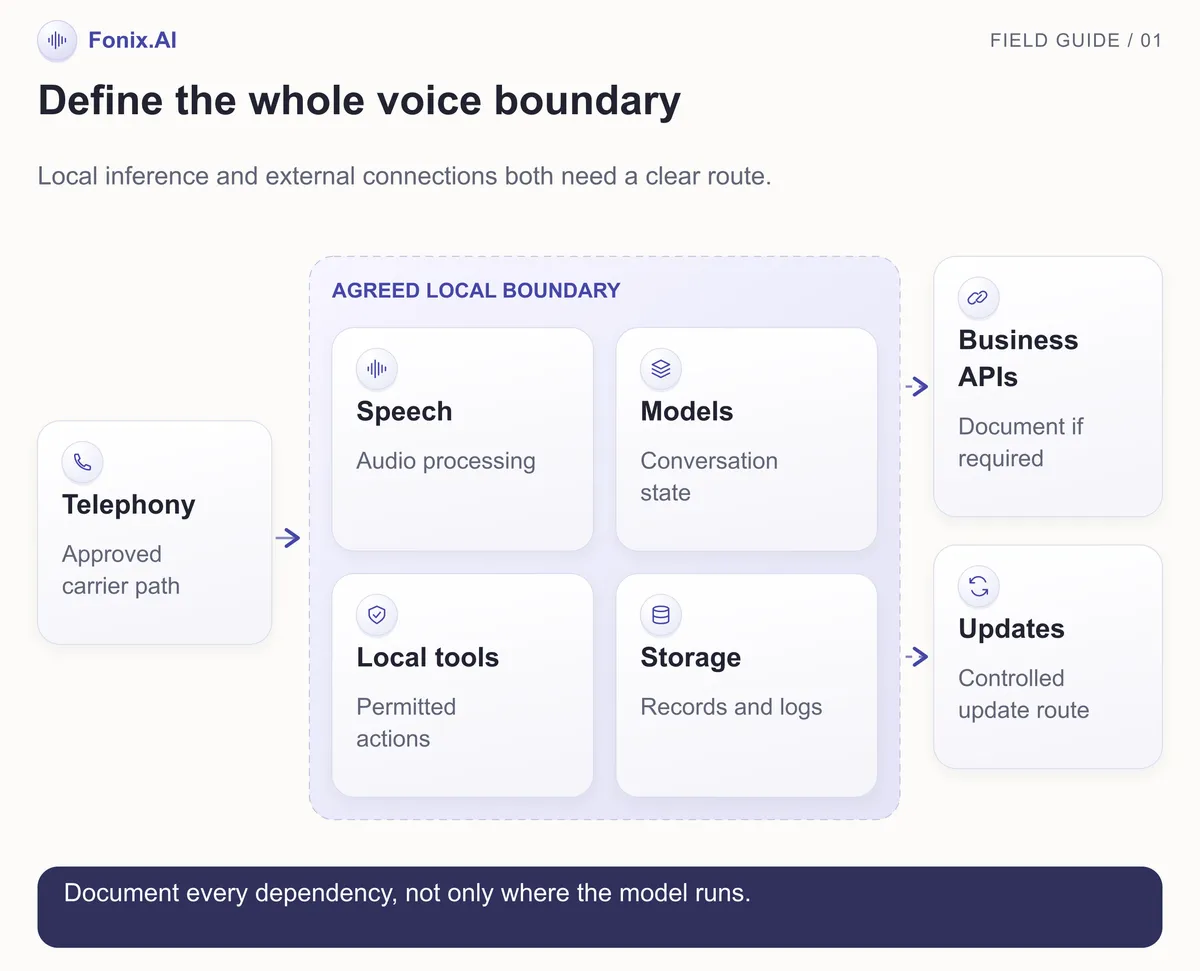
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، حذف وابستگیهای ابری نیازمند یک استراتژی جامع است، نه فقط جابهجایی سختافزار. طبق این راهنما، هوش مصنوعی صوتی واقعی نیازمند یک «مرز» (Boundary) مشخص و ملموس است که دقیقاً تعریف کند پردازش صوت، متنهای استخراجشده و فراخوانی ابزارها در کجا قرار دارند.
ترسیم مرز وابستگی
برای جلوگیری از این تلهها و شکست سیستم، راهنما پیشنهاد میکند با یک وظیفهٔ تجاری واحد شروع کنید و یک نمودار مسیر کامل رسم نمایید. شما باید مرز مورد نیاز را بهصورت صریح و ملموس برای موارد زیر تعریف کنید:
- محل اجرای مدل و پردازش صوت
- محل ذخیرهسازی متنها و دسترسی به سیستمهای تجاری
- دسترسی اپراتورها و اتصالات خارجی مجاز
بسیار حیاتی است که شبکهٔ تلفنیِ در ارتباط با مشتری از محیط اپلیکیشن و مدل جدا شود. سیستمی که تماسهای تلفنی عادی را پاسخ میدهد، دارای یک مسیر تلفنی است؛ این مسیر باید با جزئیات دقیق توصیف شود و نباید از واژههای مبهمی مانند «آفلاین» به عنوان یک وعده تعریفنشده استفاده کرد.
هر جزء از سیستم باید دارای یک مکان ثبتشده، فهرستی از دادههای دریافتی، دادههای نگهداریشده، اتصالات خروجی مجاز و یک مالک مشخص باشد. این مورد حتی شامل سرویسهای نامرئی مانند بررسی لایسنس، گزارشهای کرش (Crash Reports)، دانلود بستهها، ذخیرهسازی پشتیبان (Backup) و پشتیبانی از راه دور میشود که اغلب بهعنوان درهای پشتی پنهان به وب خارجی عمل میکنند.
چکلیست ارزیابی اجزا
برای اطمینان از اینکه مرزها ایمن هستند، راهنمای Fonix.AI پیشنهاد میکند برای هر جزء به این پرسشهای خاص پاسخ دهید:
- ورودی/خروجی تلفنی: کدام ارائهدهنده، ترانک (Trunk) و مسیر شبکه، صوت را منتقل میکند؟ مدرک باید شامل یک مسیر مستند و یک تماس تستشده باشد.
- مدلهای گفتار و گفتگو: کدام مراحل بهصورت محلی اجرا میشوند؟ آیا از استنتاج (Inference) ابری استفاده شده است؟ مدرک مورد نیاز، فهرستی از زمانهای اجرا (Runtime Inventory) و اتصالات مشاهدهشده است.
- ابزارهای تجاری: کدام APIهای CRM، تقویم یا حسابهای کاربری فراخوانی میشوند؟ مدرک شامل نقاط انتهایی (Endpoints) مجاز، مجوزها و نتایج تست است.
- ذخیرهسازی رکوردها: صوتها، متنها و نتایج در کجا ذخیره میشوند؟ مدرک نیازمند مکانهای ذخیرهسازی، نقشهای دسترسی و یک فرآیند حذف داده است.
- قابلیت مشاهده (Observability): لاگها و تشخیصها به کجا ارسال میشوند؟ مدرک شامل پیکربندی لاگها و بررسی مقصدهای خروجی است.
- بهروزرسانی و پشتیبانی: نسخههای جدید و جلسات پشتیبانی چگونه وارد مرز سیستم میشوند؟ مدرک نیازمند یک فرآیند دسترسی و بهروزرسانی تأیید شده است.
معماری و برنامهریزی ظرفیت
انتخاب معماری درست گفتگو گام حیاتی بعدی است. تیمها باید بحث کنند که آیا استقرار از یک خط لولهی «تبدیل صوت به متن $
ightarrow$ استدلال $
ightarrow$ تبدیل متن به گفتار» استفاده میکند، یا یک مسیر مستقیم «صوت به صوت» یا هر پیکربندی پشتیبانیشده دیگری.
در وظایف تراکنشی، معماری به چیزی فراتر از صدای طبیعی نیاز دارد. سیستم باید بتواند رکورد درست سیستم را به دست آورد، یک اقدام مجاز را انجام دهد، نتیجه را تشخیص دهد و زمینه (Context) کافی برای تحویل تماس به اپراتور را حفظ کند. تیمها باید بررسی کنند که این تصمیمات در کجا اتفاق میافتد و کدام جزء مالک وضعیت (State) است. اگر یک مدل شخص ثالث یا مدل انتخابشده داخلی پیشنهاد میشود، الزامات میزبانی و منابع آن باید بهطور جداگانه مستند شود. هرگز فرض نکنید که تغییر مدل استدلالی، کیفیت زبان، تأخیر یا ظرفیت را بدون تغییر باقی میگذارد.
برنامهریزی ظرفیت اغلب به دلیل تکیه بر «کل دقایق تماس ماهانه» بهجای «همزمانی واقعی» (Real-time Concurrency) شکست میخورد. راهنما یک محاسبه بار خاص را ارائه میدهد: اگر ۱۲۰ تماس بهطور یکنواخت در ۱۰ دقیقه برسند و میانگین مدت زمان هر تماس ۲ دقیقه باشد، میانگین همزمانی ارائه شده ۲۴ تماس است.
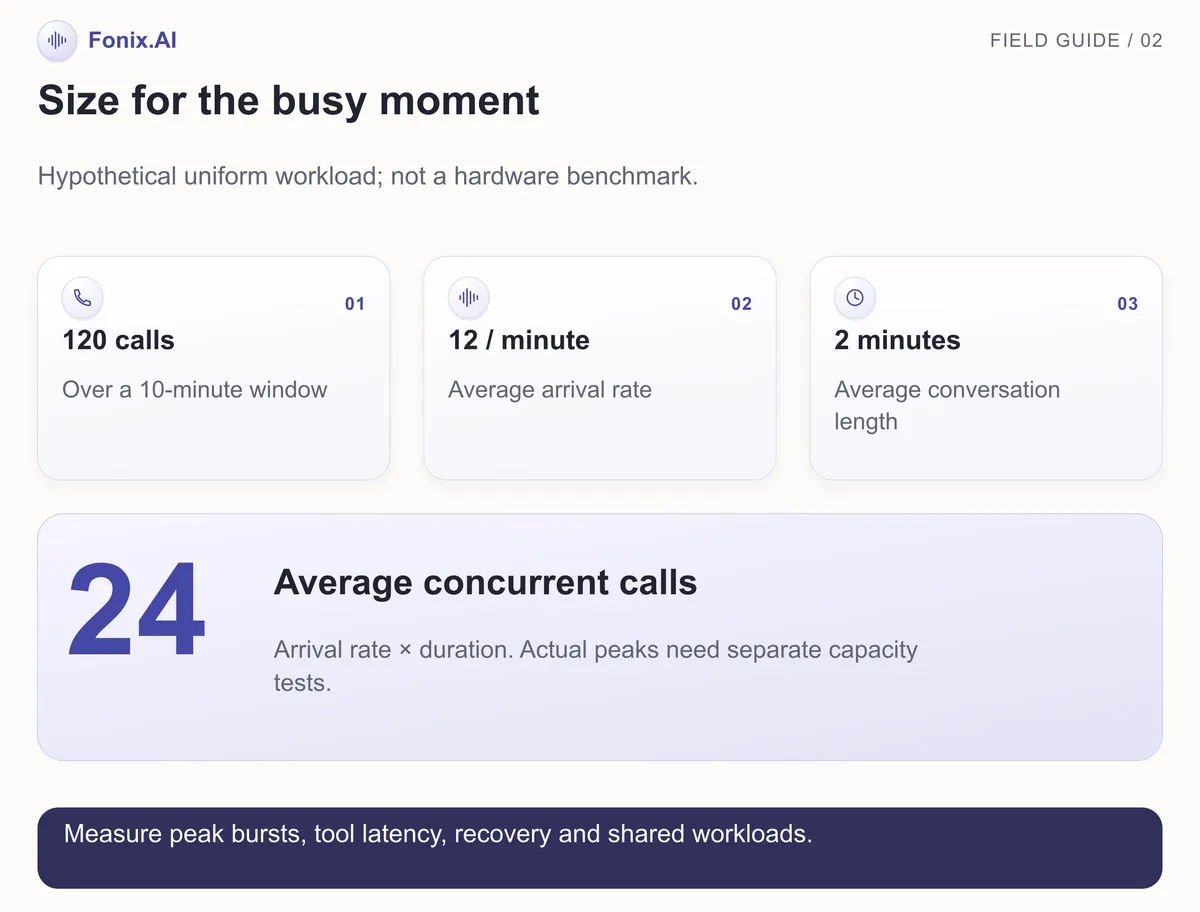
با این حال، ورود تماسها در دنیای واقعی نابرابر است. تأمین منابع نیازمند اندازهگیری عملکرد و داشتن فضای اضافی (Headroom) برای مدیریت فورانهای اوج (Peak Bursts) است. شما باید اوج تماسهای همزمان، فورانهای ورودی، مدت زمان معمول و ترکیب زبانها را ثبت کنید. زمانبندی پاسخ پایان-به-پایان، اتصالات قطعشده، تأخیر ابزارها و مصرف منابع را دقیقاً روی سختافزاری که در نظر گرفته شده است، بنچمارک کنید.
ثبت کنید وقتی بار سیستم از حد مجاز توافقشده فراتر رفت چه اتفاقی میافتد: آیا سیستم از صف انتظار، پاسخ «مشغول»، انتقال تماس یا یک جایگزین (Fallback) تعریفشده دیگر استفاده میکند؟ تأیید کنید که آیا ظرفیت با چت، کمپینها یا سایر حجمهای کاری مشترک است یا خیر. یک نمایش موفق در ساعات خلوت، هرگز رفتار سیستم را در زمانی که کمپینهای خروجی و تماسهای پشتیبانی ورودی بهطور همزمان اجرا میشوند، تضمین نمیکند.
مسئولیت عملیاتی و بازیابی
پیش از لانچ، سازمانها باید مالکیت انتشار اپلیکیشن، بهروزرسانیهای مدل، وصلههای سیستمعامل، گواهینامهها، پشتیبانها، مانیتورینگ ظرفیت و پاسخ به حوادث را تعیین کنند. مسئولیتهای فروشنده و مشتری را به گونهای فهرست کنید که اپراتورها بتوانند در زمان قطعی از آنها استفاده کنند.
نقشهای دسترسی برای رکوردها، متنها، پیکربندی و اعتبارنامههای ابزارهای تجاری را تعریف کنید. تصمیم بگیرید که تغییرات چگونه بررسی شوند، دسترسیها چگونه حذف گردند و کدام سوابق حسابرسی (Audit Records) در دسترس باشند. فرآیندهای نگهداری و حذف را برای هر اثر ذخیرهشده مشخص کنید، بهجای اینکه با هر لاگ مانند یک رکورد تماس رفتار کنید. برای شبکههای محدود، توافق کنید که بستههای نرمافزاری و مدلها چگونه وارد شوند، چگونه تأیید گردند و در صورت شکست بهروزرسانی، چگونه بازگشت (Rollback) شوند.
Fonix.AI توصیه میکند برای سناریوهای خاص زیر، یک برنامه شکست و بازیابی قابل اثبات داشته باشید:
- توقف Worker مدل: اطمینان حاصل کنید که سیستم مسیر بازیابی پشتیبانیشده یا Fallback را دنبال میکند. مدرک: تجربه مشتری و رکورد نهایی.
- شکست در جستوجوی سیستم تجاری: هوش مصنوعی باید بهجای توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که وجود ندارد — یک نتیجهٔ «حلنشده» صریح ارائه دهد. مدرک: خطای ابزار و نتیجه صریح حلنشده.
- عدم دسترسی به ذخیرهساز: پیروی از سیاست پیشتوافقشده برای رکوردها و وظایف. مدرک: هشدار، رفتار مدیریت شده و قابلیت بازیابی.
- قطع اتصال تلفنی: تعیین اینکه آیا عملیات پیش از تلاش مجدد تکمیل شده است یا خیر. مدرک: مرجع تماس و وضعیت سیستم منبع.
- تجاوز تقاضا از ظرفیت: اعمال رفتار پذیرش تعریفشده، مانند صف یا پاسخهای مشغول. مدرک: صف، انتقال یا پاسخ مشغول تحت بار.
- شکست در انتشار نسخه جدید: بازگشت به نسخه قبلی از طریق فرآیند توافقشده. مدرک: نسخه بازیابی شده و تکرار نتیجه پذیرش.
فرآیند پذیرش نهایی
پذیرش نهایی باید یک بررسی مشترک با استفاده از یک محیط ارزیابی کنترلشده با سختافزار واقعی و قوانین شبکه باشد. با ابزارهای مانیتورینگ تأیید شده، مقصدهای پیکربندی شده را در زمان تماسهای عادی، شکستها، ریاستارتها و بهروزرسانیها مشاهده کنید. نسخههای مدل و اپلیکیشن را در کنار نتایج ثبت نمایید.
فهرست وابستگیها، تست بار اوج، تماسهای زبانهای نماینده، مجوزهای ابزار و نمایشهای بازیابی را در یک رکورد پذیرش واحد ترکیب کنید. آستانهها و الزامات مدرک را پیش از نمایش، بر اساس وظیفه تجاری و ریسکهای عملیاتی تعیین کنید.
مقایسه هزینهها نیز نیازمند یک مدل حجم کاری مشترک است. یک اشتراک ابری کوچک و خرید سال اول تجهیزات محلی را نمیتوان بدون در نظر گرفتن سختافزار، افزونگی (Redundancy)، کارکنان زیرساخت، پشتیبانی، تلفنی، بهروزرسانیها و عملیات یکپارچهسازی بهطور مستقیم مقایسه کرد. میزبانی محلی یک انتخاب معماری است، نه یک گواهینامهٔ قانونی؛ بنابراین باید توسط بازبینهای داخلی بر اساس سیاستهای خاص هر بخش ارزیابی شود، بهجای اینکه یک نشان محصول (Product Badge) به عنوان کل ارزیابی پذیرفته شود.
گام بعدی شما
- تمام اتصالات خروجی سرورهای AI خود را با ابزارهای مانیتورینگ شبکه بررسی کنید تا وابستگیهای پنهان (مانند چک کردن لایسنس) را بیابید.
- یک سناریوی «شکست در دسترسی به دیتابیس» را شبیهسازی کنید و مطمئن شوید مدل بهجای توهم، خطای صریح میدهد.
- ظرفیت سیستم خود را بر اساس «اوج همزمانی» (Peak Concurrency) محاسبه کنید، نه میانگین دقایق ماهانه.
اما تأثیر این معماری بر کاهش تأخیر (Latency) در پاسخهای صوتی حتی حیاتیتر است — به تحلیل ما دربارهی بهینهسازی استنتاج در لبه مراجعه کنید.



گفتگو