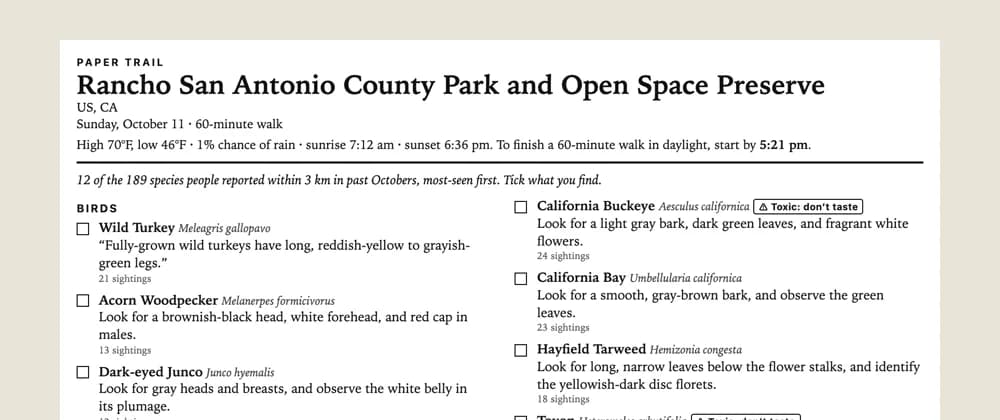
تصور کنید در جنگلی هستید و میخواهید پرندهای را شناسایی کنید؛ اما به محض اینکه گوشی خود را بالا میآورید، پرنده میپرد و شما باز هم به جای طبیعت، به یک مستطیل درخشان خیره شدهاید. این مشاهده دقیق، دلیل خلق Paper Trail است؛ پروژهای متنباز که در ۶ اکتبر ۲۰۲۶ برای چالش هوش مصنوعی Hacktoberfest معرفی شد. هدف این ابزار، استفاده از مدل Gemma 3 1B برای تولید کارتهای شناسایی چاپی است تا تناقض رایج در برنامههای طبیعتگردی — یعنی تمایل به نگه داشتن کاربر در وضعیت خیرگی به یک صفحه درخشان هنگام مشاهده فضای باز — حل شود. فرض اصلی ساده است: یک کارت فیزیکی میتواند در طول پیادهروی در طبیعت، جایگزین صفحه نمایش گوشی هوشمند شود.
بسیاری از برنامههای هوش مصنوعی فضای باز بر مدلهای ابری متکی هستند که به محض ورود کوهنورد به نقاط کور شبکه در پارکهای ملی، کاملاً بیمصرف میشوند. Paper Trail با انتقال هوش به لبه (Edge)، تضمین میکند که کار هوش مصنوعی پیش از آنکه کاربر حتی از خانه خارج شود، به پایان رسیده باشد. این رویکرد یادآور تلاشهای مشابه در پروژه TrailEcho است که بر جایگزینی نمایشگرها با هوش مصنوعی محلی در مسیرهای هایکینگ تمرکز داشت. نتیجه این فرآیند، یک صفحه چاپی واحد است که شامل ۱۲ گونه برای جستجو، چکباکسهایی برای ردیابی و دادههای آبوهوایی محلی است. این ابزار برای هر کسی طراحی شده که میخواهد بدون راه رفتن در پشت یک صفحه نمایش بداند به چه چیزی نگاه میکند؛ از خانوادهای که در یک مسیر یکشنبه در حال پیادهروی هستند تا کودکی که تازه یاد گرفته پرنده «تووی» (Towhee) چیست.
خط لوله هوش مصنوعی محلی
طبق مستندات این پروژه در dev.to، این سامانه کاملاً بهصورت یک سایت ایستا (Static Site) روی لایه رایگان Cloudflare میزبانی میشود. هیچ سرور پشتیبانی (Backend) وجود ندارد؛ در عوض، مدل مستقیماً روی واحد پردازش گرافیکی (GPU) بازدیدکننده و از طریق WebGPU اجرا میشود. این سیستم از کتابخانه Transformers.js برای بارگذاری نسخهی کوانتیده (Quantized) ۴ بیتی مدل Gemma 3 1B (بهطور مشخص مدل onnx-community/gemma-3-1b-it-ONNX-GQA) استفاده میکند که حدود ۷۶۳ مگابایت فضا اشغال میکند. اگر سیستم کاربر از WebGPU پشتیبانی نکند، صفحه بهطور خودکار پیشنهاد میدهد که به جای سنتز هوش مصنوعی، از نقلقولهای مستقیم ویکیپدیا استفاده شود.
زنجیره دادهها در این ابزار به ترتیب زیر دنبال میشود:
- ورودی مکان: کاربر مکان و تاریخ را وارد میکند. برای حفظ حریم خصوصی، این مکان پیش از ارسال به APIهای خارجی، تا دقت حدود یک کیلومتر گرد میشود.
- یافتن گونهها: برنامه از iNaturalist استعلام میگیرد تا گونههایی را که در شعاع چند کیلومتری آن منطقه و در همان ماه خاص در سالهای گذشته گزارش شدهاند، استخراج کند. سپس ۱۲ گونه — معمولاً شامل پرندگان، گیاهان، یک نوع قارچ و یک حشره — را با اولویت دادن به گونههای دارای بیشترین گزارش، انتخاب میکند.
- بازیابی داده: برنامه جملات توصیفی مربوط به رنگ، شکل، بافت و صدا را از ویکیپدیا استخراج میکند.
- سنتز محلی: مدل Gemma 3 1B که در یک Web Worker اجرا میشود، این جملات را پردازش میکند تا یک نکته شناسایی تکخطی بنویسد. به دلیل استفاده از رمزگشایی حریصانه (Greedy decoding)، جملات یکسان همیشه منجر به تولید نکات یکسان میشوند.
- دادههای محیطی: سرویس Open-Meteo وضعیت آبوهوای روز را ارائه داده و زمان شروع لازم برای به پایان رساندن پیادهروی در نور روز را محاسبه میکند.
حل مشکل توهمات (Hallucinations)
مدلهای کوچک اغلب «شاهدان بیدقتی» هستند. در طول آزمایش روی ۷۲ گونه در سه قاره، توسعهدهنده دریافت که Gemma 3 1B مکرراً نکات متقاعدکننده اما نادرست تولید میکند. در یک مورد، مدل یک «حاتم آبی» (Great Blue Heron) را دارای «سر خاکستری زنگزده» توصیف کرد، در حالی که ویکیپدیا اشاره کرده بود تنها گردن پرنده به این رنگ است. در مثالی خطرناکتر، مدل پیشنهاد کرد که یک قارچ طبقهای (Bracket fungus) «مزه ملایمی» دارد، در حالی که ویکیپدیا صراحتاً نسبت به چشیدن قارچهای وحشی هشدار داده بود. توسعهدهنده صراحتاً بیان میکند که هیچ کارتی نباید کسی را به چشیدن قارچهای وحشی ترغیب کند.
شکستهای دیگر شامل گیاهی به نام «تویون» (Toyon) بود که در آن مدل به کاربران پیشنهاد داد «به آواز شاد تویون گوش دهید»؛ عبارتی که احتمالاً از مثال مربوط به پرنده روبین در پرامپت قرض گرفته شده بود. در مورد دیگری، مدل درباره «غاف یا هاثورن معمولی» (Common hawthorn) ادعا کرد که «میوههای قرمز تیره به مدت ۱۰۷.۳ روز باقی میمانند و ۲.۸ دانه دارند». اگرچه این دادهها از نظر فنی درست بودند، اما توسعهدهنده اشاره کرد که چنین دقتی در طول یک پیادهروی کاملاً بیفایده است.
برای رفع این مشکلات، Paper Trail یک تابع اعتبارسنجی سفارشی به نام checkTip() را در فایل src/ground.ts پیاده کرده است. این سیستم تنها در صورتی اجازه چاپ نکته را میدهد که معیارهای سختگیرانه زیر رعایت شود:
- تطبیق محتوا: هر کلمه محتوایی در خروجی باید پس از یک ریشهیابی ساده (Stemming) — مثلاً تبدیل «lobed» به «lobes» — در متن منبع ویکیپدیا وجود داشته باشد. کلمات اشارهای مانند «نگاه کنید» (look) و «مشاهده کنید» (observe) مجاز هستند.
- بررسی مجاورت: رنگها، تنها یا الگوها باید در متن منبع در فاصله حداکثر ۸ کلمه از عضو بدنی که توصیف میکنند ظاهر شوند و هیچ رنگ دیگری بین آنها نباشد. این قانون باعث شناسایی خطای «هاگهای سبز» در قارچ sulphur tuft شد، جایی که لبهها هنگام رشد هاگهای مایل به سیاه، سبز میشوند.
- محدودیت داده: اعداد بهطور کامل ممنوع هستند تا از ارائه دادههای بیفایده و بیش از حد دقیق جلوگیری شود. علاوه بر این، هرگونه اشاره به «مزه» (taste) رد میشود.
- منطق صوتی: کلمه «گوش دادن» (listen) حتماً باید با یک کلمه مرتبط با صدا مانند «آواز» (song)، «فراخوان» (call) یا «طبلزنی» (drumming) همراه باشد.
اگر نکتهای در این بررسی شکست بخورد، سیستم یک بار دیگر تلاش میکند و کلمات رد شده را به مدل اعلام میکند (مثلاً: «منبع نمیگوید: برگهای خاکستری...»). اگر در تلاش دوم نیز شکست بخورد، برنامه سنتز هوش مصنوعی را رها کرده و صرفاً بصریترین جمله ویکیپدیا را در داخل علامت نقلقول قرار میدهد.
عملکرد و ارزیابی
در تست روی یک مکبوک با مرورگر کروم، راهاندازی اولیه حدود ۲۱ ثانیه برای دانلود مدل (تقریباً ۰.۸ گیگابایت) و ۱۷ ثانیه برای تولید اولین کارت زمان میبرد. کارتهای بعدی در حدود ۱۷ ثانیه تولید میشوند. توسعهدهنده چهار نسخه از پرامپتها را برای بهینهسازی دقت آزمایش کرد:
- نسخه ۱ (v1): درخواست یک جمله حداکثر ۱۵ کلمهای فقط با استفاده از حقایق منبع. تنها ۴٪ در تلاش اول پذیرفته شدند، عمدتاً چون مدل از کلمه «Observe» استفاده میکرد که در توصیفات ویکیپدیا نبود.
- نسخه ۲ (v2): عبارتهای «Look for» یا «Listen for» اضافه شد و مثالهایی از پرندگان و گیاهان ارائه گردید. این کار نرخ پذیرش در تلاش اول را به ۴۷٪ افزایش داد.
- نسخه ۳ (v3): محدودیتهای مربوط به مزه اضافه شد، برای «گوش دادن» نیاز به صدا تعریف شد و مقایسه با گونههای دیگر ممنوع گردید.
- نسخه ۴ (v4): قانونی اضافه شد تا هر رنگ حتماً با عضو بدن مربوط به خود همراه باشد. این نسخه عمداً خطوط کمتری از Gemma را نسبت به v3 چاپ میکرد تا تعداد نکات غلط از ۱۲ مورد به ۵ مورد کاهش یابد.
حتی با بررسیهای سختگیرانه، برخی خطاها باقی ماندند زیرا بررسیهای سطح کلمه نمیتوانند منطق جملات (Clause logic) را تحلیل کنند. برای مثال، مدل یک بار سوت صعودی نرِ «اردک چوبی» را به ماده نسبت داد، زیرا هر دو کلمه در متن منبع حضور داشتند. به همین ترتیب، برای گیاه تویون، ادعا کرد میوههای قرمز در دسامبر رشد میکنند، در حالی که آنها در اوت یا سپتامبر رشد کرده و در دسامبر میرسند. خطای سوم مربوط به «پرنده لایر» (Lyrebird) بود؛ فیلتر توسعهدهنده جملهای حاوی اندازهگیری («۷۰ سانتیمتر») را حذف کرد و در نتیجه Gemma هرگز نفهمید دم چه کسی «دو پر میانی نقرهای» دارد.
استقرار و موانع فنی
یک غافلگیری بزرگ در زمان استقرار رخ داد. در حالی که برنامه روی localhost به درستی کار میکرد، مدل در سایت زنده بارگذاری نمیشد. توسعهدهنده متوجه شد که Hugging Face در هر درخواستی که Referer آن یک صفحه *.workers.dev باشد، خطای ۴۰۴ را بدون هدر CORS برمیگرداند. چون برنامه طبق طراحی در صورت خطا به نقلقول ویکیپدیا بازمیگشت، این خطا تقریباً نادیده گرفته شده بود. راه حل، اضافه کردن یک خط به فایل public/_headers بود: Referrer-Policy: no-referrer.
استدلال برای نوآوری باز
این معماری نشاندهنده یک تغییر جهت قابل توجه به سمت حاکمیت محاسباتی (Compute Sovereignty) است. چون مدل روی GPU کاربر اجرا میشود، توسعهدهنده هیچ هزینه استنتاجی (Inference cost) پرداخت نمیکند و ابزار رایگان میماند. حریم خصوصی نیز تقویت شده است؛ مکان کاربر پیش از ارسال به APIها گرد میشود و مدل زبانی (LLM) هرگز مکان را نمیبیند و فقط تکههای متن ویکیپدیا را پردازش میکند.
اگرچه یک مدل بسته و پیشرو (Frontier model) احتمالاً نکات جذابتری با تلاشهای کمتر مینوشت، اما به یک سرور، کلید API و صورتحسابهای ماهانه نیاز داشت. با استفاده از وزنهای باز (Open Weights)، توسعهدهنده به یک محیط ارزیابی تکرارپذیر دست یافت که در آن ورودیهای یکسان همیشه خروجیهای یکسان تولید میکنند. توسعهدهنده حتی مدل Gemma 3 270M را تست کرد، اما آن را نامناسب یافت؛ زیرا این مدل عمدتاً مثال گیاه موجود در پرامپت را برای تمام گونهها، حتی گنجشکها و بازها، کپی میکرد.
این پروژه ثابت میکند که ارزش مدلهای کوچک و باز، تنها در اندازه آنها نیست، بلکه در توانایی محصور کردن آنها در لایههای اعتبارسنجی قطعی (Deterministic) است. این رویکرد، یک مولد احتمالی را به ابزاری قابلاعتماد برای کاربردهای دنیای واقعی تبدیل میکند و از دادههای باز iNaturalist، ویکیپدیا (CC BY-SA) و Open-Meteo (CC BY) بهره میبرد.
گام بعدی شما
- اگر توسعهدهنده هستید، کتابخانه Transformers.js را برای اجرای مدلهای کوچک در مرورگر بررسی کنید.
- برای کاهش توهمات در مدلهای SLM، به جای تکیه بر پرامپت، لایههای اعتبارسنجی کد-محور (Deterministic) اضافه کنید.
- مدلهای کوانتیده را برای کاهش حجم مدل و افزایش سرعت بارگذاری در وبسایتهای استاتیک به کار ببرید.
اما داستان سختافزاری اجرای مدلهای محلی حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای NPU در لپتاپهای جدید مراجعه کنید.



گفتگو