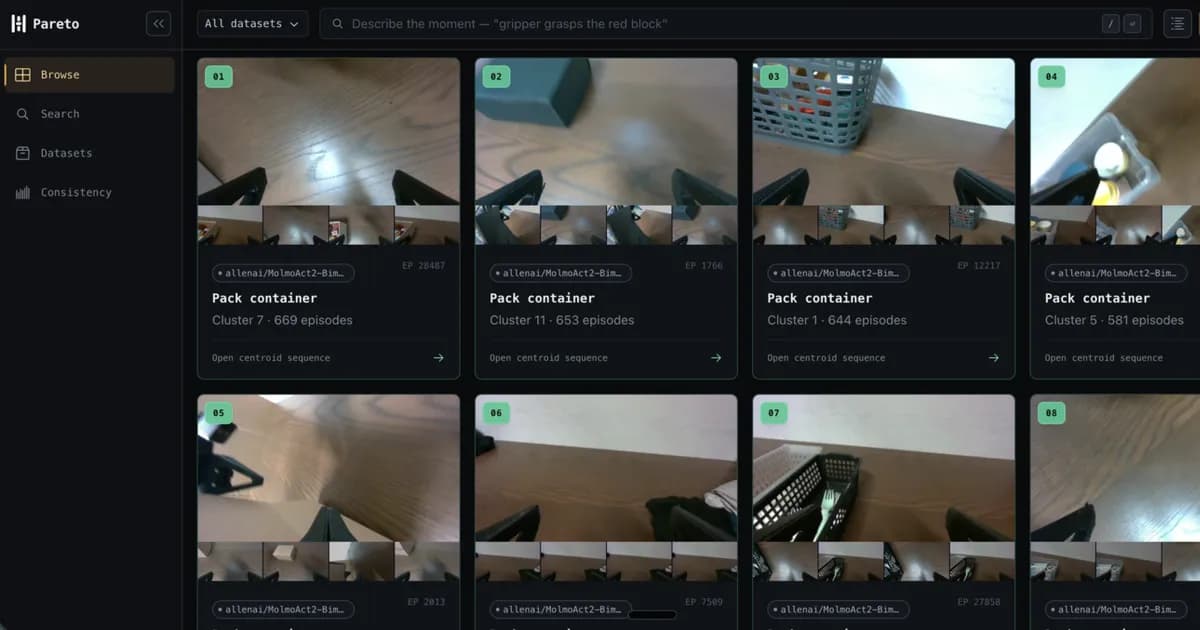
اگر در حال حاضر مجموعههای داده ویدئویی رباتیک خود را با ابزارهای ساده مدیریت میکنید، احتمالاً با بحران همگامسازی دادهها روبهرو هستید. طبق اعلام کینگستون کوآن در ۲۰ ژوئیه ۲۰۲۶، پلتفرم متنباز Pareto با بهکارگیری منطق «طراحی یوتیوب»، راهکاری برای مدیریت پیچیدگیهای یادگیری ربات ارائه داده است. یک مجموعه داده رباتیک حاوی هزاران ویدئو، در اصل همان مسئلهای است که وقتی هزاران کاربر ویدئوهای تکفایلی خود را در یک پلتفرم جهانی آپلود میکنند، پیش میآید. این رویکرد به جای تمرکز بر ابزارهای تکمنظوره، شبیه به مدلهای یکپارچهای است که ابزارهای رشد یوتیوب را در یک فضای کاری متمرکز کردهاند تا بهرهوری عملیاتی را افزایش دهند.
تیمهای رباتیک با یک گلوگاه دادهای مشخص میجنگند: نیاز به همگامسازی دقیق فیدهای دوربین با رزولوشن بالا، موقعیت دقیق مفاصل ربات و خوانش حسگرها. همانطور که در تحلیل قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، کیفیت داده در لایههای زیرین، تعیینکننده نهایی عملکرد مدل است. در رباتیک، پلتفرمهای ویدئویی معمولی تنها یک جریان داده را مدیریت میکنند، اما طبق گزارشهای فنی، یک «اپیزود» دادهای باید ویدئو، اکشنها و خوانشهای نیرویی را بهطور دقیق تراز کند تا برای آموزش مفید باشد.
زمینه: چالش اپیزودهای رباتیک
یک اپیزود دادهای بسیار پیچیدهتر از یک ویدئوی معمولی است. در حالی که یک پلتفرم کلاسیک روی یک ویدئو با صدا و زیرنویس تمرکز دارد، یادگیری ربات به یک رکورد چندوجهی (Multimodal) نیاز دارد. این رکورد معمولاً شامل چندین فید دوربین — مانند نماهای مچ، بالا و سینه — در کنار موقعیت مفاصل، اکشنها، خوانشهای نیرویی، زمانبندیها و شرح وظیفه است.
این فیدها بهتنهایی کاربرد ندارند. دادهها تنها زمانی ارزش دارند که به آنچه ربات در همان لحظه دقیق حس میکرده و انجام میداده متصل بمانند. برای مثال، کاربری که به دنبال «یک بلوک نارنجی» میگردد، نیاز دارد مسیر حرکت اطراف را بررسی کند و زوایای مختلف دوربین را با هم مقایسه کند تا تصمیم بگیرد آیا یک نمایش (Demonstration) خاص باید در مجموعه آموزشی قرار بگیرد یا خیر. در این راستا، کاهش هزینههای سختافزاری در جمعآوری این دادهها نیز حیاتی است، همانطور که برخی پروژهها با سختافزارهای ارزانقیمت به دنبال بهینهسازی جمعآوری دادههای رباتیک هستند.
در پروژه LeRobot v3 این موضوع ملموستر شده است؛ جایی که اپیزودها اجازه دارند فایلهای داده Parquet و قطعات MP4 را به اشتراک بگذارند. خواندن یک اپیزود نیازمند تحلیل همزمان محدوده سطرهای ساختاریافته در فایل داده و محدوده زمانی متناظر در ویدئوهای هر دوربین است. این موضوع یک مسیر دادهای آشنا را آشکار میکند: آپلود $\rightarrow$ پردازش $\rightarrow$ ذخیره $\rightarrow$ نمایه سازی $\rightarrow$ پخش. به همین دلیل Pareto فرآیند ورود داده را به جای یک آپلود ساده، به صورت یک خط لوله چندمرحلهای مدیریت میکند.
ذخیرهسازی و ورود مطمئن دادهها
آپلود مجموعههای عظیم چندرسانهای مستعد شکست است. اتصالات اغلب قطع میشوند و فرآیندها ریاستارت میشوند. تلاش مجدد برای آپلود کل یک مجموعه داده به دلیل قطع شدن آخرین فایل، بسیار هزینهبر و ناکارآمد است. Pareto برای حل این مشکل از مکانیسمهای زیر استفاده میکند:
- آپلودهای قابل بازگشت: پیادهسازی انتقال وضعیت از «در حال آپلود» به «آماده پردازش» برای جلوگیری از شروع مجدد کامل.
- ذخیرهسازی نسخهبندی شده: نگهداری فایلهای منبع در مسیرهای ذخیرهسازی نسخهبندی شده، تا ورودیهای اصلی از داراییهای تبدیلشده جدا بمانند.
- نقاط بازرسی (Checkpointing): دستههای تکمیل شده ثبت میشوند و مانیفست نهایی در آخرین مرحله نوشته میشود. این مانیفست به عنوان نشانهی تکمیل عمل میکند تا سیستم مجبور نباشد حدس بزند آیا یک دایرکتوری کامل شده است یا خیر.
- قابلیت ردیابی: نگهداری فایلهای منبع اصلی به تیم اجازه میدهد هر خروجی تولید شده را تا دقیقترین دسته و فایل منبع ردیابی کنند. این امر همچنین تضمین میکند که بهروزرسانیهای پردازشی آینده بدون درخواست آپلود مجدد از کاربر، قابل اجرا باشند.

خط لوله پردازش
پس از آپلود، دادهها وارد یک خط لوله پسزمینه میشوند. درست مانند یوتیوب که رزولوشنها، کدکها، تامنیلها و کپشنهای مختلف میسازد، Pareto داراییهای مشتق شده زیر را تولید میکند تا از ارسال فایلهای حجیم اصلی به مرورگر جلوگیری کند:
- فریمهای نمونهبرداری شده و تامنیلها: برای مرور سریع بصری و نمایش در نتایج جستوجو.
- ویدئوهای پیشنمایش: برای اینکه پلیر بتواند پخش را بدون بارگذاری فایل اصلی با رزولوشن بالا شروع کند.
- سریهای کاهشیافته: سادهسازی سریهای وضعیت و اکشن برای پخش بهینه.
- بردارهای معنایی (Embedding) — مثل کارت معرفی عددی برای هر رفتار که مشخص میکند این عمل «همسایهی» چه رفتارهای دیگری است — برای بازیابی معنایی رفتارهای خاص ربات.
- نمایههای جستوجو و ضبطهای مجدد (Rerun): برای تحلیلهای عمیق و همگامسازی دقیق. این نوع پردازشهای متوالی و حجیم، یادآور خط لولههای پیشرفته ترجمه ویدئو است که برای مدیریت دادههای چندرسانهای در مقیاس وسیع بهینهسازی شدهاند.

جریانهای کاری بادوام با Temporal
پردازشهای طولانیمدت ورود داده ممکن است ساعتها زمان ببرند و اغلب در گرههای پیشگرفتنی (Preemptible) متوقف شوند. برای تضمین قابلیت اطمینان، Pareto از Temporal (یک موتور جریان کاری متنباز و قابل میزبانی شخصی) برای ارکستراسیون بادوام استفاده میکند. سیستم کارگرها را بر اساس قابلیت و نوع کار تفکیک میکند:
- کارگرهای بردارسازی GPU: اینها محدودههای مستقل اپیزودها را در قطعات (Shards) مدیریت میکنند و سپس در مرحله نهایی برای ادغام خروجیها و اجرای کارهای سراسری جمع میشوند.
- استخرهای منابع الاستیک: کارهایی که نیاز به مدلهای گرم (Warm Model) ندارند، به تکههای مستقل تقسیم شده و در استخرهای الاستیک GPU یا CPU اجرا میشوند تا از مصرف تمام ظرفیت توسط یک کلاس شغلی جلوگیری شود.
- محاسبات تنبل (Lazy Computation): برای کاهش «زمان تا اولین استفاده»، محاسبات سبک و قابل بازیابی به مسیرهای On-demand منتقل شدهاند. این کار از اتلاف منابع روی مصنوعاتی که هیچکس درخواست نمیکند، جلوگیری میکند.
برای بهینهسازی پرسوجوهای متنی، تیم یک سرور SigLIP 2 مبتنی بر CPU با استفاده از زبان Rust و ONNX توسعه داد. دلیل این تصمیم این است که بردارسازی تصاویر یک کار دستهای با حجم بالا برای GPU است، اما یک جستوجوی متنی زنده تنها به یک بردار کوچک پیش از جستوجوی نزدیکترین همسایه (Nearest-neighbor) نیاز دارد. این سرور CPU باعث میشود GPUها روی فرآیند ورود داده متمرکز بمانند و مسیر آنلاین راحتتر تامین شود.
نمایهسازی و پخش دادهها
Pareto از استفاده از یک پایگاهداده یکپارچه و غولآسای (Monolithic) دوری کرده و از تفکیک معماری مشابه پلتفرمهای جهانی ویدئو پیروی میکند. در عوض، پشته را به صورت منطقی تقسیم میکند:
- ذخیرهساز اشیاء با آدرس URI: محل نگهداری مجموعههای داده منبع اصلی و تمامی دادههای مشتق شده.
- Postgres: مدیریت متادیتای ساختاریافته.
- LanceDB: ذخیره بردارهای چندوجهی برای بازیابی.

در این معماری بدون حالت (Stateless)، یک پرسوجوی متنی ابتدا بردار میشود، در LanceDB جستوجو میشود و سپس به صورت مجموعهای از اپیزودها باز میگردد. استریمینگ به گونهای بهینه شده است که تنها محدودههای بایتی مورد نیاز پلیر را ارسال میکند. این قابلیت از Seeking (جابهجایی در زمان ویدئو) پشتیبانی کرده و از دانلود کل فایل توسط مرورگر برای تماشای چند ثانیه اول جلوگیری میکند.
در رابط کاربری Pareto، چندین دوربین از یک ترنسپورت همگام شده استفاده میکنند. کاربران میتوانند در خط زمانی (Timeline) جابهجا شوند و همزمان وضعیتها و اکشنهای متناظر را مشاهده کنند. کیفیت پیشنمایش میتواند در کل شبکه دوربینها ثابت (Pin) شود یا به صورت خودکار انتخاب گردد. این تجربه، تماشای غیرفعال را به یک ابزار فعال برای سازماندهی (Curation) تبدیل میکند؛ جایی که کاربر شواهد را بررسی، رفتارها را مقایسه و دادهها را برچسبگذاری میکند تا تصمیم بگیرد کدام نمایشها باید روی مدل اثر بگذارند.
معماری برای مقیاسپذیری
توسعهدهندگان با تکیه بر تجربه مهندسی نرمافزار در Jane Street در ساخت زیرساختی برای میلیونها پیام در ثانیه، فلسفه «گلهها، نه حیوانات خانگی» (Cattle, not pets) را به کار بردند. هدف این بود که تفکر درباره مقیاس از عملیات اجرایی مقیاسبندی جدا شود. سیستم با گرههای کوچک و یکسان ساخته شده که بهراحتی جایگزین میشوند، به جای چند گره بزرگ که باید به صورت دستی مدیریت شوند.
تصمیمات ساختاری کلیدی عبارتند از:
- وضعیت بادوام خارجی: تمام وضعیتهای ماندگار خارج از ماشینهای پردازش قرار دارند.
- کارگرهای جایگزینپذیر: رپلیکاهای API و کارگرهای رسانهای دور ریختنی هستند. اگر یک کارگر ناپدید شود، شغل بدون نیاز به پروژه بازیابی دستی، به گره جدید تحویل داده میشود.
- مقیاسدهی افقی: مدل اجرا اجازه میدهد سیستم امروز با یک کارگر و فردا با تعداد بسیار بیشتر، بدون نیاز به بازطراحی منطق هسته، اجرا شود.

با وجود این قابلیتهای توزیعشده، تیم اجازه نداد «مقیاسپذیری» به بهانهای برای پیچیدگی غیرضروری تبدیل شود. Pareto یک رابط خط فرمان (CLI) مستقیم دارد که میتواند بدون نیاز به Postgres یا Temporal، دادهها را نمایه، جستوجو و صادر کند. قطعات توزیعشده تنها جایی اضافه شدهاند که اجرای بادوام در بازههای زمانی طولانی ضروری است. با ارجاع به اصل XKCD «آیا ارزش زمان را دارد؟»، تیم تنها به این دلیل از Temporal استفاده کرد که تبدیلهای فردی ساعتها در گرههای پیشگرفتنی اجرا میشوند و نیازمند بازیابی قدرتمند هستند؛ به گونهای که ساخت یک زمانبند یا تطبیقدهنده (Reconciler) سفارشی بیش از حد پرهزینه بود.
نتیجهگیری: فراتر از یک ویدئو
در نهایت، دادههای رباتیک صرفاً استریم ویدئو با چند ستون اضافه نیستند. یک اپیزود باید فیدهای دوربین، اکشنها، وضعیت مفاصل و جریانهای حسگر با نرخهای نمونهبرداری متفاوت را همتراز کند و در عین حال هویت مدل را حفظ نماید تا نتایج جستوجوی برداری معنادار بمانند. با این حال، آزمایش ذهنی یوتیوب چارچوبی اثباتشده برای آپلود، پردازش، ذخیره، نمایهسازی و پخش ارائه میدهد. Pareto با تبدیل یک گلوگاه تخصصی رباتیک به یک مسئله زیرساختی مقیاسپذیر، اصطکاک در سازماندهی مجموعههای داده عظیم و باکیفیت را بهشدت کاهش داده است.
گام بعدی شما
- اگر با مجموعههای داده ویدئویی بزرگ کار میکنید، معماری ذخیرهسازی تفکیکی (Object Store + Metadata DB) را برای کاهش تأخیر در بازیابی امتحان کنید.
- برای بهینهسازی هزینه GPU، عملیات بردارسازی متنی (Text Embedding) را به سرورهای CPU-based منتقل کنید.
- برای مدیریت جریانهای کاری طولانی، موتورهای Orchestration مانند Temporal را جایگزین اسکریپتهای ساده bash کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو