تصور کنید یک مدل زبانی با ۱۸۰ میلیارد پارامتر را بدون نیاز به سرورهای گرانقیمت، مستقیماً روی لپتاپ شخصی خود اجرا کنید. این سناریو که تا پیش از این غیرممکن به نظر میرسید، اکنون با معرفی POCKET-Darwin-180B-GGUF به واقعیت تبدیل شده است. ۱۸۰ میلیارد پارامتر؛ تا همین اواخر، مدلی در این مقیاس برای عملکرد صحیح به یک رک سختافزاری کامل از GPUها در یک مرکز داده نیاز داشت.
طبق گزارش فنی منتشر شده در ۶ اکتبر ۲۰۲۶، این مدل از طریق یک طرح تخصصی کوانتش (Quantization) — شبیه به فشردهسازی یک فایل حجیم برای جا شدن در فلشمموری بدون از دست دادن محتوای اصلی — استنتاج در سطح مدلهای پیشرو را روی لپتاپها و مینیپیسیها ممکن کرده است. برای سالها تصور میشد اجرای چنین مقیاسی نیازمند صدها گیگابایت حافظه ویدیویی (VRAM) است و توسعهدهندگان برای فرار از تأخیر شدید پردازشگر مرکزی (CPU)، به APIهای ابری یا کلاسترهای سختافزاری عظیم پناه میبردند. اما این بیلد جدید با بهینهسازی نحوه ذخیره و دسترسی به وزنها در حافظه، این پیشفرض را شکست.
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی مدلهای بازمتن اشاره کردیم، کلید موفقیت در کاهش نیازهای سختافزاری بدون افت کیفیت نهفته است. عملکرد این مدل شبیه به خواندن یک کتابخانه عظیم است که در آن برای پاسخ به یک سؤال، فقط به ۱۰ کتاب خاص نیاز دارید؛ مدل به جای فعال کردن کل ۱۸۰ میلیارد پارامتر برای هر کلمهای که تولید میکند، تنها بخش کوچکی از «مغز» خود را به کار میگیرد.
معماری پراکندگی
به نقل از گزارش dev.to، این مدل از معماری ترکیب خبرهها (Mixture-of-Experts یا MoE) استفاده میکند. این ساختار شامل ۵۱۲ زیرشبکه متخصص است، اما مسیریاب مدل برای هر توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — تنها ۱۰ خبره را انتخاب میکند. این یعنی در هر لحظه فقط حدود ۳ میلیارد پارامتر فعال هستند. این رویکرد یادآور مدل Colibrì است که پیشتر توانست یک مدل ۱۵۰ میلیاردی را با کمترین گلوگاه ذخیرهسازی روی لپتاپ اجرا کند.
در حالی که وزنهای خبرهها بر حسب نیاز خوانده میشوند، بخشهای متراکم مدل شامل توجه (Attention)، مسیریابی و بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که همسایگی آن با کلمات دیگر را مشخص میکند — در هر مرحله اجرا میشوند. این ساختار ترکیبی است که مدل را روی سختافزارهای مصرفکننده قابل مدیریت میکند.
این پراکندگی به لاماسیپلاسپلاس (llama.cpp) اجازه میدهد از نقشهبرداری حافظه (Memory-mapping) استفاده کند. سیستمعامل تنسورهای خبره را بر اساس نیاز از دیسک به رم منتقل (Page in/out) میکند. بنابراین برای دریافت پاسخ، نیازی نیست تمام ۱۱۱ گیگابایت مدل به صورت مقیم در حافظه باشد، هرچند داشتن رم بیشتر سرعت را بهشدت افزایش میدهد.
کوانتش گزینشی و حفظ دقت
کوانتش استاندارد ۴ بیتی معمولاً هوش مدل را کاهش میدهد، اما POCKET-Darwin با استراتژی «دقت گزینشی» از این مشکل عبور کرده است. این بیلد از یک کوانتش ۴ بیتی تأییدشده توسط جامعه کاربران برای وزنهای پایه شروع میشود. بر روی این پایه، تنها بخشی که آموزش خودبهبودی (Self-improvement training) واقعاً تغییر داده است — که تقریباً ۳٪ از حجم کل است — با دقت بالاتری نگه داشته شده است.
توسعهدهندگان با تخصیص بودجه بیتی در نقاطی که سیگنال قویتر است، بهجای اعمال یکنواخت کوانتش، مدلی ساختند که بهجای «۴ بیتی و دارای افت کیفیت»، به مدلی «۴ بیتی و بدون افت در بنچمارک» تبدیل شد.
این رویکرد در محک MMLU-Pro نتیجهای خیرهکننده داشت. در یک مقایسه جفتشده روی ۲۰۰۰ سؤال با استفاده از رمزگشایی (Decoding) یکسان، هر دو نسخه BF16 (اصلی) و نسخه ۴ بیتی، دقیقاً امتیاز ۸۷.۶۵٪ را کسب کردند. افت دقت عملاً صفر بود زیرا حیاتیترین سیگنالهای مرتبط با وظایف حفظ شده بودند. برای بهبود سرعت در این مرحله از رمزگشایی، میتوان از تکنیکهای جدید دور زدن گلوگاه حافظه برای شتاببخشی به تولید توکنها بهره برد.
بنچمارکهای عملکرد
عملکرد مدل بسته به سقف حافظه سختافزار به شدت متفاوت است. این مدل در Hugging Face و ModelScope به صورت بیلد GGUF عرضه شده و از نسخه ۳۶۰ گیگابایتی BF16 (شامل ۱۳۱ فایل) به نسخه ۱۱۱ گیگابایتی ۴ بیتی (شامل ۴ فایل) کاهش یافته است:
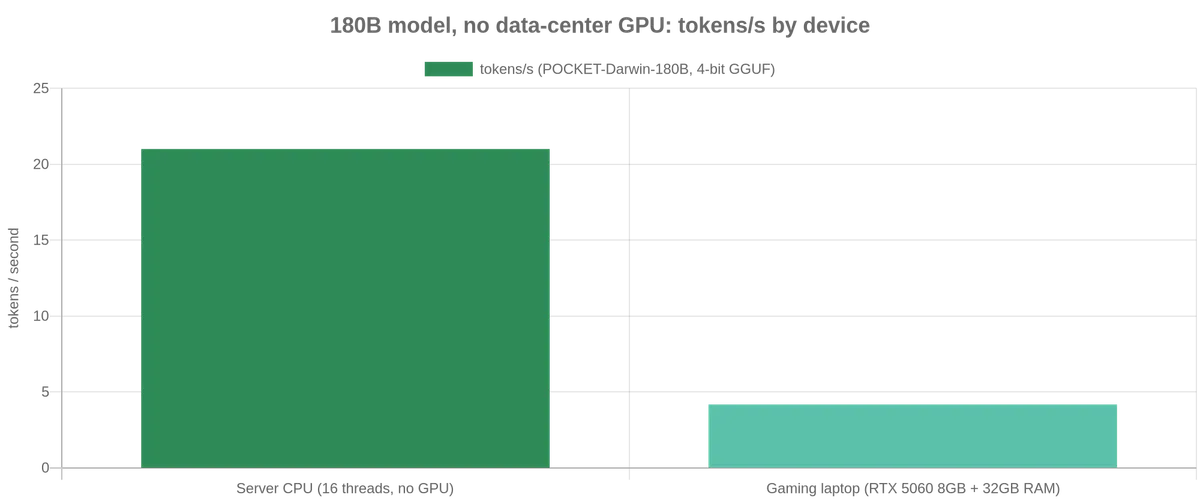
- پردازنده سرور (۱۶ رشته): تولید ۱۸.۴ تا ۲۱.۰ توکن در ثانیه با حداکثر مصرف حافظه ۷۸.۸ گیگابایت.
- مینیپیسی (۱۲۸ گیگابایت رم): کل مدل در حافظه جای میگیرد تا حداکثر توان عملیاتی حاصل شود و از صفحهبندی دیسک (Disk paging) جلوگیری شود.
- لپتاپ (RTX 5060, 32GB RAM): سرعت ۴.۱۷ توکن در ثانیه. به دلیل اینکه VRAM ۸ گیگابایتی تنها میتواند بخشی از لایهها را نگه دارد، بیشتر فشار روی CPU و رم است و مدل به شدت به سرعت صفحهبندی سیستمعامل از یک SSD NVMe وابسته است.
در محک SuperGPQA که ۱۰۰۰ سؤال سطح تحصیلات تکمیلی در علوم را میسنجد (سؤالاتی که هرگز در آموزش استفاده نشدهاند)، نسخه POCKET امتیاز ۶۱.۵۵٪ را کسب کرد که ۲.۴۵ واحد بیشتر از مدل ۴ بیتی پایه (۵۹.۱۰٪) است. این افزایش ۲.۴۵ واحدی از نظر آماری معنادار بود. علاوه بر این، نسخه POCKET حدود ۱۳٪ توکن کمتری برای هر سؤال مصرف کرد؛ این موضوع نشان میدهد که آموزش خودبهبودی به مدل یاد داده است که بهجای استدلال مجدد و طولانی، مستقیماً روی پاسخ متعهد شود.
الزامات استقرار
برای بازتولید این نتایج، کاربران به نسخه جدید llama.cpp (b11048 یا بالاتر) و چهار تکه فایل GGUF به مجموع ۱۱۱ گیگابایت نیاز دارند. این فرآیند کاملاً محلی است و نیازی به حساب ابری یا درایورهای پیچیده GPU برای مسیر پردازش CPU ندارد.
مراحل اجرا:
- Build: کلون کردن مخزن llama.cpp و بیلد با CMake در حالت Release.
- Download: دریافت چهار تکه فایل از مسیر
FINAL-Bench/POCKET-Darwin-180B-GGUFدر Hugging Face یا ModelScope. - Execute: اجرا از طریق
llama-cliبا فلگ-mبرای مدل،-t 16برای رشتهها و-c 8192برای پنجره متنی (Context).
کاربران باید تعداد رشتهها (-t) را دقیقاً با هستههای فیزیکی CPU خود تطبیق دهند، زیرا تخصیص بیش از حد رشتهها (Oversubscribing) معمولاً سرعت تولید را کاهش میدهد. همچنین افزایش طول زمینه (-c) باعث افزایش فضای اشغالشده توسط KV Cache در کنار وزنها میشود که نیازمند رم در دسترس بیشتری است. این نیاز به حافظه در مقایسه با چالشهای تنظیم دقیق مدلهای کوچکتر که حتی برای مدلهای ۷ میلیاردی به رمهای حجیم نیاز دارند، در حالت استنتاج بهینهتر شده است.
چرخش به سمت حاکمیت دادهها
این پیشرفت بحث را از «توان عملیاتی خام» به «حاکمیت دادهها» تغییر میدهد. اگرچه ۴ توکن در ثانیه برای یک محصول چت تجاری کند است، اما برای محیطهای ایزوله (Air-gapped) یک پیروزی بزرگ است.
در بخشهای دفاعی، مالی یا زیرساختهای دولتی، توانایی اجرای یک مدل ۱۸۰ میلیاردی روی یک باکس محلی بدون اتصال به اینترنت، یک امتیاز نیست، بلکه تنها سیاست امنیتی پذیرفتنی است. هوش مصنوعی لبه اکنون کمتر درباره میلیثانیهها و بیشتر درباره این است که بایتها کجا اجازه اقامت دارند.
اگر در محیطی امن فعالیت میکنید، پذیرفتن سرعت کمتر در برابر حریم خصوصی اکنون یک واقعیت کاربردی است. گلوگاه از VRAM گرافیک به سرعت صفحهبندی SSD منتقل شده است. برای کارهای دستهای (Batch jobs)، پیشنویسها یا گامهای عاملمحور (Agent steps) که تأخیر را تحمل میکنند، یک CPU سرور با سرعت ۲۱ توکن در ثانیه، جایگزینی بسیار بهینه برای ابر است.
گام بعدی شما
- اگر لپتاپی با رم بالای ۳۲ گیگابایت و SSD سریع دارید، بیلد GGUF را برای تست کارهای آفلاین دانلود کنید.
- تعداد رشتههای پردازشی را با هستههای فیزیکی CPU خود تطبیق دهید تا از افت سرعت جلوگیری کنید.
- برای کاربردهای حساس امنیتی، مدل را در محیط ایزوله تست کنید تا تفاوت تأخیر در مقابل حریم خصوصی را بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو