تصور کنید در یک پیکنیک خانوادگی یا یک مهمانی تولد هستید و تنها چیزی که برای مدیریت بازیهای گروهی نیاز دارید، گوشی هوشمندی است که به تنه درختی یا یک کولهپشتی تکیه داده شده و با دقت یک داور حرفهای، خطاهای بازیکنان را میگیرد. پروژه Simon Sees دقیقاً همین تجربه را خلق میکند تا بازیکنان بهجای خیره شدن به صفحه نمایش، روی هیجان بازی، خندهها و تعادل روی یک پا تمرکز کنند.
این پروژه که به عنوان بخشی از چالش هوش مصنوعی متنباز Hacktoberfest منتشر شد، نیاز به داور انسانی را از بین میبرد. این سیستم از یک خط لوله (Pipeline) از مدلهای وزنهای باز (Open Weights) — یعنی مدلهایی که ساختار داخلی و پارامترهایشان علناً منتشر شده — برای نظارت لحظهای بر بازیکنان در فضای باز به کار میگیرد. هدف اصلی این است که مشکلی رایج در بازیهای محیطی حل شود: این بازیها اغلب نه به دلیل قوانین، بلکه به این دلیل تمام میشوند که مردم حوصلهشان سر میرود و شروع به چک کردن گوشیهایشان میکنند. بازی زمانی به پایان میرسد که یک نفر گوشیاش را چک کند، سپس نفر دوم، و در نهایت دایرهای از مردم روی چمن به ردیفی از افرادی تبدیل شود که سرشان پایین است. در Simon Sees، گوشی سختترین نقش بازی، یعنی داوری را بر عهده میگیرد تا بقیه بتوانند در بازی بمانند.
زمینه: تحلیل میدان بازی
پیش از شروع ساخت، توسعهدهنده فضای موجود اپلیکیشنهای هوش مصنوعی برای فضای باز را تحلیل کرد. در تاریخ ۸ اکتبر، ۳۲۱ اثر معتبر برای هفته اول این چالش ثبت شده بود که ۱۳۰ مورد از آنها مربوط به جستجوهای محیطی، ماموریتها، بازیهای گنجیابی یا بازیهای گروهی بود.
تقریباً تمام این پروژهها برای یک کاربر واحد طراحی شده بودند؛ به این صورت که کاربر به مکانی میرود، عکسی میگیرد و هوش مصنوعی بعد از آن اتفاق، عکس را قضاوت میکند. توسعهدهنده متوجه شد هیچ پروژهای وجود ندارد که گروهی از مردم را در حال بازی با یکدیگر بهصورت زنده تماشا کند. Simon Sees این شکاف را پر کرد و سناریویی ساخت که در آن گوشی به یک تنه درخت تکیه میدهد و هیچکس تا زمان مشخص شدن برنده، به صفحه نمایش نگاه نمیکند. این رویکرد در واقع پاسخی به چالشهای ساخت اپلیکیشنهای چندنفره با هوش مصنوعی است که معمولاً پیچیدگیهای فنی بالایی در مدیریت تعاملات زنده دارند.
این سیستم بر اساس فلسفه «اول محلی» (Local-first AI) ساخته شده است — مشابه آنچه پیشتر در مورد استفاده Babu از تقطیر پرامپت (Prompt Distillation) برای گوشیهای ارزانقیمت بررسی کردیم. این رویکرد تضمین میکند که لحظات خصوصی یک مهمانی یا پیکنیک مجبور نباشند به ابرهای بسته و خصوصی شرکتهای بزرگ استریم شوند.
گیمپلی و تجربه کاربری
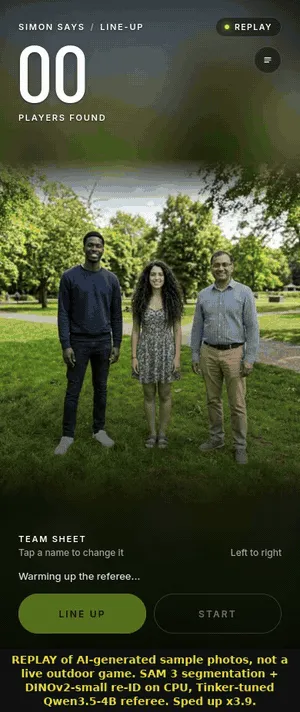
طراحی بازی بهگونهای است که نیاز به دخالت دستی نداشته باشد. پس از تکیه دادن گوشی، بازیکنان در یک ردیف میایستند و دکمه "Line up" را میزنند. گوشی برای هر شخص یک کارت عکس نمایش میدهد که از چپ به راست شمارهگذاری شده است. در این مرحله، کاربر میتواند با استفاده از faster-whisper نام هر شخص را تایپ کند یا بهصورت صوتی بگوید.
به محض شروع بازی، دیگر نیازی به صفحه نمایش نیست. یک صدا مدیریت بازی را بر عهده میگیرد و دستوراتی مانند «سایمون میگوید روی یک پا بایستید»، «چیزی سبز را لمس کنید»، «ثابت بمانید» یا گاهی اوقات فقط «دستها روی سر!» (بدون پیشوند سایمون میگوید) صادر میکند. سیستم جریان ویدئویی را پردازش کرده و حذفشدگان را اعلام میکند: «شماره ۲، سایمون نگفت! شما حذف شدید». تجربه نهایی بازی با صداها، خندهها و تلوتلو خوردن مردم روی یک پا تعریف میشود، نه خیره شدن به یک دستگاه.
برای کسانی که سیستم را تست میکنند، یک دموی بازپخش وجود دارد که در آن صفحه گوشی با ابعاد ۳۹۰×۸۴۴ روی عکسهای نمونه تولید شده توسط هوش مصنوعی اجرا میشود. در یکی از راندها («سایمون میگوید دستهایتان را روی سر بگذارید»)، مدل داور تنظیمشده احتمالات P = 0.00، 0.995 و 0.00 را به سه بازیکن اختصاص داد و بهدرستی بازیکن وسط را بهعنوان برنده شناسایی کرد.
خط لوله فنی: قطعهبندی، جاسازی و تطبیق
این سیستم صرفاً به ویدئو «نگاه» نمیکند، بلکه یک فرآیند سختگیرانه سهمرحلهای را دنبال میکند تا دقیقاً بداند هر کس کیست، حتی اگر بازیکنان جای خود را عوض کنند. این الگو از کارهای مزیار پناهی با استفاده از DINOv3 و SAM 3.1 برای تبدیل سینیهای جراحی به موتورهای جستجوی بصری الهام گرفته شده است.
- ثبتنام (Enrolment): در طول صف اولیه، سیستم از SAM 3 (Segment Anything Model 3) برای یافتن هر شخص در کادر بر اساس پرامپت "person" استفاده میکند. هر ماسک ایجاد شده به یک کارت عکس تبدیل میشود. این برشهای ماسکشده با DINOv3 (یا DINOv2-small به عنوان جایگزین) جاسازی (Embed) میشوند و یک «اثر انگشت بصری» یا بردار منحصربهفرد برای هر بازیکن ایجاد میکنند.
- قطعهبندی (Segmentation): در هر راند، SAM 3 همه افراد را در فریم جدید مییابد. در تستهای CPU روی یک محیط sandbox با ۲ پردازنده مجازی (2-vCPU)، مدل SAM 3 (در ابعاد ۵۶۰ پیکسل) در ۷ مورد از ۷ فریم بهدرستی تعداد افراد را تشخیص داد، هرچند میانگین زمان پردازش ۱۶.۶ ثانیه برای هر فریم بود؛ سرعتی که برای تست مناسب است اما برای بازی زنده به GPU یا مک نیاز دارد.
- تطبیق بردارها (Embedding Match): برش هر شخص با گالری بازیکنان (بردار صف اولیه بهعلاوه مشاهدات مطمئن) مقایسه میشود. یک الگوریتم تخصیص مجارستانی (Hungarian assignment) بازیکنان و افراد را یکبهیک جفت میکند. شناسایی مجدد در ۵ مورد از ۶ فریم موفق بود، حتی زمانی که بازیکنان جای خود را عوض کردند (شباهت کسینوسی ۰.۹۴ تا ۰.۹۶). اگر تطبیق به زیر یک حد آستانه برسد — مثلاً بازیکنی که در حالت اسکوات عمیق است و امتیاز ۰.۳۰ میگیرد — بازیکن بهجای حذف شدن، به عنوان «دیده نشده» علامتگذاری شده و یک هشدار دریافت میکند.
داور: تنظیم دقیق برای دقت بالا
هسته اصلی بازی «داور» است؛ مدلی که وظیفه دارد به یک سؤال ساده بله/خیر پاسخ دهد: «به شخص در این عکس نگاه کن. آیا این شخص روی یک پا ایستاده است؟»
در ابتدا، توسعهدهنده سعی کرد بازیکنان را از روی لباس (مثلاً «پیراهن قرمز») شناسایی کند. اما تستها این رویکرد را رد کردند؛ مدل تصمیمگیرنده کوچک به هر سؤال مربوط به لباس پاسخ «نه» میداد، حتی وقتی شخص کاملاً قابل مشاهده بود، هرچند به سؤال «آیا شخصی وجود دارد؟» هر بار پاسخ مثبت میداد.
برای حل این مشکل، توسعهدهنده مدل Qwen3.5-4B را با استفاده از Tinker تنظیم دقیق (Fine-tune) کرد. با اعمال یک LoRA (تطبیق رتبه پایین) با رتبه ۳۲، مدل روی مجموعهدادهای مشتق شده از نقاط کلیدی بدن COCO 2017 (تحت لایسنس CC BY 4.0) آموزش دید. این تلاش برای افزایش دقت داوری، یادآور تحلیلاتی است که نشان میدهد بسیاری از نوسانات در امتیازدهی پروژهها بیش از آنکه ناشی از سوگیری باشد، به دلیل نویزهای تصادفی و عدم دقت در تشخیص است.
مکانیسمهای آموزش و دادهها
برای جلوگیری از برچسبگذاری دستی هزاران عکس، توسعهدهنده از قوانین هندسی صریح استفاده کرد تا ۱۷ نقطه کلیدی COCO را به برچسب تبدیل کند. برای مثال، اگر هر دو مچ دست ۰.۳ برابر طول تنه بالاتر از بینی باشند و بازوها صاف باشند، برچسب «دستها رو به آسمان» زده میشود.
- پاکسازی برچسبها: یک مدل Qwen3.6-35B-A3B تنظیمنشده روی Tinker به عنوان «معلم» عمل کرد و برچسبها را پاکسازی کرد. یک نمونه آموزشی/اعتبارسنجی تنها زمانی نگه داشته میشد که معلم با قانون هندسی موافق باشد.
- مجموعه تست: مجموعه تست کاملاً خالص باقی ماند و هرگز با قوانین یا معلم در تماس نبود. از میان ۲۶۲ برش کاندید، توسعهدهنده ۱۵ برچسب را تغییر داد و ۴۰ مورد را حذف کرد، که در نهایت ۲۲۲ برش تست از ۲۱۰ عکس که هرگز در آموزش استفاده نشده بودند، باقی ماند.
- مدیریت موارد نزدیک به خطا (Near-Misses): اولین اجرای آموزش روی دادههای اعتبارسنجی به ۱۰۰٪ رسید اما در مجموعه تست دچار مشکل شد. خطاها شامل اسکیتبوردسواران در حالت خمیده یا بازیکنان بیسبال در حال سر خوردن روی بیس بودند که بهاشتباه «لمس انگشتان پا» تشخیص داده میشدند. برای رفع این مشکل، توسعهدهنده ۷۲۰ نمونه منفی «نزدیک به خطا» استخراج کرد (مثلاً لگن در ارتفاع مچ پا اما بدون اسکوات، یا بلند شدن مچ پا در حالی که بدن مایل است)، نرخ یادگیری را نصف کرد و بهجای ۳ اپوک، برای ۲ اپوک آموزش داد.
- محدودیتهای داده: برخی ژستها دشوار باقی ماندند. «پوشاندن دهان» و «دست تکان دادن» حذف شدند زیرا دادههای COCO اغلب اینها را با تماس تلفنی یا ضربات تنیس اشتباه میگرفت. «دستهای بالا» (Arms_up) نیز بهبود کمی داشت و خطاها برای افرادی که در حال پرش بودند، ادامه یافت.
عملکرد و بنچمارکها
طبق گزارش dev.to، تنظیم دقیق منجر به جهش قابل توجهی در قابلیت اطمینان شد. نتایج روی ۲۲۲ برش بررسیشده به شرح زیر است:
- d1-omni-600M (پایه): ۶۳.۱٪ دقت (Macro-F1: 0.629)، ۶۵ مورد تشخیص غلط «انجام داد»، ۱۷ مورد نادیده گرفته شده.
- Qwen3.5-4B (تنظیمنشده): ۸۷.۴٪ دقت (Macro-F1: 0.871)، ۲۷ مورد تشخیص غلط «انجام داد»، ۱ مورد نادیده گرفته شده.
- Qwen3.6-35B-A3B (تنظیمنشده): ۸۸.۷٪ دقت (Macro-F1: 0.882)، ۱۹ مورد تشخیص غلط «انجام داد»، ۶ مورد نادیده گرفته شده.
- Qwen3.5-4B + LoRA (تنظیمشده): ۹۳.۲٪ دقت (Macro-F1: 0.928)، ۹ مورد تشخیص غلط «انجام داد»، ۶ مورد نادیده گرفته شده.
این تنظیم دقیق، تشخیصهای غلط «انجام داد» را از ۲۷ مورد به ۹ مورد کاهش داد. مدل ۴ میلیارد پارامتری تنظیمشده، از مدل بسیار بزرگتر Qwen3.6-35B-A3B (که حدود ۹ برابر پارامتر دارد) عملکرد بهتری داشت (با فاصله اطمینان ۹۵٪ بوتاسترپ بین ۸۹.۶ تا ۹۶.۴٪ و p-value مکنمار ۰.۰۱۹ در برابر مدل ۴ میلیارد تنظیمنشده). در برابر مدل ۳۵ میلیارد پارامتری، این مدل جلوتر است اما تفاوت از نظر آماری بسیار چشمگیر نیست (p = 0.08).
اجرای محلی و حریم خصوصی
حریم خصوصی یکی از ستونهای اصلی معماری است. چون سیستم از وزنهای باز استفاده میکند، میتواند در دو حالت اجرا شود:
۱. حالت Tinker: برشهای کمکیفیت بازیکنان را برای دریافت پاسخ بله/خیر به یک مدل کنترلشده ارسال میکند. هزینه یک بازی ۱۰ راندی برای ۶ دوست کمتر از نیم سنت (۰.۰۰۰۰۶ دلار برای هر برش) است. هزینه کل آموزش و ارزیابی حدود ۲ دلار بود. هر فراخوانی دستهای Tinker در هر راند حدود ۲.۹ ثانیه از محیط sandbox زمان میبرد (تقریباً ۴۸۰ میلیثانیه برای هر برش با ۶ بازیکن).
۲. حالت کاملاً محلی: از d1 شرکت Liquid AI استفاده میکند که یک مدل تصمیمگیرنده با وزنهای باز است. برخلاف چتباتها، d1 احتمالات کالیبره شده را در یک گذر مستقیم (Forward Pass) بدون تولید توکن برمیگرداند. این موضوع برای دستور «ثابت بمانید» (Freeze) حیاتی است، جایی که d1 برشهای «قبل» و «بعد» را مقایسه میکند تا ببیند آیا شخص حرکت کرده است یا خیر. در تستها، یک VLM مولد (LFM2.5-VL-450M) بهاشتباه ادعا کرد که شخص حرکت کرده است در حالی که همان عکس دو بار به او نشان داده شده بود (۲ از ۲)، اما d1 بهدرستی پاسخ داد که حرکت نکرده است (۲ از ۲). این توانایی در اجرای مدلهای تصمیمگیرنده روی سختافزار محدود، مشابه استراتژیهای بهینهسازی در مدیریت چندین عامل هوش مصنوعی روی موبایل است تا تأخیر به حداقل برسد.
برای صدا، سیستم از Kokoro-82M (تحت لایسنس Apache-2.0) برای صدای سایمون و faster-whisper برای پردازش نام بازیکنان در هنگام راهاندازی استفاده میکند. رابط کاربری یک صفحه JS ساده است که حدود سه فریم بر ثانیه را از طریق WebSockets استریم میکند. مدل d1-omni-600M روی CPU حدود ۲.۷ ثانیه برای هر بازیکن زمان میبرد، به این معنی که یک راند ۶ نفره ۱۶.۵ ثانیه طول میکشد.
قوانین بازی
موتور بازی با پایتون ساده و یک تابع خالص judge() نوشته شده است. قوانین بهگونهای طراحی شدهاند که تقلیدی از یک داور انسانی منصف باشند:
- آستانهها: اگر سایمون دستور داده باشد و احتمال انجام حرکت P(did it) < 0.35 باشد، بازیکن حذف میشود. اگر سایمون دستور نداده باشد و احتمال انجام حرکت P(did it) > 0.65 باشد، بازیکن حذف میشود. مقادیر بین این دو بازه، به نفع بازیکن تفسیر میشوند.
- قانون زمین بازی: در راندهای فریبنده هرگز از دستور «ثابت بمانید» استفاده نمیشود (چون همه از قبل ثابت هستند). اگر همه بازیکنان بهطور همزمان حذف شوند، آن راند محاسبه نمیشود. در راند اول هیچ ترفندی وجود ندارد تا بازیکنان با ریتم بازی آشنا شوند.
- حلقه بازخورد: هر تصمیم در فایل
decisions.jsonlثبت میشود، شامل سؤال، احتمالات هر فریم، تأخیر در هر مرحله و حکم نهایی. بازیکنان میتوانند دکمه "Wrong call" (تصمیم غلط) را بزنند و توسعهدهنده میتواند این جلسات را در یک مجموعهداده خصوصی Hugging Face آپلود کند تا ردیفهای آموزشی برای تنظیم دقیق بعدی ایجاد کند.
تحلیل: چرخش به سمت SLMهای تخصصی
پروژه Simon Sees نشاندهنده یک تغییر حیاتی در هوش مصنوعی کاربردی است: حرکت از مدلهای غولپیکر «یک اندازه برای همه» به سمت مدلهای زبانی کوچک تخصصی (SLMs). یک VLM همهمنظوره ممکن است صحنه را بهزیبایی توصیف کند، اما اغلب در دقت باینری (بله/خیر) مورد نیاز برای یک داور شکست میخورد.
با ترکیب یک مدل قطعهبندی (SAM)، یک مدل جاسازی (DINO) و یک مدل تصمیمگیرنده تنظیمشده (Qwen)، توسعهدهنده سیستمی ساخت که قابلاعتمادتر از مدلی با ۹ برابر اندازه آن است. این رویکرد اجازه میدهد بازی در پارکهایی بدون سیگنال، تنها با استفاده از هاتاسپات یک لپتاپ اجرا شود و از خطرات تأخیر و حریم خصوصی APIهای بسته جلوگیری کند.
لایسنس و متنباز بودن
این پروژه بر نوآوری باز تأکید دارد. کد پروژه تحت لایسنس MIT است و Qwen3.5-4B تحت Apache-2.0 منتشر شده است. مدل d1 شرکت Liquid تحت LFM Open License v1.0 است که استفاده و تغییر رایگان را برای شرکتهایی با درآمد سالانه زیر ۱۰ میلیون دلار مجاز میداند. اگرچه SAM 3 و DINOv3 تحت لایسنسهای متا هستند، اما استفاده از وزنهای باز به این معنی است که داور را میتوان از طریق export_referee.py به «خانه» برد تا هرگونه وابستگی به ابر حذف شود.
گام بعدی شما
شما میتوانید پیادهسازی کامل و کد MIT-licensed را در مخزن گیتهاب پروژه در github.com/nice-bills/simon-sees بررسی کنید. همچنین میتوانید حالت بازپخش دسکتاپ را با دستور python -m simon_sees serve --replay my_clip.mp4 روی سیستم خود اجرا کنید و ببینید چگونه ترکیب مدلهای کوچک تخصصی میتواند جایگزین مدلهای غولپیکر در کاربردهای Real-time شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو