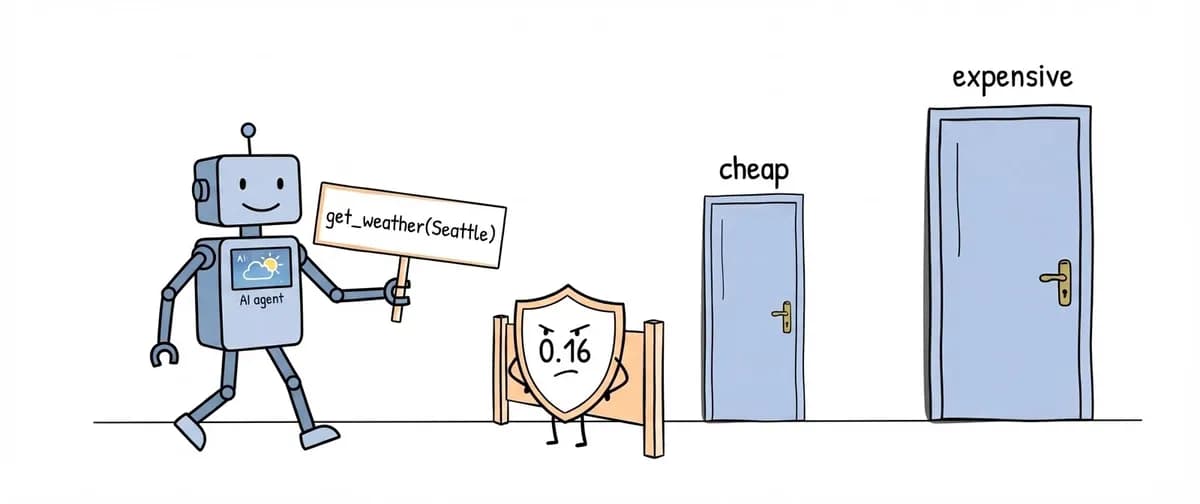
تصور کنید یک برنامهنویس در حال ساخت عاملی است که باید وضعیت آبوهوا را چک کند، اما مدل بهجای پرسیدن شهر از کاربر، از خودش شهر «سیتل» را میسازد و API را فراخوانی میکند. در ۴ اکتبر ۲۰۲۶، یک بررسی فنی عمیق فاش کرد که مدل Strands Decider 2B محصول AWS چگونه به عنوان یک نرده ایمنی (Guardrail) سریع عمل میکند تا از این توهمات جلوگیری کند.
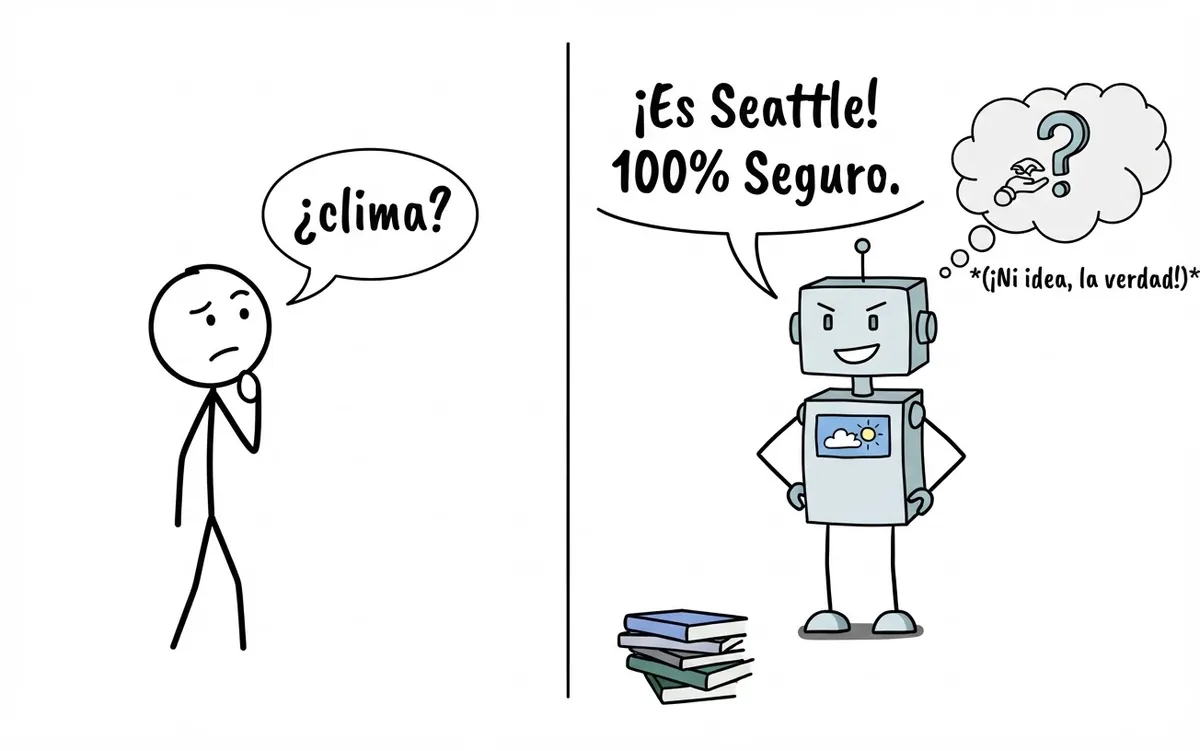
این مدل در واقع یک لایه تصمیمگیر است که اجازه نمیدهد عاملهای «عجول»، دادههای ساختگی برای پر کردن آرگومانهای ابزارها ابداع کنند. همانطور که در تحلیل قبلی ما دربارهی کاهش تأخیر در مدلهای تصمیمگیر اشاره کردیم، تمرکز این پیادهسازی بر مکانیزم «دروازهای» است. اکثر عاملهای هوش مصنوعی از یک نقص مشترک رنج میبرند: وقتی پرامپت به یک آرگومان خاص نیاز دارد — مثلاً نام یک شهر برای ابزار آبوهوا — مدل اغلب مقداری محتمل را حدس میزند، مانند «سیتل»، حتی اگر کاربر هرگز به آن اشاره نکرده باشد. برای مثال، کاربری که صرفاً میپرسد «آبوهوا چطور است؟» ممکن است باعث شود عامل دستور get_weather(location="Seattle") را اجرا کند، صرفاً چون مدل بیش از حد میخواهد «مفید» باشد و شکاف اطلاعاتی را با یک فرض پر میکند.
این اتفاق به این دلیل رخ میدهد که مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — برای تولید محتملترین توکن بعدی آموزش دیدهاند، نه برای تأیید اینکه آیا آن توکن بر اساس واقعیتهای ارائه شده است یا خیر. در چرخه استاندارد پردازش، هیچ بخشی نمیپرسد: «آیا این مقادیر آرگومانها واقعاً بر اساس گفتههای کاربر هستند؟». طبق گزارش وبسایت dev.to، درخواست از یک LLM برای بازبینی خروجی خودش معمولاً بیفایده است؛ شبیه به این است که از دانشآموزی بخواهید برگه امتحان خودش را تصحیح کند، زیرا مدل ممکن است بهسادگی خودش را متقاعد کند که پاسخ درست است.
مکانیزم «سیستم یک»
مدل Strands Decider 2B یک مدل زبانی مولد نیست، بلکه یک مدل تصمیمگیر است. این مدل متن نمینویسد، بلکه عددی کالیبرهشده را برمیگرداند که نشاندهنده یک احتمال است. این مدل مانند یک ممتحن خارجی عمل میکند که گفتگو و فراخوانی پیشنهادی را دریافت کرده و بهجای متنی مبهم که احتمال تفسیر اشتباه داشته باشد، یک عدد دقیق ارائه میدهد.
بر اساس مستندات فنی، این مدل سه نوع پرسش را در یک مرحله پردازش (Forward Pass) مدیریت میکند:
- noul: احتمالی بین ۰ تا ۱ برای پرسشهای بله/خیر. مثال: «آیا آرگومانهای ابزار بر اساس واقعیتهایی است که کاربر واقعاً ارائه داده است؟»
- choice: انتخاب یکی از N گزینه نامگذاری شده همراه با امتیاز اطمینان. مثال: «آیا این درخواست مربوط به بخش صورتحساب، فروش یا خردهفروشی است؟»
- score: تخصیص امتیاز بر اساس یک معیار رتبهبندی شده. مثال: سنجش میزان عصبانیت کاربر در مقیاس «آرام/عصبانی/افسرده».
جزئیات پیادهسازی فنی
برای استقرار محلی این مدل، توسعهدهندگان از CLI و یک سرور استفاده میکنند. در سختافزارهای اپل سیلیکون، نصب افزونه mlx با دستور pip install "strands-decider[mlx]" عملکرد را بهطور قابل توجهی افزایش میدهد. سرور با دستور strands-decider serve StrandsAgents/strands-decider-2B-hobson-v19 --port 8099 اجرا شده و یک نقطه اتصال (Endpoint) تحت POST /v1/systemone ایجاد میکند.
توسعهدهندگان میتوانند با دستور ask نصب را تأیید کنند. برای مثال، با ارسال وضعیتی که در آن کاربر وضعیت آبوهوا را میخواهد اما دستیار قصد دارد get_weather(location='Seattle') را فراخوانی کند، توسعهدهنده میتواند دو پرسش noul را تست کند: «آیا مقادیر آرگومانهای ابزار بر اساس واقعیتهایی است که کاربر ارائه داده؟» و «آیا فراخوانی این ابزار در این لحظه، پیش از شفافسازی با کاربر، زودتر از موعد است؟»
در یک سناریوی آزمایشی، مدل برای مورد اول (مبنیسازی) امتیاز noul_0 = 0.285 و برای مورد دوم (زودتر-از-موعد بودن) امتیاز noul_1 = 0.740 را برگرداند. این نتایج نشان میدهد که مدل با اطمینان بالا تشخیص داده است که آرگومانها مبنایی ندارند و فراخوانی ابزار در این لحظه واقعاً زودتر از موعد است.
نرده ایمنی فراخوانی ابزار
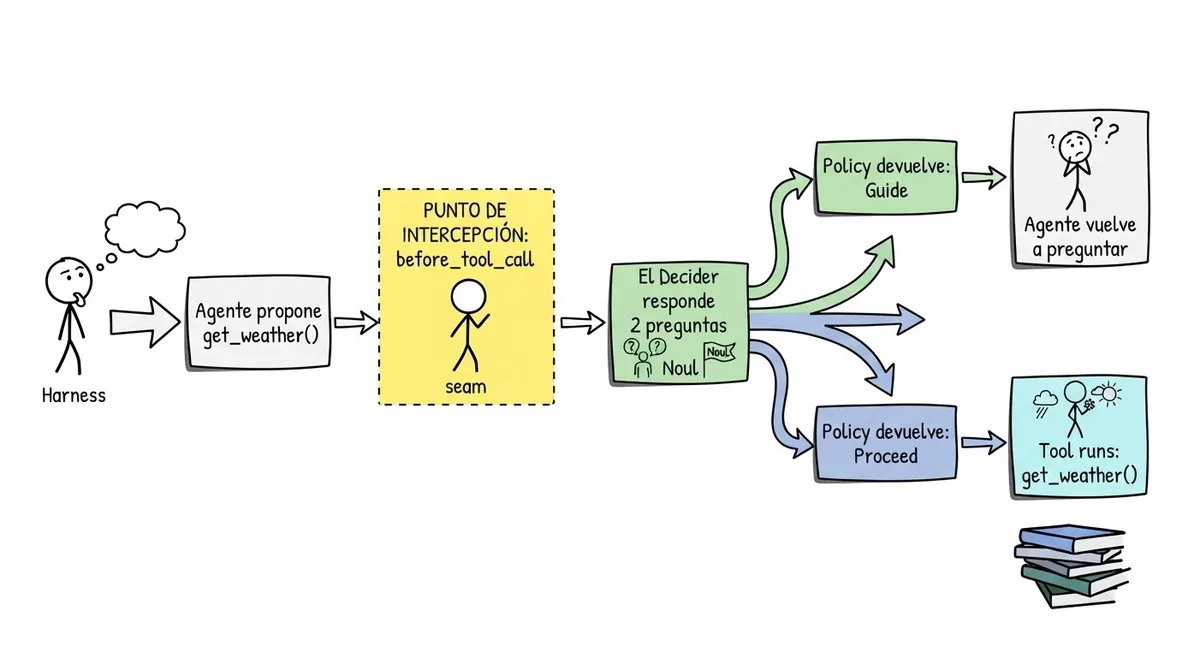
برای جلوگیری از توهم (Hallucination) — وقتی مدل با اطمینان چیزی میگوید که اصلاً وجود ندارد، مثل دوستی که خاطرهای را اشتباه تعریف میکند — این تصمیمگیر در یک هندلر مداخلهای به نام before_tool_call قرار میگیرد. وقتی یک عامل پیشنهاد فراخوانی ابزاری را میدهد، تصمیمگیر وضعیت گفتگو و آرگومانهای پیشنهادی را تحلیل میکند. این رویکرد در واقع تکامل یافتهی همان منطقی است که عاملهای هوش مصنوعی را قادر ساخت تا مدیریت منابع SaaS را از اسکریپتهای ایستا خارج کنند و عملیات پیچیده را خودکار سازند.
- منطق: سیستم از یک آستانه سیاست (مثلاً
YES = 0.45) استفاده میکند. این یک ویژگی در سطح کد است و نه یک ویژگی ذاتی مدل. - بررسی: دو پرسش
noulمشخص پرسیده میشود: «آیا آرگومانها مبنی (Grounded) هستند؟» و «آیا فراخوانی این ابزار اکنون زودتر از موعد است؟» - نتیجه: اگر امتیاز مبنیسازی زیر ۰.۴۵ یا امتیاز زودتر-از-موعد بودن بالای ۰.۴۵ باشد، سیستم مداخله میکند.
اگر تصمیمگیر امتیاز اطمینان پایینی برای مبنیسازی برگرداند، سیستم بهجای پاسخ «رد کردن» (Deny)، یک پاسخ «راهنما» (Guide) صادر میکند. این دستور به عامل میگوید بهجای مسدود کردن کامل فرآیند، به سراغ کاربر برود و اطلاعات ناقص را بپرسد. در یک تست واقعی با استفاده از مدل us.anthropic.claude-haiku-4-5-20251001-v1:0، امتیاز مبنیسازی ۰.۱۶ بهدرستی تشخیص داد که شهر «سیتل» ابداعی است و عامل را هدایت کرد تا شهر را از کاربر بپرسد.
عملکرد محلی و تأخیر
اجرای مدل روی اپل سیلیکون با mlx سرعت را بهشدت بالا میبرد، اما اندازهگیری تأخیر (Latency) — یعنی زمان انتظار برای دریافت پاسخ — تفاوتهای فنی مهمی دارد:
- راهاندازی سرد (Cold Start): اولین درخواست روی مک M3 از طریق MPS ممکن است ۱۰۷۲ میلیثانیه طول بکشد. این به دلیل یک عملیات یکباره «کامپایل شکل MPS» (MPS shape-compile) است که در اولین درخواست برای یک طول ورودی خاص رخ میدهد. کلاینت رسمی صراحتاً درباره این رفتار هشدار میدهد.
- استنتاج گرم (Hot Inference): پس از گرم شدن، زمان پاسخ زیر یک ثانیه است. بنچمارکهای رسمی پروژه برای نسخه v19، تأخیر p50 را حدود ۱۱۵ میلیثانیه روی RTX 3090 و ۱۵۳ میلیثانیه روی M3 Pro گزارش کردهاند.
- اشتباه رایج در اندازهگیری: استفاده از زیر-دستور
askزمان بوت را گزارش میدهد زیرا مدل را برای هر فراخوانی مجدداً بارگذاری میکند؛ تأخیر واقعی باید در مقابل فرآیند فعال و طولانیمدتserveاندازهگیری شود.
علاوه بر این، توسعهدهندگان باید توجه کنند که اگر causal_conv1d نصب نشده باشد، سیستم به پیادهسازی مرجع PyTorch بازمیگردد. این کار بیضرر است اما سرعت کمتری دارد؛ نصب causal_conv1d هسته (Kernel) بهینهشده را فراهم میکند.
کاهش هزینه از طریق مسیریابی مدل
علاوه بر حفاظها، این مدل به عنوان یک مسیریاب (Router) عمل میکند تا پرسشهای پیشپاافتاده را از موارد پیچیده جدا کند. با استفاده از یک بررسی noul برای پرسش «آیا این درخواست پیچیده است؟»، سیستم کارهای ساده را به یک مدل ارزان و موارد دشوار را تنها در صورت نیاز به یک مدل پیشرو (Frontier) میسپارد.
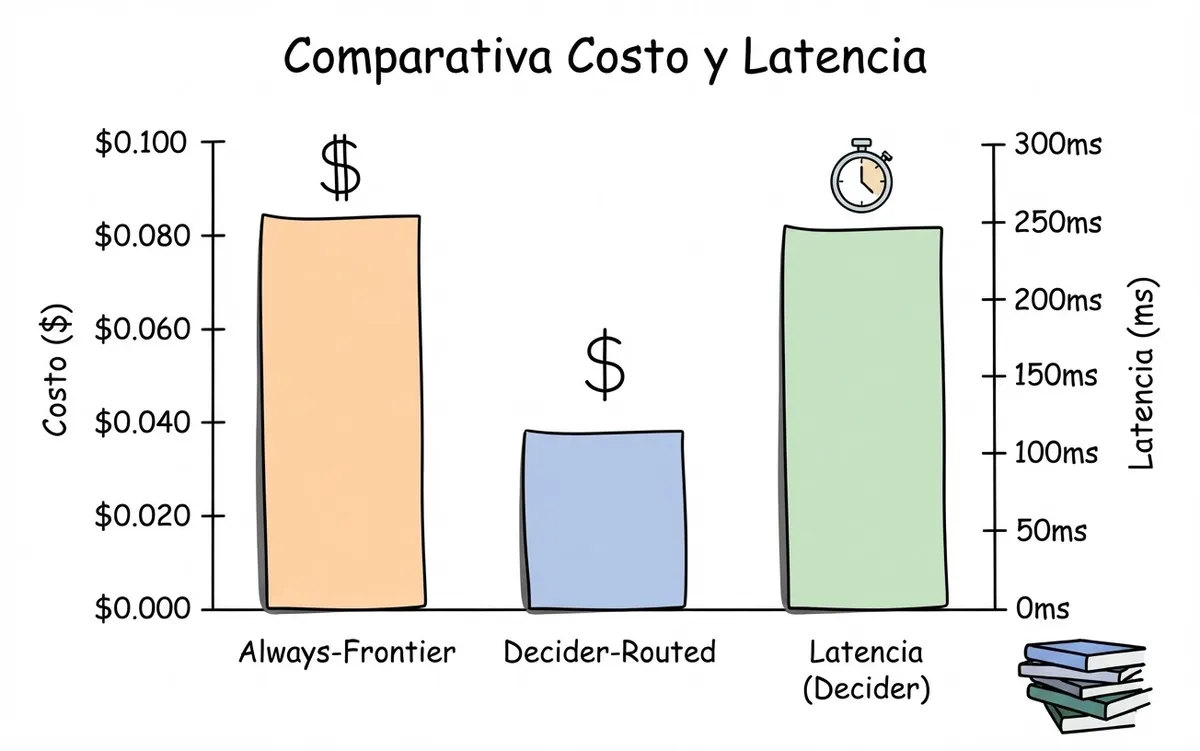
در یک مجموعه آزمایشی شامل ۱۴ پرسش برچسبگذاری شده، این مسیریابی در مقایسه با استانداردهای طلایی (Gold Standards) به صحت ۱۰۰٪ (۱۴ از ۱۴) رسید. بر اساس قیمتهای نمایشی Bedrock (مدل ارزان ۰.۰۰۰۵ دلار در مقابل مدل پیشرو ۰.۰۱۰۰ دلار به ازای هر ۱ هزار توکن و با فرض ۶۰۰ توکن برای هر پرسش)، اثر مالی فوری بود:
- هزینه استفاده همیشگی از مدل پیشرو: ۰.۰۸۴۰۰ دلار در هر اجرا.
- هزینه با مسیریابی Decider: ۰.۰۳۸۴۰ دلار در هر اجرا.
- صرفهجویی کل: ۵۴٪ کاهش هزینه.
موازنه راهبردی
این معماری منطق عامل را از یک LLM یکپارچه و تکسنگی (Monolithic) به یک سیستم ترکیبی تغییر میدهد. مدل تصمیمگیر منطق «اگر/آنگاه» را با اطمینان کالیبرهشده مدیریت میکند و LLM پیشرو، استدلال واقعی و تولید متن را بر عهده میگیرد.
چه زمانی از مدل تصمیمگیر استفاده کنیم؟
- برای قضاوتهای ارزان و تکراری در مسیرهای سریع (مانند تریاژ، مسیریابی یا انتخاب ابزار).
- وقتی به امتیاز اطمینان کالیبرهشده برای منطق شاخهای نیاز داریم (چیزی که APIهای پیشرو معمولاً ارائه نمیدهند).
- وقتی دادهها باید بهطور سختگیرانه محلی و روی سختافزار باقی بمانند.
چه زمانی از LLM پیشرو استفاده کنیم؟
- وقتی تصمیم نیاز به استدلال واقعی، تولید کد یا خروجی متنی دارد.
- وقتی کاربر ترجیح میدهد از راهکارهای میزبانیشده (مانند Jev) استفاده کند تا از عملیات پیچیده میزبانی شخصی دوری کند.
خلاصه مقایسهای
| ویژگی | Strands Decider 2B (محلی) | Decider میزبانیشده (Jev) | دروازه LLM پیشرو |
|---|---|---|---|
| هزینه استنتاج | ۰ دلار (سختافزار شما) | هزینه API هر فراخوانی | هزینه API (بسیار بالا) |
| امتیاز اطمینان | کالیبرهشده ✅ | کالیبرهشده ✅ | ارائه نمیشود ❌ |
| تولید متن | خیر ❌ | خیر ❌ | بله ✅ (بیش از حد) |
| محل دادهها | محلی 🏠 | شبکه 🌐 | شبکه 🌐 |
نگهداری و پاکسازی
برای پاکسازی محیط، توسعهدهندگان میتوانند سرور را با Ctrl-C متوقف کرده و محیط مجازی را با rm -rf .venv حذف کنند. از آنجایی که وزنهای مدل در کش Hugging Face (در مسیر ~/.cache/huggingface) ذخیره میشوند، برای بازیابی فضای دیسک باید این دایرکتوری خاص پاک شود.
پرسشهای متداول و نکات کلیدی
آیا مدل تصمیمگیر فقط یک طبقهبندیکننده (Classifier) است؟ خیر، این یک مدل عمومی است که نیاز به آموزش (Training) ندارد. شما برچسبها را در درخواست تعریف میکنید و احتمالات کالیبرهشده را دریافت میکنید. در حالی که طبقهبندیکنندههای سنتی پس از آموزش سریعتر هستند، اما نیاز به ساخت و نگهداری دستی دارند.
آیا میتواند چندین پرسش را مدیریت کند؟ بله. وضعیت (State) یکبار رمزگذاری میشود و هر پرسش اضافی فقط توکنهای خودش را اضافه میکند، که باعث میشود پرسیدن چندین سوال بسیار ارزانتر از ارسال چندین درخواست مجزا باشد.
آیا این حفاظ به Bedrock نیاز دارد؟ فقط بخش عامل (Agent side) نیاز دارد. دروازه (Gate) با سرور محلی ارتباط میگیرد، به این معنی که ارائهدهنده مدل میتواند بدون تأثیر بر عملکرد تصمیمگیر تغییر کند.
برای توسعهدهندگان، درس اصلی این است که «راهنمایی» (Guide) بر «رد کردن» (Deny) برتری دارد. با اصلاح مسیر عامل در زمان زیر یک ثانیه، سیستم تضمین میکند که کاربر بهجای یک پاسخ مطمئن اما غلط، یک پرسش شفافساز دریافت کند. دستیار عجول آبوهوا هرگز وضعیت آبوهوای شهری را گزارش نمیکند که کاربر نام نبرده است، زیرا یک بررسی محلی و زیر-ثانیهای، خطا را پیش از آنکه پاسخ از دستگاه خارج شود، شکار میکند.
گام بعدی شما
- اگر از عاملهای هوش مصنوعی برای فراخوانی API استفاده میکنید، یک لایه تصمیمگیر محلی برای اعتبارسنجی آرگومانها قبل از ارسال درخواست پیاده کنید.
- برای کاهش هزینههای عملیاتی، مدلهای کوچک (SLM) را به عنوان مسیریاب برای تفکیک درخواستهای ساده از پیچیده به کار بگیرید.
- در محیطهای حساس، از مدلهای تصمیمگیر محلی برای اطمینان از عدم خروج دادههای حساس به APIهای ابری استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو