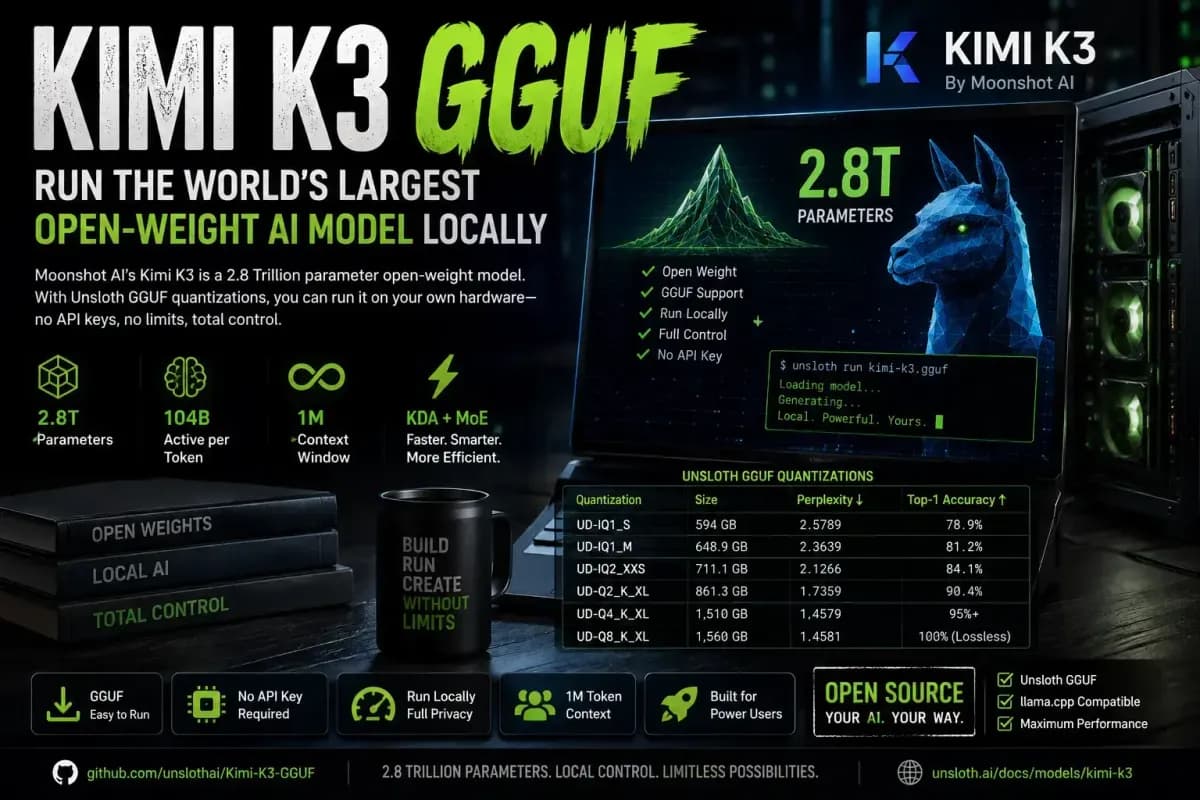
آیا توسعهدهندگان میتوانند بدون وابستگی به APIهای ابری، کنترل کامل جریانهای کاری خود را در دست بگیرند؟ اجرای محلی Kimi K3 پاسخی قطعی به این پرسش است. در ۳۱ ژوئیه ۲۰۲۶، یک راهنمای جامع منتشر شد که سازوکارهای دقیق استقرار این مدل با وزنهای باز (Open Weights) — یعنی مدلهایی که «دستور پخت» آنها علناً منتشر شده و نه فقط غذای آماده — را روی سختافزار خصوصی تشریح میکند.
استنتاج (Inference) محلی — همان لحظهای که مدل واقعاً جواب تولید میکند، شبیه به خودِ آشپزی و نه دورهی آموزش آشپز — از یک فعالیت پژوهشی خاص به یک ضرورت عملی برای تیمهای متمرکز بر حریم خصوصی تبدیل شده است. طبق گزارش منتشر شده در dev.to، کاربران میتوانند با استفاده از فرمتهای GGUF، مدلهای عظیم را روی سختافزارهای معمولی اجرا کنند؛ سختافزارهایی که در حالت عادی برای چنین مدلهایی به خوشههای سرور سازمانی نیاز داشتند.

در این راهنما، سه مسیر اصلی برای استقرار مدل معرفی شده است:
- اولاما (Ollama): ایدهآل برای راهاندازی سریع از طریق خط فرمان و سرویسدهی API.
- الام استودیو (LM Studio): بهترین گزینه برای کسانی که رابط کاربری گرافیکی (GUI) و جستوجوی آسان مدل را ترجیح میدهند.
- لاماسیپلاسپلاس (llama.cpp): استاندارد طلایی برای بهینهسازیهای سطح پایین و حداکثر بهرهوری عملکرد.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، حذف واسطههای ابری ریسک نشت دادهها را بهطور کامل از بین میبرد. با این حال، توسعهدهندگان باید مشخصات سختافزاری خود را با اندازه مدل تطبیق دهند تا دچار تأخیر شدید نشوند. بر اساس مستندات این راهنما، دستورات نصب دقیق و نکات عیبیابی برای رفع خطاهای رایج در فرآیند بارگذاری GGUF ارائه شده است.
این حرکت به سمت میزبانی محلی مدلهای با پارامتر بالا مانند Kimi K3، قدرت هوش مصنوعی را غیرمتمرکز میکند. این یعنی توانایی یک پژوهشگر برای آزمایش، دیگر توسط سهمیه ماهانه توکنهای یک ارائهدهنده یا قیمتگذاری پلکانی API محدود نمیشود.
گام بعدی شما
- ظرفیت حافظه ویدیویی (VRAM) سیستم خود را بررسی کنید.
- سطح کوانتش (Quantization) مناسبی را انتخاب کنید که تعادلی میان سرعت و هوشمندی مدل ایجاد کند.
- مستندات کامل نصب را برای شروع پیکربندی محلی مطالعه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است؛ برای درک نقش سختافزارهای جدید در این روند، به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو